Ein Problem der Evaluation, kein neuer Nachweis von Fähigkeiten
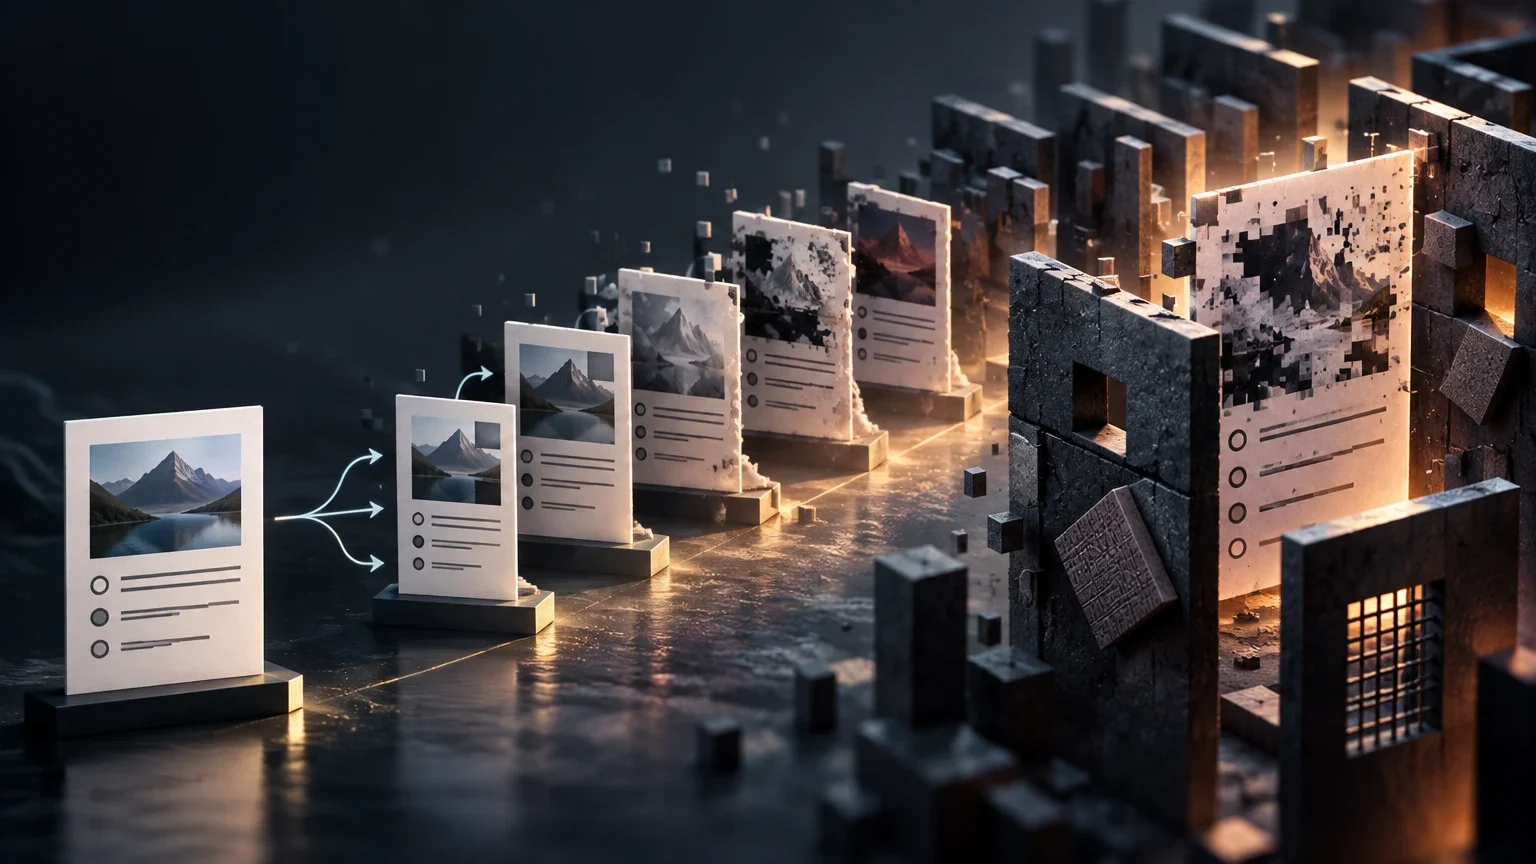
HARDEN ist ein in einem Preprint vorgestelltes Verfahren, mit dem bestimmte Evaluierungsfälle für Sprachmodelle anspruchsvoller gemacht werden sollen. Statt Aufgaben von Grund auf neu zu erstellen, setzt es bei bereits vorhandenen Fällen an und sucht nach Änderungen an deren Eingaben, aus denen schwierigere Varianten entstehen. Die erwartete Ausgabe des Systems soll dabei gleich bleiben. Das ist der zentrale Vorschlag der Autoren. Er bedeutet weder, dass ein Modell allgemeine Fähigkeiten verloren hat, noch, dass ein neuer Test für sich genommen die Leistung in sämtlichen Anwendungsbereichen besser misst.
Ausgangspunkt der Arbeit ist die Sorge, dass kuratierte Benchmarks die Komplexität von Unternehmenseinsätzen möglicherweise nicht ausreichend abbilden. So formuliert es die Zusammenfassung des Preprints. Das erläutert die Motivation der Untersuchung, doch das verfügbare Material enthält keine unabhängige Messung dazu, wie groß diese mangelnde Repräsentativität ist oder welche Arten von Einsätzen damit gemeint sind. Sie sollte daher als Prämisse der Autoren verstanden werden und nicht als ein Ergebnis, das durch die Genauigkeitszahl belegt wäre.
Wie das Verfahren den Schwierigkeitsgrad erhöhen soll
Die Zusammenfassung beschreibt HARDEN als eingeschränktes evolutionäres Suchverfahren. Das System untersucht Varianten einer Eingabe entlang domänenspezifischer Komplexitätsdimensionen und wendet dabei Bedingungen für die Zulässigkeit an. Zu den genannten Bedingungen zählen, die Semantik der Aufgabe zu bewahren, die Realitätsnähe zu erhalten und die Ausführbarkeit sicherzustellen. Auch die erwartete Antwort des jeweiligen Falls soll unverändert bleiben.
In der Praxis besteht der Ansatz also nicht einfach darin, einer Frage weitere Wörter oder Informationen hinzuzufügen. Gesucht werden vielmehr Änderungen, die eine Aufgabe schwieriger machen, ohne sie in eine andere Aufgabe zu verwandeln oder ihre Referenzantwort ungültig werden zu lassen. Die Zusammenfassung beschreibt allerdings weder die für die einzelnen Benchmarks verwendeten Komplexitätsdimensionen noch den Ablauf der Suche. Ebenso wenig erläutert sie, wie jede Bedingung überprüft wurde oder welcher Anteil der Varianten verworfen werden musste. Diese Einzelheiten lassen sich anhand der verfügbaren Informationen nicht rekonstruieren.
Der in der Zusammenfassung beschriebene Ablauf
- 01Mit einem bestehenden Evaluierungsfall und seiner erwarteten Ausgabe beginnen.
- 02Eingabevarianten entlang domänenspezifischer Komplexitätsdimensionen suchen.
- 03Zulässigkeitsbedingungen anwenden: Semantik, Realitätsnähe und Ausführbarkeit bewahren.
- 04Modelle anhand der Varianten testen, die diese Bedingungen erfüllen.
Welche Tests untersucht wurden und welche Zahlen das Preprint nennt
Laut Zusammenfassung wurden drei Datensätze untersucht: FinQA, PubMedQA und ContractNLI. Außerdem nennt sie drei Größen des Modells Qwen3.5: 35B-A3B, 122B-A10B und 397B-A17B. Die verschiedenen Aufgaben ermöglichen es, das Verfahren in mehr als einer Art von Evaluation zu betrachten. Die bereitgestellten Angaben nennen jedoch weder die Zahl der erzeugten Fälle noch die genauen verwendeten Versionen der Datensätze. Auch die Verteilung der Ergebnisse nach Aufgabe und Modell fehlt.
Als zentrale Zahl berichten die Autoren einen durchschnittlichen Rückgang der Aufgaben-Modell-Genauigkeit um 22,7 Prozent. Darüber hinaus nennen sie einen Rückgang von bis zu 49,9 Prozent gegenüber Single-Pass-Baselines, bei denen dieselben Zulässigkeitsprüfungen verwendet werden. Die Zusammenfassung klärt nicht hinreichend, ob der Durchschnitt von 22,7 Prozent eine relative Veränderung oder eine Differenz in Prozentpunkten bezeichnet. Die nötige Aufschlüsselung, um die Berechnung nachzurechnen, wird ebenfalls nicht bereitgestellt. Daher sollte man die Zahl nicht als einheitlichen Rückgang um 22,7 Prozentpunkte in jedem Test wiedergeben.
Der in der Zusammenfassung angegebene Umfang
| Element | Berichtete Angaben | Grenzen der verfügbaren Informationen |
|---|---|---|
| Benchmarks | FinQA, PubMedQA und ContractNLI | Die Zusammenfassung enthält keine nach Datensatz aufgeschlüsselten Ergebnisse. |
| Modelle | Qwen3.5 35B-A3B, 122B-A10B und 397B-A17B | Hier werden keine Einzelergebnisse nach Modellgröße angegeben. |
| Durchschnittliches Ergebnis | Ein Rückgang der Aufgaben-Modell-Genauigkeit um 22,7 Prozent | Die Formel für die Berechnung des Durchschnitts lässt sich anhand der Zusammenfassung nicht überprüfen. |
| Größter berichteter Vergleich | Bis zu 49,9 Prozent gegenüber Single-Pass-Baselines mit denselben Zulässigkeitsprüfungen | Eine Vergleichstabelle oder eine Aufschlüsselung nach Aufgabe ist hier nicht enthalten. |
Wie der Genauigkeitsrückgang zu verstehen ist
Ein schwierigerer Test kann zu geringerer Genauigkeit führen, ohne dass sich die zugrunde liegenden Fähigkeiten eines Modells verändert haben: Es genügt, dass die Eingaben komplexere Fälle erfordern. Genau diesen Effekt soll HARDEN erzeugen. Nach Darstellung des Preprints bedeutet die Zahl, dass die Modelle bei den erzeugten Varianten weniger genau waren als im von den Autoren angegebenen Vergleichsrahmen. Für sich genommen belegt sie weder, dass die Varianten realen Situationen ähnlicher sind, noch, dass ein System in einer Arbeitsumgebung mit derselben Häufigkeit scheitern würde.
Auch der Bezugspunkt des Vergleichs ist wichtig. Den Höchstwert von 49,9 Prozent ordnet die Zusammenfassung einem Vergleich mit Single-Pass-Verfahren zu, die dieselben Zulässigkeitsprüfungen anwenden. Sie besagt nicht, dass dieser Höchstwert bei allen Benchmarks oder Modellen erreicht wurde. Um die Größe der einzelnen Ergebnisse einordnen zu können, braucht es die Zahlen je Aufgabe, eine genaue Definition der Metrik und Angaben zur Aggregation. Ohne diese Details sollte man die berichtete Formulierung beibehalten und aus einem Durchschnitt oder Höchstwert keine allgemeingültige Schlussfolgerung ableiten.
Die Gültigkeit der Varianten bleibt eine zentrale offene Frage
Eine Referenzantwort beizubehalten und zugleich die Eingabe zu verändern, ist methodisch anspruchsvoll: Eine Variante kann schwieriger wirken und dennoch unbeabsichtigt die Aufgabe verändern, Mehrdeutigkeit einführen oder einen plausiblen Fall erzeugen. HARDEN nennt Bedingungen, die solche Probleme vermeiden sollen, darunter die Bewahrung der Semantik, Realitätsnähe und Ausführbarkeit. Diese Beschreibung ist relevant, ersetzt aber keine Belege dafür, wie die Prüfungen umgesetzt wurden und wie zuverlässig sie sind.
Die verfügbare Zusammenfassung sagt nicht, wer oder was die Realitätsnähe bewertet, ob eine unabhängige menschliche Prüfung stattfand, nach welchen Kriterien die fortbestehende Richtigkeit der erwarteten Antwort festgestellt wurde oder wie viele Beispiele ausgeschlossen wurden. Ebenso wenig enthält sie Belege dafür, dass die resultierenden Fälle tatsächlich Eingaben aus realen Einsätzen ähneln. Die Aussage, das Verfahren erzeuge gültige Fälle, sollte daher im Rahmen der im Paper beschriebenen Bedingungen und Evaluationen verstanden werden. Diese sind noch genauer zu untersuchen.
Offene Fragen zur Bewertung der Evidenz
| Aspekt | Angaben in der Zusammenfassung | Was überprüft werden sollte |
|---|---|---|
| Semantik und Antwort | Als Bedingungen für die Zulässigkeit genannt. | Das Prüfverfahren und Beispiele, die begutachtet wurden. |
| Realitätsnähe | Wird als eine der zu bewahrenden Bedingungen aufgeführt. | Kriterien, Bewertende und ein Vergleich mit realen Eingaben. |
| Ausführbarkeit | Die Ausführbarkeit wird als Bedingung erwähnt. | Welche Aufgaben eine Ausführung erfordern und wie Fehler erfasst werden. |
| Reproduzierbarkeit | Die Zusammenfassung macht keine detaillierten Angaben zur Verfügbarkeit von Artefakten. | Zugang zu Fällen, Code, Konfigurationen und vollständigen Ergebnissen. |
Was noch fehlt, um die Reichweite des Verfahrens zu beurteilen
Die zusammengefasste Evidenz benennt den Ansatz, die drei Benchmarks, die drei Qwen3.5-Größen und die von den Autoren berichteten aggregierten Ergebnisse. Sie reicht dagegen nicht aus, um genau zu beantworten, wie der Durchschnitt von 22,7 Prozent berechnet wurde, welche Ergebnisse sich für jede Kombination aus Aufgabe und Modell ergaben oder welchen Einfluss die einzelnen Bedingungen hatten. Auch lässt sich nicht feststellen, ob HARDEN andere Verfahren zur Erzeugung schwieriger Fälle durchgehend übertrifft. Der einzige in der Zusammenfassung näher bezeichnete Vergleich ist der mit Single-Pass-Baselines, die dieselben Zulässigkeitsprüfungen verwenden.
Um die Reproduzierbarkeit zu beurteilen, müsste der vollständige Text geprüft werden. Dabei wäre festzustellen, ob die erzeugten Fälle, der Code, die Ausführungsanweisungen und aufgeschlüsselte Tabellen veröffentlicht wurden. Für die Frage der Repräsentativität wäre außerdem wichtig zu wissen, wie die Varianten mit Eingaben aus realen Einsätzen verglichen wurden und wie Fachleute oder Nutzer aus den jeweiligen Domänen sie bewerteten. Die vorliegende Zusammenfassung bestätigt diese Punkte nicht. Ohne Prüfung des vollständigen Materials sollte man deshalb weder behaupten, sie seien verfügbar, noch, sie fehlten.
Die Ergebnisse vorsichtig lesen
- 01Beobachtete Ergebnisse in Benchmarks von jeder Prognose für den Produktiveinsatz unterscheiden.
- 02Durchschnitt und Höchstwert im Zusammenhang mit den jeweiligen Vergleichsverfahren und Metriken lesen.
- 03Vor Verallgemeinerungen die Aufschlüsselung nach Benchmark, Modell und Aufgabe suchen.
- 04Unabhängig prüfen, ob Semantik, Realitätsnähe und Zielantwort erhalten bleiben.
- 05Verfügbarkeit von Daten und Code prüfen, bevor die Reproduzierbarkeit beurteilt wird.
Ein Werkzeug zum Verschärfen von Tests, dessen Reichweite noch zu bestimmen ist
HARDEN schlägt einen systematischen Weg vor, ausgehend von bestehenden Beispielen anspruchsvollere Evaluierungsfälle zu suchen. Bedingungen sollen dabei bewahren, was einen Fall gültig macht. Die berichteten Ergebnisse deuten darauf hin, dass das Verfahren die Genauigkeit der untersuchten Modelle in FinQA, PubMedQA und ContractNLI senken konnte. Was sich der Zusammenfassung sicher entnehmen lässt, ist dieser Nachweis im Rahmen des beschriebenen Experiments. Sie belegt weder abschließend die Qualität der Benchmarks noch, dass sich Ausfälle in Unternehmensumgebungen damit vorhersagen lassen.
Die nächste Frage lautet nicht nur, ob die Varianten Modelle stärker herausfordern, sondern auch, ob sie dies aus relevanten und reproduzierbaren Gründen tun. Eine anspruchsvollere Evaluation ist dann nützlich, wenn sie die Aufgabe erhält, eine überprüfbare Antwort bewahrt und Schwierigkeiten abbildet, die auch außerhalb des Benchmarks eine Rolle spielen. Die Zusammenfassung nennt Bedingungen, die auf diese Ziele ausgerichtet sind, doch anhand der verfügbaren Informationen lässt sich nicht unabhängig feststellen, wie ihre Einhaltung geprüft wurde. Bis aufgeschlüsselte Ergebnisse und Belege zur Realitätsnähe vorliegen, sollte man die 22,7 Prozent als eine für die Tests des Preprints berichtete Zahl lesen – nicht als allgemeines Maß für die Leistungsfähigkeit von KI.
Offene Fragen
- Die Zusammenfassung sagt nicht, ob die 22,7 Prozent eine relative Verringerung oder eine Differenz in Prozentpunkten bezeichnen.
- Ergebnisse nach Benchmark, Modell und Aufgabe sowie ausreichende Angaben zur Neuberechnung des Durchschnitts fehlen.
- Es wird nicht im Detail erläutert, wie die Bewahrung von Semantik, Realitätsnähe, erwarteter Antwort und Ausführbarkeit überprüft wurde.
- Die Zusammenfassung bestätigt nicht, ob die erzeugten Fälle, der Code und alle für eine Reproduktion nötigen Ergebnisse veröffentlicht wurden.
- Der beschriebene Vergleich reicht nicht aus, um die Leistung gegenüber anderen Verfahren jenseits der genannten Single-Pass-Baselines einzuschätzen.
- Die bereitgestellte Evidenz zeigt nicht, dass die Varianten Eingaben aus realen Einsätzen ähneln.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen