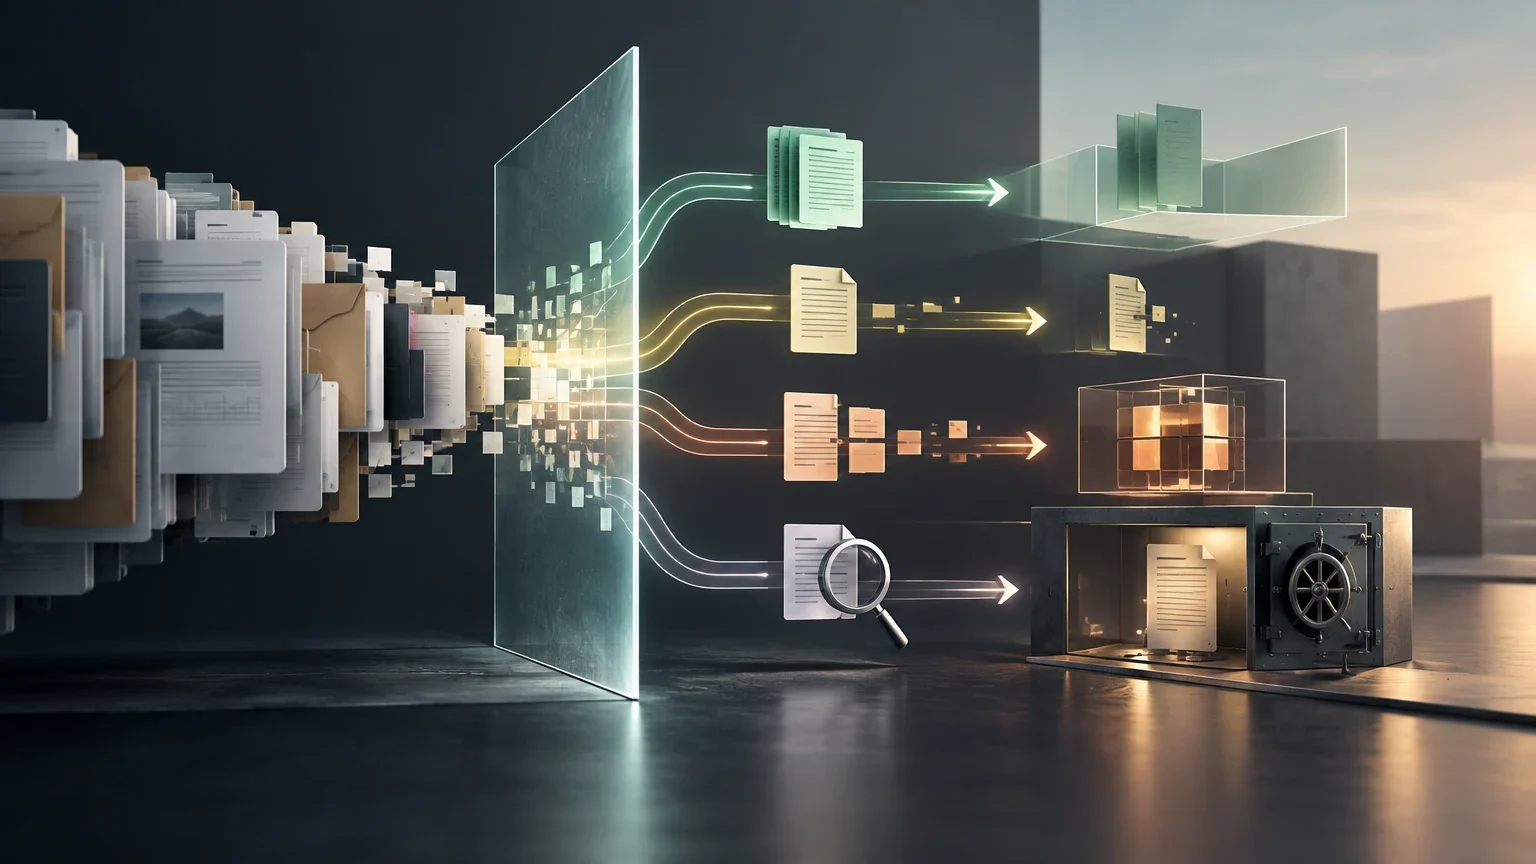
La décision ne se résume pas à « document privé : oui ou non »
Un contrat, un dossier de ressources humaines, un rapport d’ingénierie ou un fichier client peuvent contenir des informations de sensibilités très différentes. Une recherche interne ne présente pas non plus le même risque qu’une extraction de champs destinée à préremplir un écran, qu’un résumé destiné à orienter un analyste ou qu’une classification qui déclenche une conséquence opérationnelle. La première décision utile n’est donc pas de choisir entre une API externe et un modèle exécuté sur sa propre infrastructure. Elle consiste à décrire la transformation souhaitée, les données mobilisées, les destinataires du résultat et ce qui se produirait si ce résultat était erroné ou divulgué.
Le Règlement général sur la protection des données énonce des principes de limitation des finalités, de minimisation des données, de limitation de la conservation ainsi que de protection des données dès la conception et par défaut. Dans un flux d’IA, ces principes imposent de justifier l’inclusion de chaque partie du document et de chaque donnée associée. Il ne suffit pas que le document soit accessible à l’équipe ou qu’une relation contractuelle existe avec un fournisseur : le flux précis doit poursuivre une finalité délimitée, utiliser des données pertinentes et comporter des contrôles adaptés au risque.
Il est utile de séparer deux plans. Le premier est factuel : quels textes, fichiers, métadonnées, instructions et journaux circulent dans le système ? Le second relève de la décision : quel usage est autorisé pour chaque sortie, et quelle personne ou quel processus porte la responsabilité de la validation ? Cette distinction évite de confondre une capacité technique, par exemple produire un résumé, avec l’autorisation d’employer ce résumé pour décider au sujet d’une personne, d’une obligation contractuelle ou d’une opération.
La question initiale peut être formulée ainsi : quelle est l’action ultérieure, est-elle réversible, et quel serait l’impact d’une erreur ? Une réponse qui aide seulement à retrouver une clause peut nécessiter des contrôles différents d’une sortie qui modifie un dossier, refuse une demande, hiérarchise une enquête ou s’intègre à une communication externe. La réversibilité ne supprime pas le risque, mais elle aide à fixer le niveau de révision et les conditions d’arrêt.
Variables à décider avant de sélectionner un environnement
| Variable | Question opérationnelle | Conséquence habituelle |
|---|---|---|
| Finalité | Rechercher, résumer, extraire, classer ou rédiger ? | Détermine le contenu minimal et le type de validation. |
| Sensibilité | Y a-t-il des données personnelles, des secrets d’affaires, des identifiants d’accès, des informations de santé ou de travail ? | Accroît le besoin de segmenter, de restreindre l’accès ou de changer d’environnement. |
| Réidentification | Des fragments, dates, fonctions ou noms de projet permettent-ils d’attribuer le contenu ? | Empêche de considérer la simple suppression des noms comme une anonymisation suffisante. |
| Impact de l’erreur | La sortie peut-elle affecter des droits, des contrats, des paiements, la sécurité ou les opérations ? | Exige des limites d’usage et, fréquemment, une révision humaine. |
| Réversibilité | Une action peut-elle être corrigée avant de produire ses effets ? | Oriente le seuil d’automatisation et les tests préalables. |
Établissez un inventaire minimal du flux, et pas seulement du fichier original
Le document original n’est qu’un composant. Un scan peut passer par reconnaissance optique de caractères ; le texte extrait peut conserver des en-têtes, des notes, des tableaux et des erreurs de lecture ; une application peut ajouter des instructions, des résultats de recherches antérieures, des pièces jointes et des métadonnées utilisateur. Ensuite, la requête peut générer des traces techniques, des métriques, des copies temporaires, des journaux d’audit et une sortie qu’un autre système stocke ou transmet. Un inventaire qui ne recense que le PDF ne permet pas d’évaluer l’exposition réelle.
Pour chaque composant, consignez son origine, son titulaire ou service responsable, sa classification, son emplacement, ses destinataires techniques, sa période de conservation et la possibilité d’un accès humain. Incluez le texte inséré dans les instructions, les fragments récupérés depuis un index, les outils appelés par le modèle et les systèmes d’observabilité. Les journaux peuvent être nécessaires à l’investigation d’incidents, mais ils peuvent aussi reproduire des informations sensibles ; ils doivent être conçus selon le même critère de minimisation que la requête principale.
Le NIST recommande de gérer les risques de l’IA générative par la gouvernance, la cartographie, la mesure et la gestion. Appliqué à ce cas, l’inventaire n’est pas une tâche administrative isolée : il permet de savoir quels composants doivent être évalués, qui maîtrise chaque étape et quelles preuves peuvent permettre de reconstituer la production d’une sortie. Il aide également à détecter les changements importants, tels qu’une nouvelle version d’OCR, un modèle différent, un connecteur supplémentaire ou une modification de la politique de conservation.
La classification doit être précise. « Confidentiel » peut être une étiquette utile, mais elle ne distingue pas un secret technique, des coordonnées, une évaluation de performance, une information de santé ou un document associant plusieurs de ces catégories. Classez aussi les pièces jointes et les métadonnées. Le nom d’un fichier, un chemin interne, un identifiant de dossier, une date ou le nom d’un projet peuvent révéler autant qu’un paragraphe du corps du document.
Inventaire opérationnel en sept étapes
- 01Identifiez l’original, ses pièces jointes, ses versions et sa provenance.
- 02Décrivez les transformations : OCR, nettoyage, découpage en fragments, indexation, pseudonymisation et traduction lorsqu’elle existe.
- 03Listez les instructions, le contexte récupéré, les outils, le modèle et la destination de chaque requête.
- 04Classez séparément le texte, les images, les tableaux, les métadonnées et les journaux.
- 05Attribuez un responsable technique et un responsable de la décision d’usage pour chaque étape.
- 06Définissez la conservation, l’effacement et l’accès autorisé pour chaque copie ou représentation.
- 07Versionnez le flux et conservez les preuves des tests avant d’autoriser la production.
Quatre modèles de traitement et le critère de choix
Le traitement direct avec contrôles peut être proportionné lorsque la finalité exige le contenu complet, que l’accès est limité, que l’environnement est autorisé pour cette catégorie d’information et que la sortie ne déclenche pas à elle seule une conséquence matérielle. Les contrôles ne sont pas un ajout ultérieur : ils comprennent l’authentification, les autorisations fondées sur le rôle, le chiffrement en transit et au repos lorsque cela est approprié, la configuration de la conservation, la séparation des environnements, la journalisation des accès et des tests démontrant que l’application n’intègre pas de données inutiles dans la requête.
La minimisation ou la pseudonymisation préalable vise à réduire l’exposition avant le traitement. Elle peut consister à supprimer des colonnes non pertinentes, à remplacer des identifiants par des références, à retirer des coordonnées ou à ne fournir que les champs nécessaires. La pseudonymisation peut limiter l’impact d’une exposition, mais n’équivaut pas nécessairement à une anonymisation. Les lignes directrices du Comité européen de la protection des données, publiées pour consultation publique, soulignent que les informations supplémentaires, les quasi-identifiants et le contexte sont pertinents pour apprécier la possibilité d’attribution ou de réidentification.
La segmentation et l’envoi sélectif sont appropriés lorsque la tâche peut être accomplie à partir d’une section, d’un tableau ou de champs précis. Par exemple, pour retrouver la date de renouvellement d’un contrat, il n’est peut-être pas nécessaire d’envoyer les annexes commerciales, les signatures, les données bancaires ou le reste du dossier. Toutefois, diviser le document ne garantit pas l’isolement : plusieurs fragments, un identifiant stable ou l’accumulation des requêtes peuvent révéler le contexte que l’on cherchait à limiter.
Le traitement dans un environnement contrôlé devient important lorsque l’information ne peut pas sortir d’un périmètre défini, lorsque le document complet est nécessaire, lorsque le risque de réidentification demeure élevé ou lorsqu’une sortie a un impact important. Ce modèle peut impliquer une infrastructure propre ou un environnement doté de limites techniques et organisationnelles spécifiques, mais son appellation ne prouve pas à elle seule qu’il est adapté. Les configurations, les accès, les conservations, les composants connectés et la capacité d’audit doivent être vérifiés. Le guide sur les modèles locaux peut aider à analyser les implications techniques de l’exploitation de composants dans sa propre infrastructure ; il ne remplace pas l’analyse du flux et ne supprime pas les risques liés aux autorisations, aux journaux ou aux intégrations.
Appliquez un arbre de décision selon la finalité
La recherche peut accepter une architecture différente de la classification. Dans une recherche, l’objectif peut être de retourner des documents ou des passages candidats ; le résultat ne devrait pas être présenté comme une réponse définitive si la récupération est incomplète. Pour un résumé, il faut définir l’audience, la longueur, les faits à préserver et les interdictions : un résumé peut omettre des exceptions, des conditions ou des divergences importantes. Pour l’extraction structurée, définissez le schéma de champs, la preuve textuelle qui étaye chaque valeur et le traitement de l’absence, de l’ambiguïté ou du conflit.
En matière de classification, précisez quelle classe est attribuée, quels signaux sont admis et ce qui se passe pour les cas limites. Une étiquette de priorité, de risque ou de statut peut orienter le travail ultérieur même si elle ne constitue pas une décision finale. Pour les brouillons, déterminez quelles parties le système peut rédiger, quelles informations il ne doit pas inventer et qui vérifie le ton, l’exactitude, les destinataires et les données incluses avant envoi ou publication.
Un critère pratique consiste à vérifier si la finalité exige le document complet. Si ce n’est pas le cas, réduisez le contenu. Si le contenu complet est requis mais que la sortie est informative et révisable, envisagez un environnement autorisé avec des contrôles d’accès et de journalisation. Si le résultat peut produire une conséquence matérielle ou s’avère difficile à corriger, ne transformez pas la sortie en action automatique sans évaluation spécifique, condition claire de validation et mécanismes permettant d’arrêter le flux.
Le choix des outils ne doit pas être confondu avec cette classification. Un modèle d’OCR peut être utile pour obtenir du texte à partir d’un scan, et un modèle léger peut servir à une classification limitée, mais tous deux font partie d’un système qui inclut aussi le stockage, les autorisations, les instructions, les journaux et l’usage ultérieur. En particulier, intégrer Mistral OCR 4.1 ou Amazon Nova 2 Lite ne permet pas de déduire à lui seul quelles données sont autorisées, quelle conservation s’applique ni si le résultat peut servir à une décision. Ces éléments doivent être vérifiés dans la configuration et dans la documentation du flux.
Décision indicative par finalité
| Finalité | Représentation initiale préférable | Usage de la sortie | Condition d’arrêt |
|---|---|---|---|
| Recherche | Fragments pertinents avec métadonnées minimales | Assistance pour localiser l’original | Les preuves sont insuffisantes ou l’index peut être incomplet. |
| Résumé | Sections nécessaires et règles de couverture | Brouillon informatif révisable | Des sections manquent, des contradictions existent ou le document exige une précision littérale. |
| Extraction | Champs ou pages pertinents avec preuve textuelle | Préremplissage soumis à validation | Valeur ambiguë, absente, incohérente ou hors format. |
| Classification | Attributs nécessaires et classes définies | Priorisation ou routage contrôlé | Cas limite, impact élevé ou signal insuffisant. |
| Brouillon | Faits validés et modèle autorisé | Texte en attente d’approbation | Il comprend des affirmations non étayées, des destinataires sensibles ou des données excessives. |
La minimisation n’élimine ni le risque de réidentification ni celui d’inférence
Supprimer les noms, adresses ou numéros d’identification peut être utile, mais cela ne suffit pas pour conclure que le contenu est anonyme. Une combinaison de fonction, date, lieu, montant, incident décrit, fournisseur et nom de projet peut identifier indirectement une personne ou révéler une négociation précise. Les informations supplémentaires peuvent se trouver dans le même système, dans une table de correspondance ou même dans les connaissances accessibles aux personnes qui reçoivent le résultat.
Il existe aussi des données inférées. Un résumé des absences, une classification de risque ou une extraction de conditions peuvent révéler des informations qui n’apparaissent pas comme un identifiant direct. De même, les métadonnées d’accès peuvent indiquer qu’un utilisateur a consulté un dossier sensible. Évaluez à la fois le contenu transmis et ce qui peut être déduit de la sortie, de la fréquence des requêtes et de la combinaison avec d’autres sources internes.
L’évaluation doit inclure des attaques et défaillances plausibles : une instruction mal conçue qui entraîne un document entier, une recherche qui récupère le contenu d’un autre dossier, une trace qui conserve du texte en clair, des autorisations trop larges, un outil connecté qui reçoit davantage de contexte que nécessaire ou une personne qui se fie à une extraction erronée. Des essais avec des documents difficiles — scans, tableaux, annexes, contradictions et contenus qui ne doivent pas circuler — sont plus représentatifs qu’une démonstration sur des exemples propres.
Les recommandations de l’INCIBE invitent à examiner le fournisseur et ses politiques de confidentialité, à employer des connexions sécurisées et à exploiter les réglages de confidentialité. Pour les équipes professionnelles, cela doit se traduire par des vérifications techniques documentées, et non par une acceptation générique. Déterminez qui exploite chaque composant, quels accès sont possibles, quels réglages ont été activés, combien de temps les requêtes et les résultats sont conservés, et comment l’effacement est vérifié à la fin de la finalité.
Définissez quand la sortie assiste et quand la révision humaine est obligatoire
La révision humaine ne consiste pas à placer une personne à la fin de l’écran. Cette personne doit disposer de l’autorité, des informations et du temps nécessaires pour détecter les erreurs. Dans une extraction de champs, cela peut imposer d’afficher le fragment original qui justifie chaque valeur. Dans un résumé, il peut être nécessaire de comparer le brouillon aux sections critiques. Dans une classification, il peut être nécessaire de comprendre la règle appliquée, les données employées et les alternatives possibles. Sans ces conditions, la révision risque d’être purement formelle.
Comme règle prudente, considérez la sortie comme une assistance lorsqu’elle organise, retrouve, propose ou préremplit. Renforcez le contrôle lorsque la sortie peut affecter l’emploi, l’accès à des services, les obligations contractuelles, les paiements, la sécurité, les droits d’une personne, les communications externes ou des décisions difficiles à inverser. Au-delà de l’impact, tenez compte de l’incertitude du document : scans de mauvaise qualité, manuscrits, tableaux complexes, annexes, langage conditionnel et contradictions internes diminuent la fiabilité opérationnelle.
Définissez les conditions d’arrêt avant d’automatiser. Elles peuvent inclure l’absence de preuve textuelle, une réponse hors du schéma autorisé, un conflit entre champs, une qualité OCR faible, l’absence d’une révision requise, la présence de catégories exclues ou des changements non approuvés dans le modèle, les instructions ou les connecteurs. Une condition d’arrêt doit entraîner une action concrète : bloquer la publication, envoyer le cas en révision, demander une information supplémentaire ou retirer l’élément de la file automatique.
Le profil du NIST sur l’IA générative identifie des risques liés à la confidentialité, à la fuite, à la traçabilité, aux contenus incorrects et à la confiance excessive des humains. Il n’impose pas à lui seul une architecture précise, mais offre une base pour ne pas évaluer uniquement l’exactitude moyenne. Un système peut être correct sur la plupart des documents tout en restant inadapté si ses erreurs sont opaques, difficiles à détecter ou concentrées dans les cas les plus impactants.
Concevoir une révision humaine effective
- 01Affichez la sortie, la preuve source et la version du flux qui l’a produite.
- 02Indiquez explicitement si le résultat est un brouillon, une recommandation ou une donnée validée.
- 03Exigez une confirmation pour les cas définis par leur impact, leur ambiguïté ou leurs catégories de données.
- 04Permettez de corriger, de rejeter et d’expliquer le motif de la décision.
- 05Enregistrez la validation sans reproduire inutilement le contenu sensible.
- 06Utilisez les rejets et les erreurs pour actualiser les tests, les règles et les limites d’usage.
Transformez les contrôles en vérifications auditables
Les contrôles doivent pouvoir être vérifiés avant et après le déploiement. Pour l’accès, vérifiez que seuls les rôles nécessaires peuvent voir l’original, les fragments, les sorties et les journaux. Pour l’isolement, testez qu’une requête liée à un dossier ne récupère pas de contenu issu d’un autre. Pour la conservation, vérifiez le sort des fichiers temporaires, files, caches, index et traces. Pour l’effacement, définissez le périmètre : supprimer un écran ne signifie pas nécessairement supprimer les copies de travail ou les journaux associés.
La traçabilité doit permettre de reconstituer une sortie sans conserver davantage de contenu que nécessaire. Enregistrez les identifiants internes, la version du document, la transformation appliquée, la version d’OCR ou du modèle, le modèle d’instructions, les règles de récupération, la date, l’opérateur technique et la décision humaine ultérieure. Reliez ces preuves aux contrôles d’accès. Enregistrer le texte intégral de chaque requête peut être disproportionné pour certaines finalités ; une alternative consiste à conserver des références, des empreintes ou des extraits limités lorsqu’ils permettent d’enquêter sans multiplier le contenu exposé.
Incluez des tests de fuite et de comportement adversarial. Essayez de récupérer des fragments d’un autre dossier, introduisez des instructions présentes dans le document afin de vérifier qu’elles ne modifient pas le flux, vérifiez que les sorties respectent les champs interdits et observez la réponse aux erreurs d’OCR. Testez le plan d’incident : qui peut arrêter le traitement, comment les accès sont révoqués, comment les preuves sont préservées et comment l’étendue est évaluée sans élargir inutilement l’exposition.
Le contrôle contractuel et la configuration technique sont complémentaires. Un accord peut délimiter des responsabilités, mais il ne remplace ni les autorisations minimales, ni les tests de conservation, ni l’examen des intégrations. Inversement, une configuration correcte ne résout pas une finalité indéfinie. Ce guide est opérationnel et ne remplace pas l’analyse juridique applicable ni une analyse d’impact lorsqu’elle est nécessaire.
Preuve minimale de contrôle avant la production
| Contrôle | Preuve vérifiable | Fréquence de révision |
|---|---|---|
| Accès | Matrice des rôles et test démontrant que les comptes non autorisés n’accèdent pas au contenu | À chaque changement de rôle et périodiquement. |
| Conservation et effacement | Configuration documentée et test sur copies temporaires, index et journaux | Avant production et après des changements techniques. |
| Isolement | Tests de récupération croisée et de limites entre dossiers ou clients | À chaque changement important. |
| Traçabilité | Journal de la version, de la transformation, du modèle et de la décision humaine | À chaque exécution ou cas défini. |
| Qualité et arrêt | Jeu de tests difficiles et preuves de blocage ou d’escalade | Avant déploiement et en continu. |
| Incidents | Procédure testée de confinement, révocation et analyse | Selon le plan de réponse. |
Utilisez un modèle de décision pour chaque flux documentaire
Un modèle court oblige à expliciter les décisions et aide les équipes produit, sécurité, opérations et juridique à discuter du même objet. Il doit être rempli pour chaque flux, et non pour un outil considéré abstraitement. Par exemple, « résumer des dossiers » peut recouvrir des données, des finalités et des conséquences si différentes qu’une autorisation générale perd toute utilité. Si plusieurs étapes existent, documentez chacune d’elles : OCR, indexation, récupération, génération, stockage de la sortie et action ultérieure.
Incluez au minimum : la finalité ; la catégorie et l’origine des données ; les pièces jointes et métadonnées incluses ; le contenu explicitement exclu ; la transformation préalable ; l’environnement autorisé ; les entités qui exploitent chaque composant ; la sortie autorisée ; les destinataires ; la durée de conservation ; le responsable de la validation ; les preuves à conserver ; les conditions d’arrêt ; et la procédure d’incident. Lorsqu’une décision dépend d’une affirmation contractuelle ou technique d’un tiers, indiquez quelle preuve a été examinée et à quelle date, plutôt que de supposer que cette condition demeure stable.
Certaines incertitudes ne sont pas résolues par le modèle seul. La documentation disponible peut ne pas décrire entièrement le comportement de tous les composants ; une politique de conservation peut varier selon la configuration ; et la capacité de réidentification dépend d’informations supplémentaires et du contexte organisationnel. Les risques évoluent également lorsque des connecteurs sont ajoutés, que les résultats sont réutilisés ou que l’audience s’élargit. La décision doit donc être revue après tout changement matériel et après des incidents ou des conclusions de test.
Le résultat recherché n’est pas d’éliminer toute exposition, ce qui peut être irréalisable pour certaines finalités, ni d’adopter automatiquement un modèle local. Il s’agit de pouvoir justifier un choix proportionné : quelles informations sont traitées, pourquoi elles sont nécessaires, quels contrôles limitent l’exposition, quel résultat peut être utilisé et dans quels cas une personne doit arrêter ou valider le flux. Pour approfondir l’analyse des options, il est utile de relier cette décision à l’index de choix des solutions et aux guides internes de sécurité, tout en gardant le flux documentaire concret comme unité d’évaluation.
Questions ouvertes
- Les lignes directrices européennes sur la pseudonymisation citées étaient en consultation publique dans la version fournie ; leur interprétation et leur statut peuvent évoluer.
- La possibilité de réidentification dépend d’informations supplémentaires, du contexte, des destinataires et de combinaisons de données qui ne sont pas toujours visibles lors de la conception d’un flux.
- Les preuves contractuelles, techniques et de configuration de chaque composant doivent être examinées pour le cas concret ; elles ne peuvent pas être déduites de la catégorie commerciale d’un outil.
- Ce guide fournit des critères opérationnels et ne remplace ni un conseil juridique ni les évaluations formelles susceptibles de s’appliquer.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction