Ce que Microsoft a annoncé et ce qui peut être confirmé
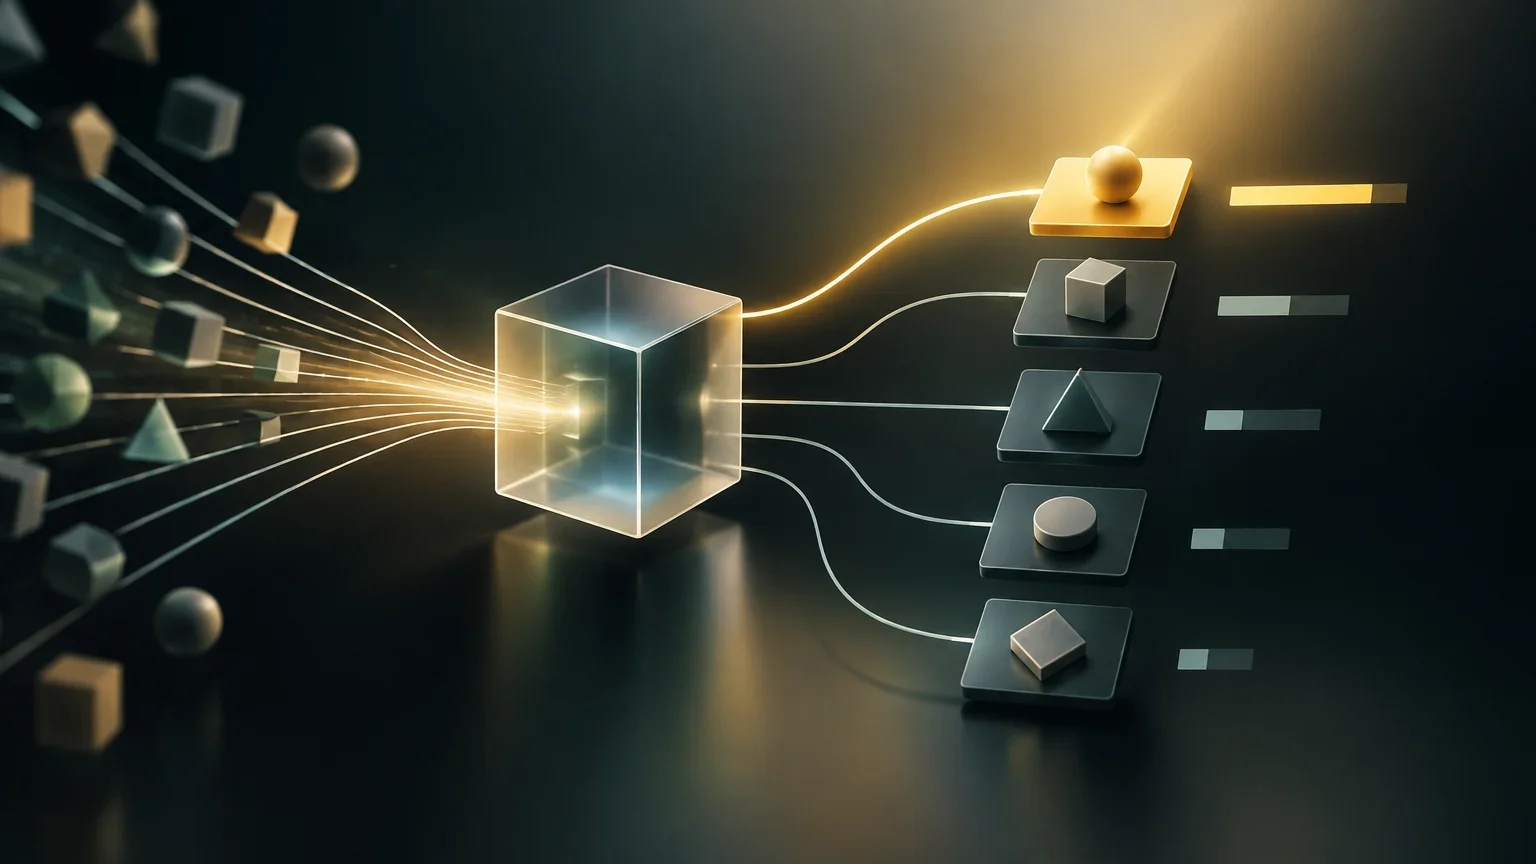
Microsoft présente Decision-1 comme un modèle de scoring de décision. Au lieu de produire nécessairement un texte libre, il reçoit une situation, une question et un ensemble fixe de réponses possibles, puis renvoie des probabilités associées à ces options. C’est la caractéristique centrale indiquée dans la fiche du modèle du catalogue de Microsoft.
La différence peut sembler minime, mais elle change le type de tâche auquel le système est destiné. Un modèle génératif produit généralement une réponse en langage naturel ; un modèle de scoring compare des options déjà définies et aide à déterminer laquelle paraît la plus probable ou la plus appropriée parmi celles-ci. Cela ne signifie pas que le modèle prenne lui-même les décisions, ni que ses probabilités garantissent un résultat correct.
Les informations disponibles ne permettent pas de confirmer tous les détails habituellement associés à un lancement : conditions d’accès, licence, restrictions d’utilisation, disponibilité selon la région ou la configuration, ni résultats reproductibles d’évaluation. Elles ne suffisent pas non plus à vérifier l’architecture ou le modèle de base. Il convient donc de distinguer la description fonctionnelle présente dans le catalogue des affirmations sur les performances, qui nécessitent une documentation supplémentaire.
Évaluer des options, ce n’est pas rédiger une réponse
Dans une interaction ouverte, on peut demander à un modèle d’expliquer comment classer une requête et obtenir une longue justification. Cette réponse peut être utile à une personne, mais une application automatisée devra interpréter le texte, extraire une étiquette et gérer d’éventuelles variations de format. Lorsque les options sont prédéfinies, une sortie sous forme de probabilités peut s’intégrer plus directement à une règle ultérieure : choisir une catégorie, transmettre un dossier pour examen ou sélectionner un outil.
Le mot « probabilité » mérite également d’être employé avec prudence. La valeur associée à une option constitue un signal quantitatif, pas une certification de l’exactitude du résultat. Pour l’utiliser de manière fiable, il faudrait savoir comment elle a été calibrée, sur quelles données le modèle a été évalué et si ce calibrage reste valable dans le contexte réel d’utilisation. La description du catalogue évoque des probabilités calibrées, mais les informations disponibles ne détaillent pas la méthode et ne proposent pas de résultats indépendants permettant de l’évaluer.
L’ensemble des réponses limite aussi la portée de la décision. Si aucune option ne représente correctement le cas, le système risque de devoir attribuer un score à des choix inadéquats. Un flux robuste devrait prévoir une réponse du type « aucune de ces options », une voie d’escalade ou un examen humain lorsque les probabilités sont proches ou insuffisantes. Rien ne permet de supposer que Decision-1 intègre ces mécanismes : en l’absence de confirmation dans la documentation du modèle, il s’agirait de choix de conception propres au système qui l’utilise.
Deux modes d’interaction
| Aspect | Génération de texte libre | Scoring d’options |
|---|---|---|
| Sortie habituelle | Texte rédigé en réponse à une consigne ouverte | Probabilités associées à des options prédéfinies |
| Utilisation dans une application | Peut nécessiter d’interpréter ou de valider le texte | Peut alimenter une sélection ou une règle ultérieure |
| Risque à maîtriser | Format variable ou réponse difficile à convertir en action | Options incomplètes et confiance mal interprétée |
| Ce que cela ne garantit pas | Que l’explication soit correcte | Que l’option ayant le score le plus élevé soit toujours correcte |
Où un tel modèle pourrait s’intégrer dans un flux d’agents
Un agent logiciel combine souvent plusieurs opérations : il reçoit une demande, classe le travail, choisit l’outil à utiliser et vérifie si le résultat répond aux critères définis. Un modèle qui attribue des scores à des options peut être utile aux étapes où le système connaît déjà les choix possibles. Il pourrait, par exemple, aider à choisir une catégorie dans une file de demandes d’assistance ou parmi plusieurs outils disponibles, à condition que l’application définisse les options, valide la sortie et prenne en charge les cas incertains.
Il s’agit de pistes de conception, et non de résultats démontrés pour Decision-1 par les éléments disponibles. Le catalogue décrit le format de scoring, mais ne prouve pas que le modèle atteigne un taux de réussite donné pour le routage, la priorisation, la vérification ou tout autre scénario précis. Son utilité dépendra de la pertinence des options, des informations fournies et de l’évaluation menée dans l’environnement cible.
La documentation générale de Microsoft sur le choix de modèles pour les agents apporte des éléments de contexte pour réfléchir à la sélection d’un modèle en fonction de la tâche. Elle ne constitue toutefois pas une évaluation de Decision-1 et ne démontre pas que ce modèle soit supérieur à d’autres. Cette distinction est importante pour une décision d’achat ou d’architecture : un guide général aide à structurer les questions, tandis que l’évaluation d’un produit doit fournir des données spécifiques et comparables.
Comment interpréter les chiffres de précision et de latence
L’annonce évoque un ensemble de 36 tests, un chiffre de précision et une latence de 85 millisecondes. Les éléments vérifiables disponibles ici ne permettent pas de contrôler la manière dont ces tests ont été construits, les modèles comparés, le critère retenu pour considérer une réponse comme correcte, ni si les résultats ont été calculés sur les mêmes tâches et dans les mêmes conditions. Ces chiffres ne doivent donc pas être considérés comme des performances générales confirmées.
Une évaluation utile devrait décrire le jeu de données, les consignes, le nombre et le type d’options, la méthode de scoring et la façon dont les résultats ont été agrégés. Elle devrait aussi préciser si les tests sont représentatifs d’applications réelles, si les données de développement et d’évaluation ont été séparées et comment le modèle se comporte lorsque la bonne réponse ne figure pas parmi les options. Sans ces informations, un chiffre de précision pris isolément ne permet pas d’estimer les performances dans une organisation donnée.
La latence ne peut pas non plus être interprétée sans contexte. Pour évaluer la mesure de 85 millisecondes, il faudrait connaître, entre autres, le matériel utilisé, le lieu de la mesure, la taille de l’entrée, le nombre d’options, le niveau de concurrence et l’inclusion éventuelle du temps de réseau. Une mesure réalisée dans des conditions contrôlées ne correspond pas nécessairement au temps observé par une application en production. La fiche consultée ne fournit pas les détails nécessaires pour déterminer si ce chiffre est comparable à ceux d’autres modèles.
Liste minimale pour évaluer une affirmation de performance
- 01Demander une description du jeu de tests, des tâches et du critère exact de réussite.
- 02Vérifier quelles options ont été proposées et comment les cas sans réponse valable ont été traités.
- 03Examiner si les modèles comparés ont reçu les mêmes entrées et ont été évalués selon la même méthode.
- 04Pour la latence, identifier le matériel, le niveau de concurrence, la taille des entrées et les intervalles de temps mesurés.
- 05Répéter le test avec ses propres exemples et distinguer les résultats obtenus en laboratoire du comportement en production.
Accès, licence et comparaisons : les questions encore ouvertes
Les documents fournis ne permettent pas de confirmer si Decision-1 est disponible dans Microsoft Foundry, sur OpenRouter ou sur les deux plateformes, ni sous quelles conditions. La licence, les limites d’utilisation, les formats de sortie proposés et les exigences de déploiement n’ont pas non plus été vérifiés. La présence d’une fiche dans un catalogue montre que Microsoft y décrit le modèle ; elle ne suffit pas à établir ces conditions opérationnelles.
Aucune évaluation indépendante vérifiée ne permet non plus de comparer Decision-1 à d’autres modèles sur une même tâche. La documentation générale sur le choix de modèles pour les agents peut aider à structurer une évaluation, mais ne remplace pas des tests comparatifs de performance. Avant de l’intégrer à un flux sensible, il est utile de mesurer à la fois la qualité des décisions et les conséquences des erreurs : une mauvaise étiquette qui retarde une démarche peut avoir des effets différents d’une recommandation examinée par une personne.
Pour suivre les actualités connexes, l’index des actualités permet de consulter les informations éditoriales, tandis que les rubriques de comparaison et de découverte peuvent aider à organiser les solutions possibles et à explorer des outils. Aucune de ces ressources ne remplace l’examen de la documentation produit ou la réalisation de tests propres. À ce stade, la conclusion prudente est simple : Decision-1 est présenté comme une solution de scoring de réponses fixes ; ses performances, ses conditions d’accès et son éventuel avantage par rapport à d’autres solutions nécessitent une documentation et des évaluations plus complètes.
Questions ouvertes
- La méthodologie, la composition et les résultats détaillés de l’ensemble de 36 tests ne sont pas vérifiés.
- Le chiffre de précision avancé ne peut pas être évalué sans connaître les tâches, le critère de réussite et les conditions de comparaison.
- La latence de 85 millisecondes n’est pas contextualisée par le matériel, la taille des entrées, le niveau de concurrence ou la méthode de mesure.
- Le modèle de base, la licence, les formats de sortie et les conditions d’accès dans Microsoft Foundry ou OpenRouter n’ont pas été confirmés.
- Aucune évaluation indépendante comparable de Decision-1 face à d’autres modèles n’est fournie.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction