O que a Microsoft anunciou e o que é possível confirmar
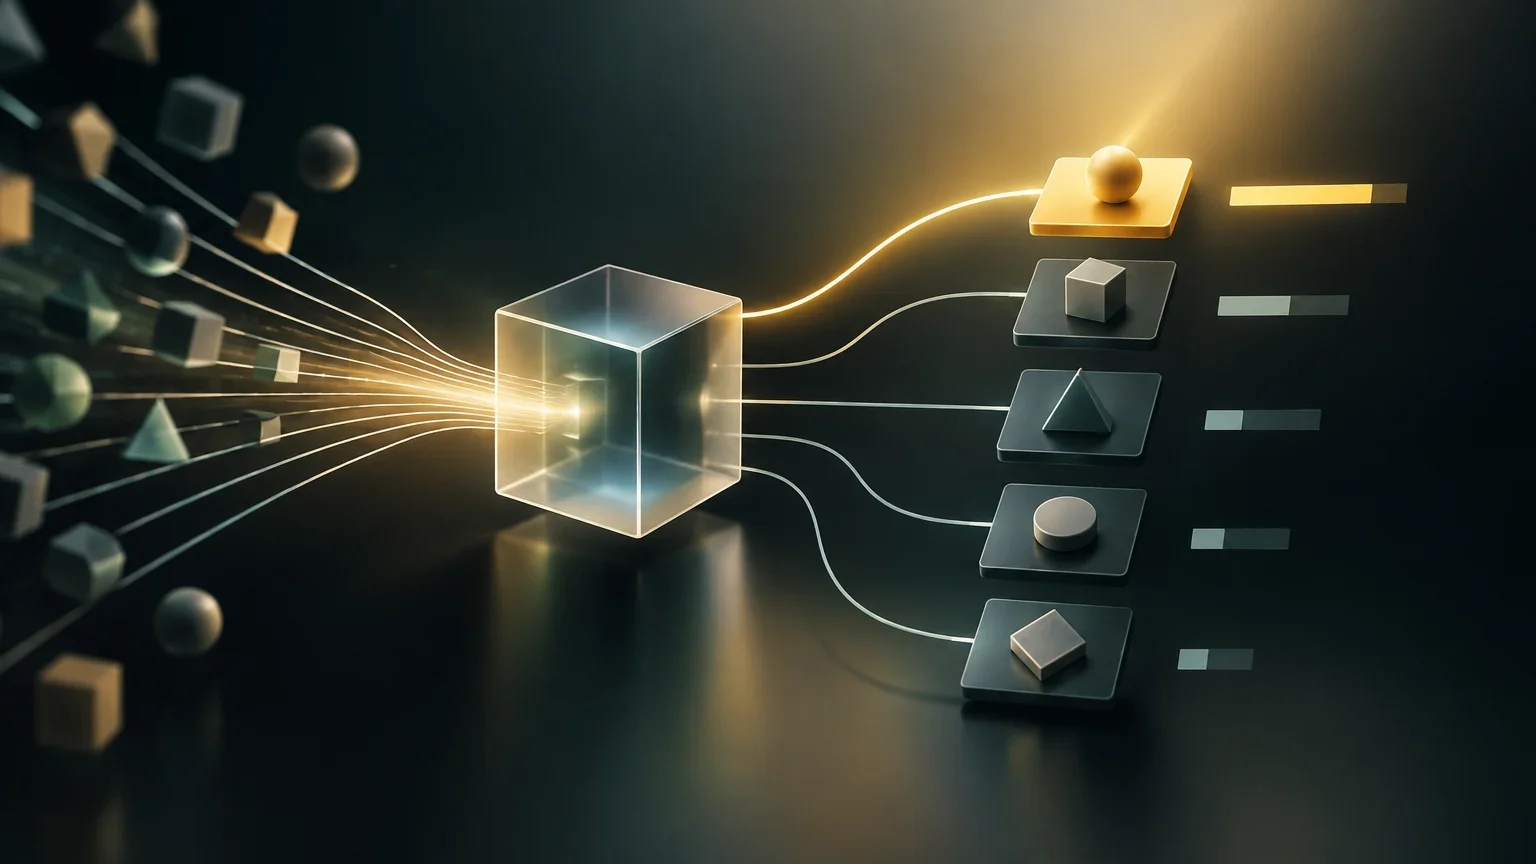
A Microsoft apresenta o Decision-1 como um modelo de pontuação de decisões. Em vez de necessariamente responder com texto aberto, recebe uma situação, uma pergunta e um conjunto fixo de respostas possíveis, e devolve probabilidades associadas a essas opções. Essa é a característica central descrita na ficha do modelo no catálogo da Microsoft.
A diferença pode parecer pequena, mas altera o tipo de tarefa a que o sistema se destina. Um modelo generativo costuma produzir uma resposta em linguagem natural; um modelo de pontuação compara alternativas já definidas e ajuda a indicar qual delas parece mais provável ou adequada dentro desse conjunto. Isso não significa que o modelo decida por conta própria nem que as probabilidades garantam um resultado correto.
As informações disponíveis não permitem confirmar todos os detalhes que normalmente acompanham um lançamento: condições de acesso, licença, restrições de utilização, disponibilidade por região ou configuração, nem resultados reproduzíveis de avaliação. Também não são suficientes para verificar a arquitetura ou o modelo de base. Por isso, convém separar a descrição funcional que aparece no catálogo das afirmações de desempenho, que exigem documentação adicional.
Pontuar opções não é o mesmo que redigir uma resposta
Numa interação aberta, é possível pedir a um modelo que explique como classificar uma solicitação e receber uma justificação extensa. Essa resposta pode ser útil para uma pessoa, mas uma aplicação automatizada terá de interpretar o texto, extrair uma etiqueta e lidar com eventuais variações de formato. Quando as opções são definidas antecipadamente, a saída probabilística pode integrar-se mais diretamente numa regra posterior: escolher uma categoria, encaminhar um caso para revisão ou selecionar uma ferramenta.
A palavra «probabilidade» também exige cautela. O valor associado a uma opção é um sinal quantitativo, não uma certificação de que o resultado estará correto. Para utilizá-lo com segurança, seria necessário saber como foi calibrado, em que dados foi avaliado e se a calibração se mantém no contexto real de utilização. A descrição do catálogo refere probabilidades calibradas, mas as informações disponíveis não detalham o procedimento nem apresentam resultados independentes que permitam avaliá-lo.
O conjunto de respostas também limita o alcance da decisão. Se nenhuma alternativa representar bem o caso, o sistema poderá ser obrigado a pontuar opções inadequadas. Um fluxo robusto deve prever uma opção como «nenhuma», uma via de escalonamento ou revisão humana quando as probabilidades forem próximas ou insuficientes. Não se pode pressupor que o Decision-1 inclua esses mecanismos: salvo confirmação na documentação do modelo, são decisões de conceção da aplicação que o integra.
Dois padrões de interação
| Aspeto | Geração de texto livre | Pontuação de opções |
|---|---|---|
| Saída habitual | Texto redigido em resposta a uma instrução aberta | Probabilidades associadas a alternativas predefinidas |
| Utilização numa aplicação | Pode exigir interpretação ou validação do texto | Pode alimentar uma seleção ou regra posterior |
| Risco a controlar | Formato variável ou resposta difícil de converter numa ação | Opções incompletas e interpretação incorreta da confiança |
| O que não garante | Que a explicação esteja correta | Que a opção com a pontuação mais alta esteja sempre correta |
Onde pode encaixar num fluxo com agentes
Um agente de software costuma combinar várias operações: recebe uma solicitação, classifica o trabalho, decide que ferramenta utilizar e verifica se o resultado cumpre determinados critérios. Um modelo que pontua alternativas pode ser útil nos pontos em que o sistema já conhece as opções válidas. Por exemplo, poderia ajudar a escolher entre categorias de uma fila de suporte ou entre ferramentas disponíveis, desde que a aplicação defina as alternativas, valide a saída e trate os casos duvidosos.
Estes são padrões de conceção possíveis, não resultados demonstrados para o Decision-1 nas fontes disponíveis. O catálogo descreve o formato de pontuação, mas não comprova que o modelo alcance uma determinada taxa de acerto em encaminhamento, priorização, verificação ou qualquer outro cenário específico. A utilidade dependerá da qualidade das opções, das informações fornecidas e da avaliação no ambiente de destino.
A documentação geral da Microsoft sobre seleção de modelos para agentes oferece contexto para pensar na escolha de modelos de acordo com a tarefa. Não constitui, contudo, uma avaliação do Decision-1 nem demonstra que seja superior a outros modelos. Essa distinção é importante numa decisão de compra ou de arquitetura: um guia geral ajuda a estruturar perguntas, mas a avaliação de um produto deve fornecer dados específicos e comparáveis.
Como interpretar os valores de precisão e latência
A proposta associada ao anúncio menciona um conjunto de 36 testes, um valor de precisão e uma latência de 85 milissegundos. Os materiais verificáveis disponíveis aqui não permitem confirmar como esses testes foram construídos, que modelos foram comparados, que limiar definiu um acerto ou se os resultados foram calculados com as mesmas tarefas e condições. Por isso, esses valores não devem ser tratados como uma medida geral de desempenho confirmada.
Uma avaliação útil teria de descrever o conjunto de dados, as instruções, o número e o tipo de opções, o método de pontuação e a forma de agregar os resultados. Também deveria esclarecer se os testes são representativos de aplicações reais, se houve separação entre dados de desenvolvimento e de avaliação e como o modelo se comporta quando a resposta correta não está entre as alternativas. Sem essas informações, um valor de precisão isolado não permite estimar o desempenho numa organização específica.
A latência também não pode ser interpretada sem contexto. Para avaliar os 85 milissegundos, seria necessário conhecer, entre outros fatores, o hardware, o local da medição, o tamanho da entrada, o número de opções, o nível de concorrência e se o tempo de rede está incluído. Um resultado medido em condições controladas não equivale necessariamente ao tempo observado por uma aplicação em produção. A ficha consultada não apresenta os detalhes necessários para confirmar que o valor é comparável aos de outros modelos.
Lista mínima para avaliar uma afirmação de desempenho
- 01Pedir a descrição do conjunto de testes, das tarefas e do critério exato de acerto.
- 02Verificar que alternativas foram apresentadas e como foram tratados os casos sem resposta válida.
- 03Confirmar se os modelos comparados receberam as mesmas entradas e foram avaliados pelo mesmo método.
- 04Para a latência, identificar o hardware, a concorrência, o tamanho da entrada e os intervalos de tempo medidos.
- 05Repetir o teste com exemplos próprios e distinguir os resultados de laboratório do comportamento em produção.
Acesso, licença e comparações: questões ainda em aberto
A documentação fornecida não permite confirmar se o Decision-1 está disponível no Microsoft Foundry, no OpenRouter ou em ambos, nem em que condições. Também não foram verificadas uma licença, limites de utilização, opções de saída específicas ou requisitos de implementação. A presença de uma ficha num catálogo comprova que a Microsoft descreve o modelo nesse local, mas, por si só, não esclarece essas condições operacionais.
Também não há avaliações independentes verificadas que permitam comparar o Decision-1 com modelos alternativos na mesma tarefa. A documentação geral sobre seleção de modelos para agentes pode orientar uma avaliação, mas não substitui testes comparáveis de desempenho. Antes de o integrar num fluxo sensível, convém medir tanto a qualidade da decisão como as consequências dos erros: uma etiqueta incorreta que atrasa um processo pode ter efeitos diferentes dos de uma recomendação revista por uma pessoa.
Para acompanhar as novidades relacionadas, o índice de notícias permite consultar a cobertura editorial; as áreas de comparação e descoberta podem ajudar a organizar alternativas e explorar ferramentas. Nenhuma delas substitui a consulta da documentação do produto ou a realização de testes próprios. A conclusão prudente, por agora, é específica: o Decision-1 é apresentado como uma opção para pontuar respostas fixas; o seu desempenho, as condições de acesso e a vantagem face a outras soluções precisam de documentação e testes mais completos.
Questões em aberto
- Não há informações verificadas sobre a metodologia, a composição ou os resultados detalhados do conjunto de 36 testes.
- O valor de precisão mencionado não pode ser avaliado sem conhecer as tarefas, o critério de acerto e as condições de comparação.
- A latência de 85 milissegundos não está contextualizada quanto a hardware, tamanho da entrada, concorrência ou método de medição.
- Não foram confirmados o modelo de base, a licença, as opções de saída nem as condições de acesso no Microsoft Foundry ou no OpenRouter.
- Não foram fornecidas avaliações independentes e comparáveis do Decision-1 face a outros modelos.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção