Qué ha anunciado Microsoft y qué puede confirmarse
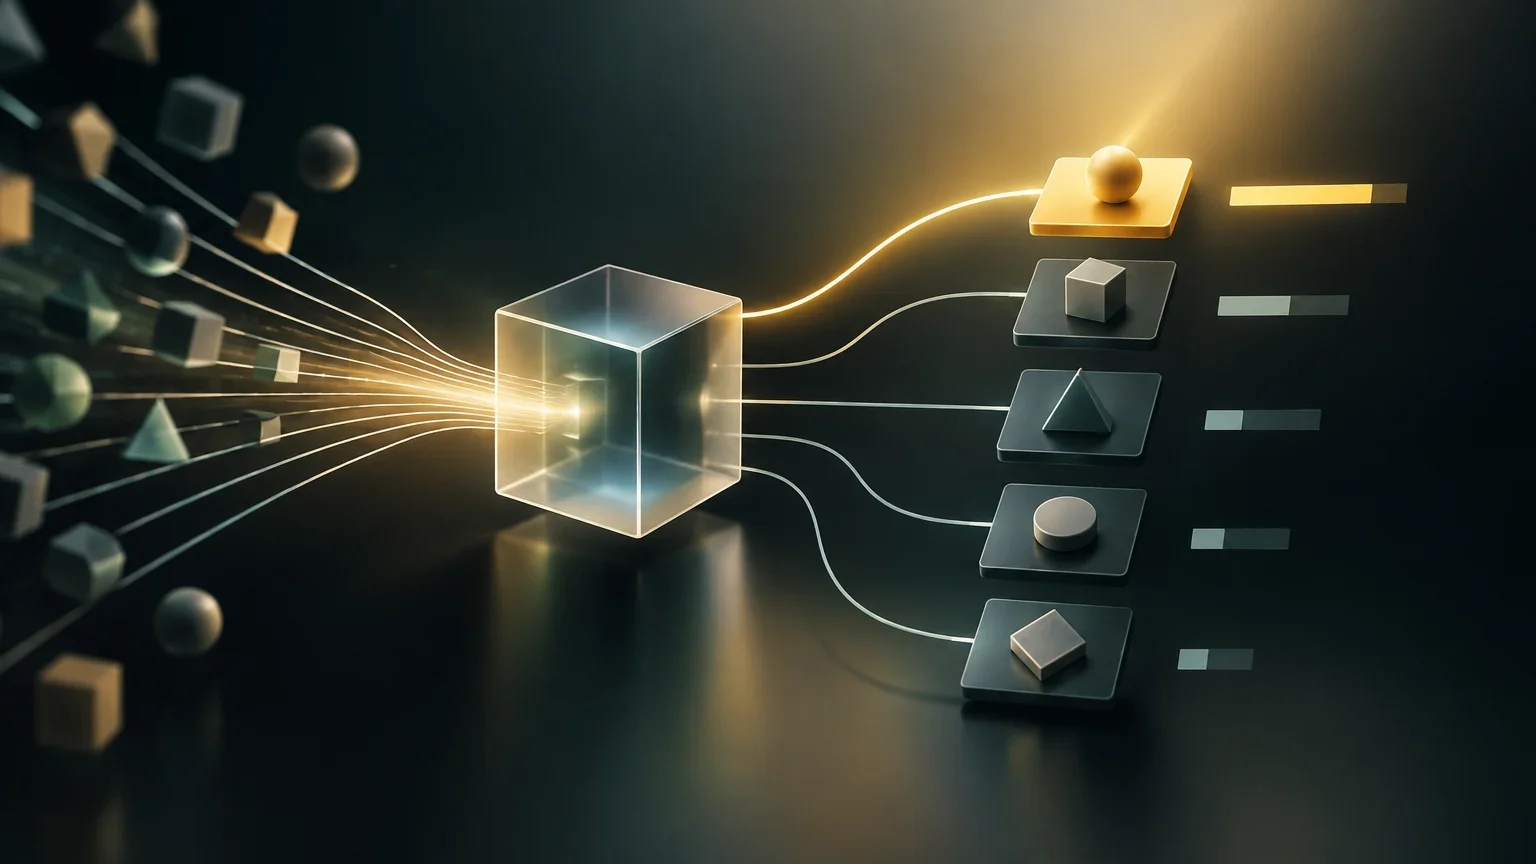
Microsoft presenta Decision-1 como un modelo de puntuación de decisiones. En lugar de responder necesariamente con un texto abierto, recibe una situación, una pregunta y un conjunto fijo de respuestas posibles, y devuelve probabilidades asociadas a esas opciones. Esa es la característica central que recoge la ficha del modelo en el catálogo de Microsoft.
La diferencia puede parecer pequeña, pero cambia el tipo de tarea al que se orienta el sistema. Un modelo generativo suele producir una respuesta en lenguaje natural; uno de puntuación compara alternativas que ya han sido definidas y ayuda a determinar cuál resulta más probable o adecuada dentro de ese conjunto. No significa que el modelo tome decisiones por sí solo ni que sus probabilidades sean garantías de acierto.
La información disponible no permite confirmar todos los detalles que suelen acompañar a un lanzamiento: condiciones de acceso, licencia, restricciones de uso, disponibilidad por región o configuración, ni resultados reproducibles de evaluación. Tampoco basta para verificar la arquitectura o el modelo base. Por tanto, conviene distinguir la descripción funcional que sí aparece en el catálogo de las afirmaciones sobre rendimiento que requieren documentación adicional.
Puntuar opciones no es lo mismo que redactar una respuesta
En una interacción abierta, se puede pedir a un modelo que explique cómo clasificar una solicitud y recibir una justificación extensa. Esa respuesta puede ser útil para una persona, pero una aplicación automatizada tendrá que interpretar el texto, extraer una etiqueta y gestionar posibles variaciones en el formato. Cuando las opciones están fijadas de antemano, la salida probabilística puede encajar de forma más directa en una regla posterior: escoger una categoría, enviar un caso a revisión o seleccionar una herramienta.
La palabra «probabilidad» también merece cuidado. Un valor asociado a una opción es una señal cuantitativa, no una certificación de que el resultado vaya a ser correcto. Para emplearlo con seguridad habría que saber cómo se calibró, en qué datos se evaluó y si esa calibración se mantiene en el contexto real de uso. La descripción del catálogo habla de probabilidades calibradas, pero la información aportada no detalla el procedimiento ni ofrece resultados independientes para juzgarlo.
El conjunto de respuestas limita además el alcance de la decisión. Si ninguna alternativa representa bien el caso, el sistema podría verse obligado a puntuar opciones inadecuadas. Un flujo sólido debería contemplar una salida de «ninguna», una vía de escalado o una revisión humana cuando las probabilidades sean próximas o insuficientes. No se puede dar por hecho que Decision-1 incluya esos mecanismos: serían decisiones de diseño del sistema que lo integra, salvo que la documentación del modelo confirme lo contrario.
Dos patrones de interacción
| Aspecto | Generación de texto libre | Puntuación de opciones |
|---|---|---|
| Salida habitual | Texto redactado para una instrucción abierta | Probabilidades asociadas a alternativas fijadas |
| Uso en una aplicación | Puede requerir interpretar o validar el texto | Puede alimentar una selección o regla posterior |
| Riesgo que debe controlarse | Formato variable o respuesta difícil de convertir en acción | Opciones incompletas y confianza mal interpretada |
| Qué no garantiza | Que la explicación sea correcta | Que la opción con mayor puntuación sea siempre correcta |
Dónde podría encajar en un flujo con agentes
Un agente de software suele combinar varias operaciones: recibe una solicitud, clasifica el trabajo, decide qué herramienta utilizar y comprueba si el resultado cumple ciertos criterios. Un modelo que puntúa alternativas puede ser útil en los puntos donde el sistema ya conoce las opciones válidas. Por ejemplo, podría ayudar a elegir entre categorías de una cola de soporte o entre herramientas disponibles, siempre que la aplicación defina las alternativas, valide la salida y gestione los casos dudosos.
Estos son posibles patrones de diseño, no resultados demostrados para Decision-1 en las fuentes disponibles. El catálogo describe el formato de puntuación, pero no acredita que el modelo alcance una tasa determinada de acierto en enrutamiento, priorización, verificación o cualquier otro escenario concreto. La utilidad dependerá de la calidad de las opciones, de la información suministrada y de la evaluación en el entorno de destino.
La documentación general de Microsoft sobre selección de modelos para agentes ofrece contexto para pensar en la elección de modelos según la tarea. No constituye, sin embargo, una evaluación de Decision-1 ni prueba que resulte superior a otros modelos. Para una decisión de compra o de arquitectura, esa distinción importa: una guía general ayuda a estructurar preguntas, mientras que una evaluación del producto debe aportar datos específicos y comparables.
Qué hacer con las cifras de precisión y latencia
La propuesta del anuncio alude a un conjunto de 36 pruebas, una cifra de precisión y una latencia de 85 milisegundos. Los materiales verificables aportados aquí no permiten comprobar cómo se construyeron esas pruebas, qué modelos se compararon, qué umbral definió un acierto ni si los resultados se calcularon sobre las mismas tareas y condiciones. Por eso, esas cifras no deben tratarse como rendimiento general confirmado.
Una evaluación útil tendría que describir el conjunto de datos, las instrucciones, el número y tipo de opciones, el procedimiento de puntuación y la forma de agregar los resultados. También debería aclarar si las pruebas son representativas de aplicaciones reales, si hubo separación entre datos de desarrollo y evaluación, y cómo se comporta el modelo cuando la respuesta correcta no está entre las alternativas. Sin esa información, un número de precisión aislado no permite estimar el rendimiento en una organización concreta.
La latencia tampoco se puede interpretar sin contexto. Para valorar 85 milisegundos habría que conocer, entre otros factores, el hardware, la ubicación de la medición, el tamaño de la entrada, el número de opciones, el nivel de concurrencia y si se incluye el tiempo de red. Un resultado medido en condiciones controladas no necesariamente equivale al tiempo observado por una aplicación en producción. La ficha consultada no aporta los detalles necesarios para confirmar que la cifra sea comparable con las de otros modelos.
Lista mínima para evaluar una afirmación de rendimiento
- 01Solicitar la descripción del conjunto de pruebas, sus tareas y el criterio exacto de acierto.
- 02Comprobar qué alternativas se presentaron y cómo se trataron los casos sin una respuesta válida.
- 03Revisar si los modelos comparados recibieron las mismas entradas y se evaluaron con el mismo procedimiento.
- 04Para la latencia, identificar hardware, concurrencia, tamaño de entrada y qué intervalos de tiempo se midieron.
- 05Repetir la prueba con ejemplos propios y separar el resultado del laboratorio del comportamiento en producción.
Acceso, licencia y comparaciones: preguntas todavía abiertas
No se puede confirmar con la documentación aportada si Decision-1 está disponible en Microsoft Foundry, en OpenRouter o en ambos, ni bajo qué condiciones. Tampoco se han verificado una licencia, límites de uso, opciones de salida concretas o requisitos de despliegue. La presencia de una ficha en un catálogo es evidencia de que Microsoft describe allí el modelo; por sí sola no resuelve estas condiciones operativas.
Tampoco hay evaluaciones independientes verificadas que permitan comparar Decision-1 con modelos alternativos en una misma tarea. La documentación general sobre selección de modelos para agentes puede orientar una evaluación, pero no sustituye las pruebas de rendimiento comparables. Antes de incorporarlo a un flujo sensible, conviene medir tanto la calidad de la decisión como los efectos de los errores: una mala etiqueta que retrasa un trámite puede tener consecuencias distintas de una recomendación que una persona revisa.
Para seguir las novedades relacionadas, el índice de noticias permite consultar la cobertura editorial, y las secciones de comparación y descubrimiento pueden servir para organizar alternativas y explorar herramientas. Ninguna de esas vías sustituye la revisión de documentación de producto ni una prueba propia. La conclusión prudente, por ahora, es concreta: Decision-1 se presenta como una opción para puntuar respuestas fijas; su rendimiento, acceso y ventaja frente a otras soluciones necesitan pruebas y documentación más completas.
Qué sigue abierto
- No hay información verificada sobre la metodología, composición o resultados detallados del conjunto de 36 pruebas.
- La precisión atribuida no puede evaluarse sin conocer las tareas, el criterio de acierto y las condiciones de comparación.
- La latencia de 85 milisegundos no está contextualizada con hardware, tamaño de entrada, concurrencia ni método de medición.
- No se han confirmado el modelo base, la licencia, las opciones de salida ni las condiciones de acceso en Microsoft Foundry u OpenRouter.
- No se aportan evaluaciones independientes comparables de Decision-1 frente a otros modelos.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección