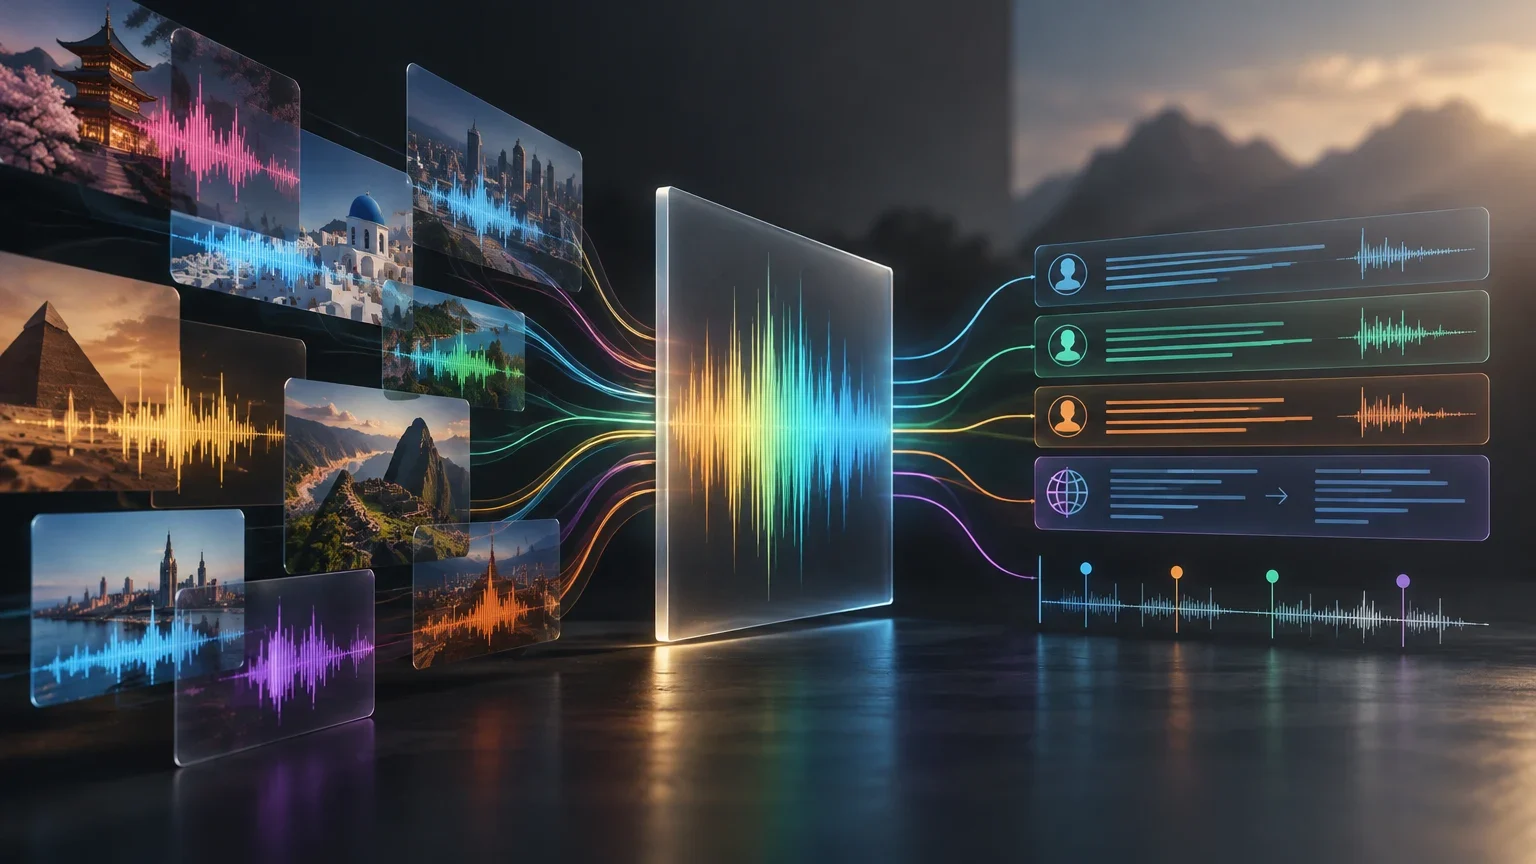
Un modèle conçu pour transcrire des enregistrements audio
NVIDIA présente Nemotron 3.5 Transcribe comme un modèle de reconnaissance vocale qui convertit des enregistrements audio en texte. L’entreprise le décrit comme un modèle à poids ouverts destiné aux développeurs qui créent des outils de transcription, de traduction et de traitement des conversations. Les informations disponibles le situent dans des usages tels que les réunions et la dictée, mais elles ne démontrent ni qu’il convient à tous les environnements professionnels ni qu’il offre les mêmes performances dans toutes les langues.
NVIDIA affirme que le modèle prend en charge la transcription dans jusqu’à 40 langues et la traduction de 31 langues vers l’anglais et depuis l’anglais. Il s’agit de capacités distinctes : la présence d’une langue pour la transcription ne signifie pas nécessairement qu’elle est prise en charge pour toutes les autres fonctions. La couverture linguistique et fonctionnelle peut varier. Une application multilingue doit donc être évaluée avec ses propres enregistrements et les fonctions qu’elle entend utiliser.
Locuteurs, horodatage et consignes
Parmi les fonctions attribuées au modèle figurent l’identification de jusqu’à huit locuteurs et la production d’horodatages mot par mot. L’identification des locuteurs, aussi appelée diarisation, sépare les interventions de différentes voix dans un enregistrement ; elle ne permet pas de reconnaître l’identité réelle des personnes qui parlent. Une étiquette de locuteur peut aider à organiser une conversation, mais ne prouve pas qui est cette personne.
Le modèle est également décrit comme pouvant recevoir des consignes pour orienter la tâche : choisir entre une transcription littérale et une version épurée, fournir des termes spécialisés ou demander une traduction, par exemple. Ces consignes peuvent adapter le résultat à différents objectifs, sans garantir que le modèle les interprète correctement ni qu’il préserve toutes les nuances de l’audio. Pour les noms propres, le jargon et les passages où plusieurs voix se chevauchent, il est utile de confronter le texte à l’enregistrement.
Taille du modèle et paramètres actifs
Les chiffres publiés sur la taille du modèle doivent être interprétés en distinguant les paramètres totaux des paramètres actifs. Dans une architecture à mélange d’experts, tous les composants ne sont pas nécessairement activés à chaque étape de l’inférence. Les descriptions techniques disponibles attribuent à NVIDIA environ 30 milliards de paramètres au total et quelque 4 milliards actifs ; une autre description de l’architecture, qui inclut l’encodeur audio, présente des chiffres supérieurs : 34 milliards au total et 4,3 milliards actifs. Ces quantités correspondent à des composants ou à des périmètres différents et ne doivent pas être confondues avec la taille d’une variante de streaming.
Les informations disponibles ne permettent pas de confirmer, à partir de documentation primaire, la configuration matérielle requise par Nemotron 3.5 Transcribe ni sa consommation de mémoire pour chaque précision numérique ou mode de déploiement. Le nombre de paramètres ne suffit pas non plus à calculer la mémoire nécessaire à l’exécution ou la vitesse : la quantification, le format des poids, la taille des lots et le matériel utilisé ont aussi une incidence.
Interpréter les chiffres de taille
Ces chiffres correspondent à des mesures différentes. Aucun ne permet, à lui seul, de déterminer les performances pratiques ou les ressources nécessaires.
| Mesure | Ce qu’elle représente | Ce qu’elle ne permet pas de conclure à elle seule |
|---|---|---|
| Paramètres totaux | La taille agrégée des composants inclus dans la description. | La mémoire exacte nécessaire pendant l’inférence. |
| Paramètres actifs | La partie activée pour une opération ou un jeton selon l’architecture décrite. | La vitesse réelle sur un matériel donné. |
| Paramètres d’une variante | La taille attribuée à une version ou à un composant spécifique. | Que cette version dispose des mêmes fonctions que le modèle complet. |
Ce que montrent les taux d’erreur
Le taux d’erreur sur les mots, ou WER, compare une transcription à une référence en comptant les substitutions, les omissions et les insertions. Un chiffre plus faible indique moins d’erreurs dans les conditions de l’évaluation concernée, mais ne constitue pas une mesure universelle de la qualité : le résultat dépend des enregistrements, des langues, du bruit, du type de parole et des règles de préparation des données.
Les chiffres disponibles proviennent d’évaluations attribuées à NVIDIA ou de tableaux secondaires consultés en octobre 2026. Une source secondaire rapporte une moyenne de 5,33 % dans l’Open ASR Leaderboard pour des données de test en anglais ; une autre publie 4,71 % pour un résultat en anglais et 4,62 % pour une évaluation multilingue, chiffres attribués à des tests différents. En l’absence de documentation primaire précisant les jeux de données, les versions et la méthode de calcul, ces valeurs ne doivent pas être traitées comme un score unique ni comparées directement. Elles ne prouvent pas non plus que le modèle obtiendra des résultats équivalents dans une langue, avec un accent ou dans un domaine qui n’est pas représenté dans chaque test.
Un benchmark permet d’orienter une comparaison dans des conditions définies. Il ne remplace pas une évaluation avec des enregistrements représentatifs de l’usage réel, notamment en présence de bruit, de vocabulaire spécialisé, d’audio téléphonique ou de plusieurs voix simultanées. Un score mis en avant ne garantit donc pas que le modèle surpasse une autre solution dans une application donnée.
Comparer les modèles pour un usage précis
Pour qu’une évaluation locale soit interprétable, comparez les modèles dans des conditions cohérentes et conservez les résultats par type d’audio, plutôt que de vous limiter à une moyenne générale.
- 01Choisissez des enregistrements représentatifs des langues, des microphones, des niveaux de bruit et du vocabulaire de l’application.
- 02Utilisez les mêmes enregistrements et le même texte de référence pour chaque modèle ; consignez toute normalisation appliquée.
- 03Calculez le WER par langue ou par catégorie et examinez séparément les noms propres, l’attribution des locuteurs et les horodatages.
- 04Comparez également la latence et les ressources consommées sur le matériel cible, sans supposer qu’un score de précision détermine ces résultats.
Accès, licence et limites pratiques
Des sources secondaires décrivent le modèle comme étant à poids ouverts et mentionnent une licence précise, mais la documentation primaire correspondante ne figure pas parmi les sources vérifiées ici. Les éléments disponibles ne permettent donc pas de confirmer la licence applicable, les fichiers disponibles au téléchargement ni les conditions d’utilisation commerciale. Avant de l’intégrer à un produit, les équipes doivent consulter la fiche officielle en vigueur, ses conditions et les exigences de l’environnement prévu.
L’accès aux poids, s’il est disponible selon les conditions attendues, ne dispense pas d’examiner la confidentialité, la sécurité et la qualité. Dans une application médicale ou professionnelle, une transcription peut contenir des informations sensibles et des erreurs importantes. Les étiquettes de locuteur n’identifient pas les personnes, et les réponses générées à partir d’un enregistrement peuvent s’écarter de ce qui a réellement été dit. Tout usage susceptible d’influencer des décisions importantes nécessite des contrôles et une vérification adaptés.
La proposition de NVIDIA s’inscrit dans un domaine plus vaste de systèmes vocaux, qui comprend la reconnaissance automatique de la parole et la génération vocale. La page institutionnelle de l’entreprise décrit ces composants de manière générale, mais ne constitue pas une évaluation spécifique de Nemotron 3.5 Transcribe. Pour choisir un outil, il est important de distinguer la transcription audio, la traduction, la diarisation et le traitement en temps réel : ces fonctions sont liées, mais ne sont pas interchangeables.
Points à vérifier avant d’intégrer un modèle
L’évaluation doit couvrir la tâche technique ainsi que les conditions de déploiement.
| Aspect | Points à vérifier |
|---|---|
| Couverture | La disponibilité de la langue et de la fonction concernées dans la version envisagée. |
| Qualité | Les erreurs de mots, les noms propres, le vocabulaire spécialisé et l’attribution des locuteurs dans vos propres enregistrements. |
| Exploitation | La compatibilité matérielle, la latence, la mémoire et le volume de traitement prévus. |
| Conditions d’utilisation | La licence en vigueur, la provenance des poids et les obligations applicables au produit. |
| Risques et confidentialité | Le traitement des enregistrements sensibles, la vérification humaine et les conséquences d’erreurs dans le contexte d’utilisation. |
Ce que l’on peut conclure à ce stade
Nemotron 3.5 Transcribe est présenté comme une solution de transcription d’enregistrements audio dans plusieurs langues, avec des fonctions telles que la traduction, l’horodatage et l’identification des locuteurs. Cette combinaison peut intéresser les développeurs qui souhaitent explorer un flux de traitement vocal couvrant plusieurs tâches, mais les fonctionnalités annoncées ne suffisent pas à prédire sa précision dans une mise en œuvre particulière.
Les chiffres publics disponibles décrivent des évaluations spécifiques et ne fournissent pas, à eux seuls, une comparaison complète et reproductible pour toutes les langues et tous les scénarios. Les sources primaires vérifiées ici ne confirment pas non plus le détail de la licence, les poids téléchargeables ou le matériel requis. Pour prendre une décision, il faut distinguer ce que le modèle est annoncé comme capable de faire de ce qu’un essai local démontre avec les données et les contraintes réelles de chaque application.
Questions ouvertes
- Les sources vérifiées ne comprennent pas de documentation primaire propre au modèle permettant de confirmer la licence en vigueur et les conditions d’utilisation des poids.
- Les éléments disponibles ne précisent pas quelles langues et tâches ont été validées dans chaque évaluation ni les performances de la diarisation lorsque les voix se chevauchent.
- Les pourcentages de WER cités correspondent à des tests décrits différemment ; les sources disponibles ne permettent pas d’harmoniser les jeux de données, les versions et les méthodes pour les comparer directement.
- Le matériel minimal, la consommation mémoire et les performances d’inférence pour des configurations précises ne sont pas confirmés.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction