Um modelo para transcrever áudio gravado
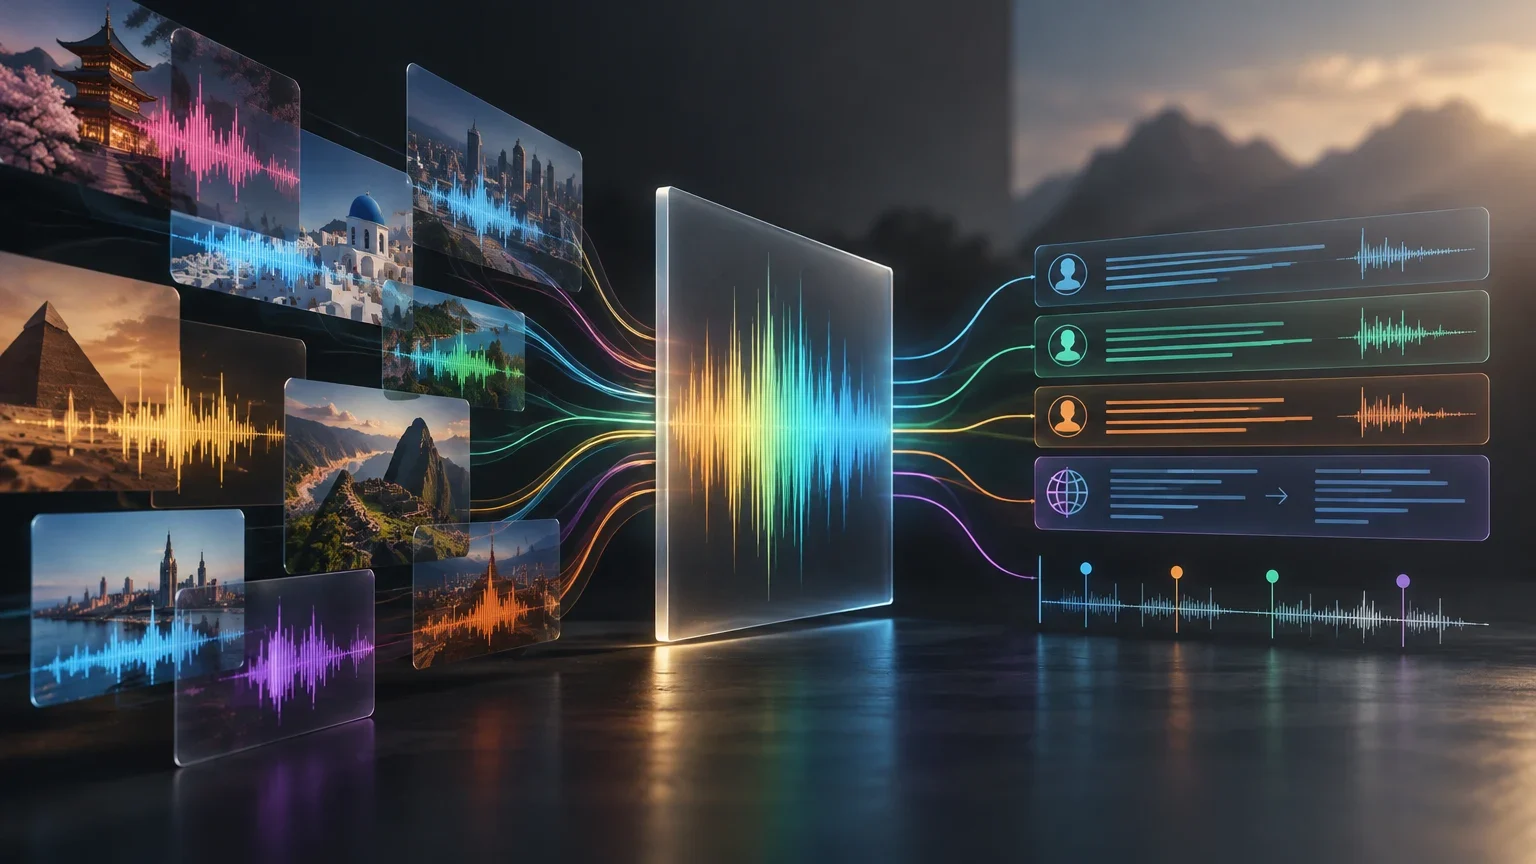
A NVIDIA apresentou o Nemotron 3.5 Transcribe como um modelo de reconhecimento de fala que converte áudio gravado em texto. A empresa o descreve como um modelo de pesos abertos voltado a desenvolvedores que criam ferramentas de transcrição, tradução e processamento de conversas. As informações disponíveis apontam para tarefas como reuniões e ditado, mas não demonstram que o modelo seja adequado a qualquer ambiente profissional nem que tenha o mesmo desempenho em todos os idiomas.
A NVIDIA afirma que o modelo oferece transcrição em até 40 idiomas e tradução de 31 idiomas para o inglês e do inglês para esses idiomas. São capacidades diferentes: a inclusão de um idioma na função de transcrição não significa necessariamente que ele esteja disponível para todas as demais funções. A cobertura de idiomas e tarefas pode variar; por isso, uma aplicação multilíngue precisa ser testada com os próprios áudios e com as funções que serão usadas.
Falantes, marcações temporais e instruções
Entre as funções atribuídas ao modelo estão a identificação de até oito falantes e a geração de marcações temporais por palavra. A identificação de falantes, também chamada diarização, separa as intervenções de diferentes vozes dentro de uma gravação; não equivale a reconhecer a identidade real de quem está falando. Um rótulo de falante pode ajudar a organizar uma conversa, mas não prova quem é aquela pessoa.
Também é descrito o uso de instruções para orientar a tarefa, por exemplo, escolher entre uma transcrição literal ou uma versão mais limpa, indicar termos especializados ou solicitar uma tradução. Isso permite adaptar a saída a diferentes objetivos, mas não garante que o modelo interprete corretamente cada instrução nem que preserve todos os detalhes do áudio. Em nomes próprios, jargões e trechos com vozes sobrepostas, é recomendável conferir o texto com a gravação.
Tamanho do modelo e parâmetros ativos
Os números publicados sobre o tamanho precisam ser distinguidos entre parâmetros totais e parâmetros ativos. Em uma arquitetura de mistura de especialistas, nem todos os componentes necessariamente são ativados em cada etapa da inferência. As informações técnicas disponíveis atribuem à NVIDIA cerca de 30 bilhões de parâmetros totais e aproximadamente 4 bilhões ativos; outra descrição da arquitetura inclui o codificador de áudio e apresenta números maiores: 34 bilhões no total e 4,3 bilhões ativos. Essas quantidades descrevem componentes ou escopos diferentes e não devem ser confundidas com o tamanho de uma variante de streaming.
As informações disponíveis não confirmam, por documentação primária específica, qual configuração de hardware o Nemotron 3.5 Transcribe exige nem os requisitos de memória para cada precisão numérica ou forma de implantação. O número de parâmetros, por si só, também não basta para calcular a memória de execução ou a velocidade: a quantização, o formato dos pesos, o tamanho dos lotes e o hardware utilizado influenciam esses resultados.
Como interpretar os números de tamanho
Os números representam medidas diferentes; nenhum deles, isoladamente, determina o desempenho prático ou os recursos necessários.
| Medida | O que representa | O que não permite concluir por si só |
|---|---|---|
| Parâmetros totais | O tamanho agregado dos componentes incluídos na descrição. | A memória exata necessária durante a inferência. |
| Parâmetros ativos | A parte ativada para uma operação ou um token, de acordo com a arquitetura descrita. | A velocidade real em um hardware específico. |
| Parâmetros de uma variante | O tamanho atribuído a uma versão ou componente específico. | Que essa versão tenha as mesmas funções do modelo completo. |
O que mostram as taxas de erro
A taxa de erro de palavras, ou WER, compara uma transcrição com um texto de referência e contabiliza substituições, omissões e inserções. Um número menor indica menos erros nas condições daquela avaliação, mas não é uma medida universal de qualidade: o resultado depende dos conjuntos de áudio, dos idiomas, do ruído, do tipo de fala e das regras de preparação dos dados.
Os números disponíveis vêm de comparações e avaliações atribuídas à NVIDIA ou de tabelas secundárias consultadas em outubro de 2026. Uma fonte secundária registra uma média de 5,33% no Open ASR Leaderboard para áudio de teste em inglês; outra publica 4,71% para um resultado em inglês e 4,62% em uma avaliação multilíngue, atribuídos a testes diferentes. Sem documentação primária que esclareça os conjuntos, as versões e o método de cálculo, não é apropriado tratar esses valores como uma única pontuação nem compará-los diretamente. Eles tampouco comprovam resultados equivalentes para um idioma, sotaque ou domínio que não esteja representado em cada teste.
Um benchmark ajuda a orientar uma comparação em condições definidas. Não substitui a avaliação com gravações de uso real, sobretudo quando há ruído, vocabulário especializado, áudio telefônico ou várias vozes simultâneas. Portanto, um número destacado não garante que o modelo supere outra alternativa em uma aplicação específica.
Uma comparação útil para um caso de uso
Para que uma avaliação própria seja interpretável, compare os modelos em condições consistentes e mantenha os resultados separados por tipo de áudio, em vez de considerar apenas uma média geral.
- 01Escolha gravações representativas dos idiomas, microfones, níveis de ruído e vocabulário que a aplicação utilizará.
- 02Use as mesmas gravações e o mesmo texto de referência para cada modelo; registre qualquer normalização aplicada.
- 03Calcule o WER por idioma ou categoria e examine separadamente nomes próprios, atribuição de falantes e marcações temporais.
- 04Compare também a latência e os recursos utilizados no hardware de destino, sem presumir que uma pontuação de precisão determine esses resultados.
Acesso, licença e limites práticos
As fontes secundárias descrevem o modelo como de pesos abertos e mencionam uma licença específica, mas a documentação primária correspondente não está entre as fontes verificadas aqui. Portanto, não é possível confirmar com este material qual licença se aplica, quais artefatos estão disponíveis para download ou quais são as condições de uso comercial. Antes de integrá-lo a um produto, quem for implantá-lo deve consultar a ficha oficial vigente, os termos e os requisitos do ambiente previsto.
O acesso aos pesos, se estiver disponível nas condições esperadas, não elimina a necessidade de avaliar privacidade, segurança e qualidade. Em uma aplicação médica ou empresarial, uma transcrição pode conter informações sensíveis e erros relevantes. Os rótulos de falante não identificam pessoas, e respostas geradas sobre o conteúdo de uma gravação podem divergir do que realmente foi dito. Qualquer uso que afete decisões importantes exige controles e revisão adequados.
A proposta da NVIDIA faz parte de um campo mais amplo de sistemas de voz, que inclui reconhecimento automático de fala e geração de voz. A página institucional da empresa explica esses componentes em termos gerais, mas não constitui uma avaliação específica do Nemotron 3.5 Transcribe. Na escolha de uma ferramenta, é importante distinguir transcrição de áudio, tradução, diarização e processamento em tempo real: são funções relacionadas, mas não intercambiáveis.
O que verificar antes de integrar um modelo
A avaliação deve cobrir tanto a tarefa técnica quanto as condições de implantação.
| Aspecto | O que verificar |
|---|---|
| Cobertura | Se o idioma e a função específica estão disponíveis na versão que será usada. |
| Qualidade | Erros em palavras, nomes próprios, vocabulário especializado e atribuição de falantes em áudios próprios. |
| Operação | Compatibilidade com o hardware, latência, memória e volume de processamento esperados. |
| Condições de uso | Licença vigente, procedência dos pesos e obrigações aplicáveis ao produto. |
| Risco e privacidade | Tratamento de gravações sensíveis, revisão humana e consequências de erros no contexto de uso. |
O que é possível concluir por enquanto
O Nemotron 3.5 Transcribe é apresentado como uma opção para transcrever áudio gravado em vários idiomas e reunir funções como tradução, marcações temporais e identificação de falantes. Essa combinação pode ser útil a desenvolvedores que queiram explorar um fluxo de voz com várias tarefas, mas as funções anunciadas não bastam para prever a precisão em uma implantação específica.
Os números públicos disponíveis descrevem avaliações particulares e, por si só, não oferecem uma comparação completa e reproduzível em todos os idiomas e cenários. O material verificado aqui também não confirma os detalhes primários da licença, os pesos disponíveis para download ou o hardware necessário. Uma decisão criteriosa separa o que o modelo declara fazer daquilo que um teste local demonstra com os dados e as restrições reais de cada aplicação.
Questões em aberto
- As fontes verificadas não incluem documentação primária específica do modelo que confirme a licença vigente e as condições de uso dos pesos.
- Não está estabelecido, com evidência primária, quais idiomas e tarefas foram validados em cada avaliação nem como funciona a diarização com vozes sobrepostas.
- Os percentuais de WER citados correspondem a testes descritos de maneiras diferentes; as fontes disponíveis não permitem harmonizar conjuntos, versões e métodos para compará-los diretamente.
- Não estão confirmados o hardware mínimo, o consumo de memória nem o desempenho de inferência em configurações específicas.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção