Définition en une phrase
Operación que pondera qué partes de una entrada resultan más relevantes al construir cada representación o salida.
Définition opérationnelle : l’attention comme interaction entre représentations
En apprentissage automatique, l’attention est une opération qui calcule quelles représentations d’une séquence doivent contribuer à la mise à jour d’une autre représentation. Pour cela, elle compare des éléments au moyen de scores, puis combine les informations qui leur sont associées en leur appliquant des poids dérivés de ces scores. Il s’agit d’un mécanisme informatique au sein d’un réseau neuronal, et non d’une capacité consciente à porter son attention sur quelque chose.
La métaphore de l’attention humaine peut aider à imaginer que le modèle sélectionne des informations pertinentes, mais elle a ses limites. Un réseau ne « regarde » pas une entrée comme le ferait une personne et n’attribue pas nécessairement à chaque mot une importance sémantique stable. Le calcul consiste en transformations de vecteurs et en opérations mathématiques. Son rôle précis dépend de l’architecture, des données, de la couche, de la tête et de la tâche.
Dans un Transformer, le mécanisme permet aux représentations de différents éléments de l’entrée d’interagir. Un élément peut intégrer des informations provenant d’autres éléments autorisés par l’architecture et ses masques. L’attention ne remplace pas l’ensemble du traitement effectué par le réseau : elle s’inscrit dans un système qui peut également comprendre des projections, des connexions résiduelles, une normalisation et des réseaux de transformation.
Comment le calcul fonctionne : requêtes, clés et valeurs
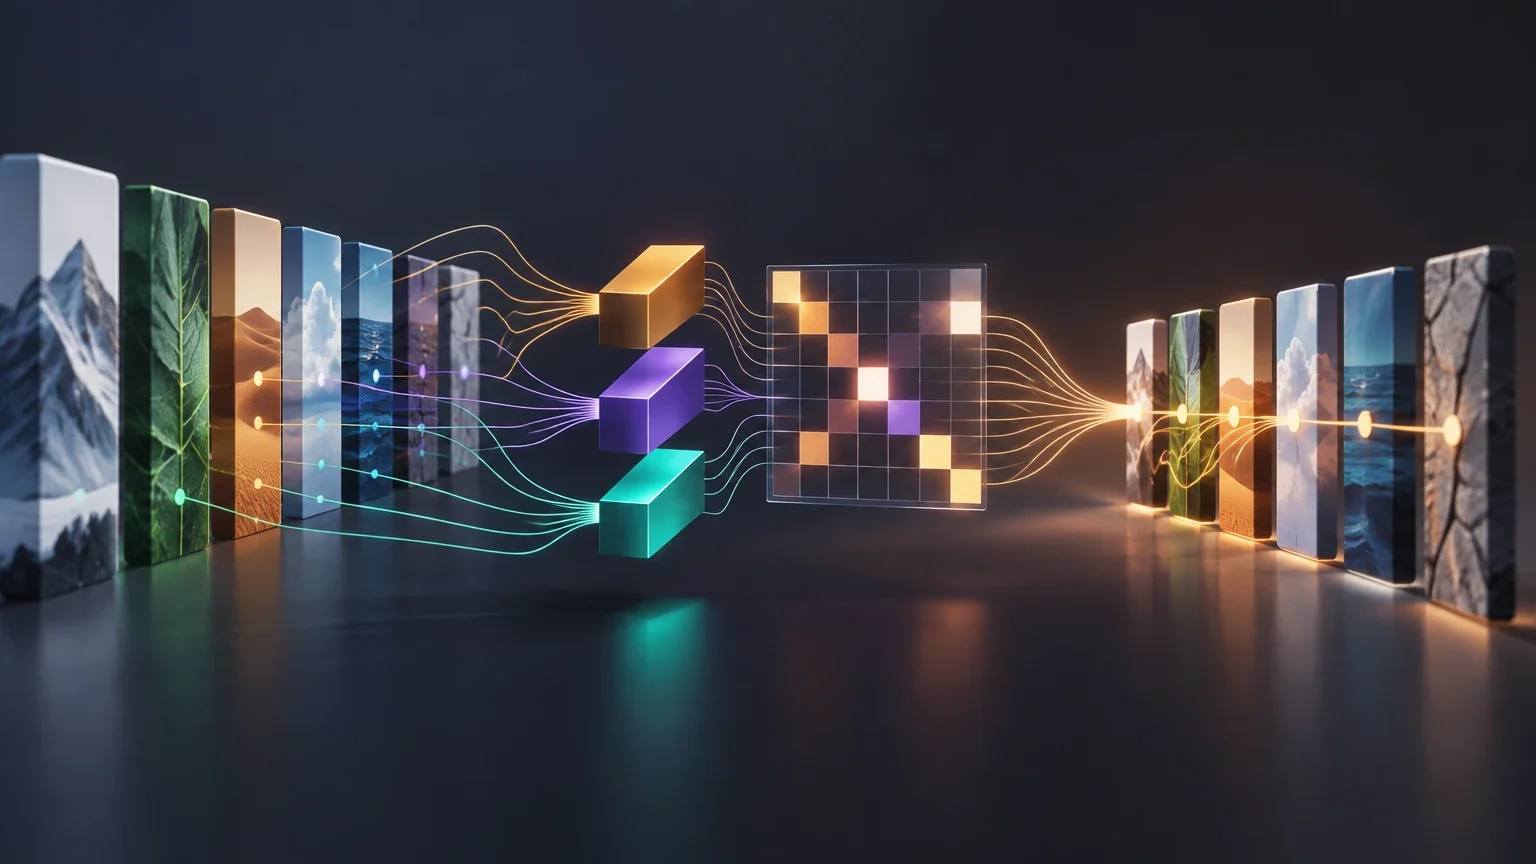
La formulation courante de l’attention par produit scalaire mis à l’échelle utilise trois ensembles de vecteurs : les requêtes (Q), les clés (K) et les valeurs (V). Intuitivement, chaque requête est comparée aux clés disponibles ; les scores obtenus déterminent dans quelle mesure chaque valeur contribue à la représentation mise à jour. Q, K et V sont généralement produits au moyen de projections apprises à partir des représentations d’entrée.
En notation compacte, le calcul s’écrit ainsi : Attention(Q, K, V) = softmax(QKᵀ / √dₖ)V. On peut lire l’expression étape par étape. D’abord, QKᵀ calcule les produits scalaires entre les requêtes et les clés : plus un score est élevé, plus leur compatibilité est grande selon cette opération. Ensuite, on divise par √dₖ, où dₖ désigne la dimension des clés, afin de mettre les scores à l’échelle. Puis softmax normalise chaque ensemble de scores pour obtenir des poids dont la somme vaut un. Enfin, ces poids sont appliqués à V et servent à combiner ses vecteurs.
La sortie associée à une requête est donc une combinaison pondérée de valeurs. Elle n’est pas nécessairement la copie d’un seul élément : plusieurs valeurs peuvent contribuer dans des proportions différentes. Dans une séquence, les lignes de la matrice des scores correspondent aux requêtes et les colonnes aux clés. Un masque peut exclure certaines positions avant la normalisation des scores, par exemple afin d’empêcher une position d’utiliser des informations futures.
L’équation décrit le cœur du calcul, mais ne définit pas à elle seule tous les détails d’un modèle. La manière de produire Q, K et V, leurs dimensions, les masques utilisés et la façon de combiner les sorties dépendent de l’architecture. Comprendre la formule permet donc de suivre l’opération, mais ne suffit pas à reconstituer le fonctionnement complet d’un système.
Lire la formule étape par étape
- 01Projeter les représentations pour obtenir les requêtes, les clés et les valeurs.
- 02Calculer les scores de compatibilité entre chaque requête et les clés auxquelles elle peut accéder.
- 03Mettre les scores à l’échelle et appliquer softmax pour obtenir des poids normalisés.
- 04Utiliser ces poids pour combiner les valeurs et produire les représentations mises à jour.
Variantes et masques : quelles informations peuvent être mises en relation
Dans l’auto-attention, les requêtes, les clés et les valeurs sont dérivées d’une même séquence de représentations. Les éléments de cette séquence peuvent ainsi interagir entre eux, dans les limites définies par les masques. Dans l’attention croisée, en revanche, les requêtes proviennent d’une séquence ou d’une représentation, tandis que les clés et les valeurs proviennent d’une autre. Cette configuration permet à un composant d’utiliser des informations produites par un autre.
L’attention bidirectionnelle permet à une position de prêter attention à d’autres positions situées de part et d’autre dans la séquence, sous réserve des restrictions imposées par l’implémentation. Dans l’attention causale, un masque bloque l’accès aux positions futures. Dans un modèle autorégressif, cela permet de calculer la prédiction du jeton suivant sans laisser la représentation utiliser des jetons qui ne devraient pas encore être disponibles. Le masque détermine quels scores sont pris en compte ; il ne modifie pas la définition générale de Q, K et V.
Une tête d’attention effectue son propre calcul d’attention. L’attention multi-têtes exécute plusieurs calculs en parallèle, avec des projections différentes, puis en combine les résultats. L’objectif est de permettre au modèle de former plusieurs représentations des interactions. Sans éléments de preuve propres au modèle considéré, il ne faut pas supposer que chaque tête correspond à une fonction sémantique fixe, comme « chercher les sujets » ou « suivre les noms propres ».
Ces distinctions décrivent des choix d’architecture ; elles ne constituent pas, en tous points, des catégories mutuellement exclusives. Par exemple, le décodeur d’une architecture encodeur-décodeur peut employer une auto-attention causale pour sa séquence de sortie et une attention croisée pour consulter les représentations de l’encodeur.
Comparaison des variantes
| Variante | Origine de Q, K et V | Ce qu’elle permet de décrire |
|---|---|---|
| Auto-attention | Q, K et V proviennent de la même séquence. | Les interactions entre les représentations de cette séquence. |
| Attention croisée | Q provient d’une représentation ; K et V en proviennent d’une autre. | L’utilisation d’informations issues d’une séquence ou d’un composant distinct. |
| Causale | Le masque masque les positions futures. | La prédiction sans consultation de jetons ultérieurs qui ne sont pas encore disponibles. |
| Bidirectionnelle | Les positions peuvent être mises en relation dans les deux sens, selon le masque. | La contextualisation à partir des positions antérieures et postérieures autorisées. |
| Multi-têtes | Plusieurs ensembles de projections et plusieurs calculs d’attention. | La combinaison de différentes interactions apprises. |
Trois exemples appliqués à des tâches différentes
En traduction automatique, l’attention peut aider le décodeur à consulter les représentations de la phrase source lorsqu’il produit chaque mot de la traduction. Dans une architecture encodeur-décodeur, les requêtes proviennent des représentations du côté de la sortie, tandis que les clés et les valeurs proviennent des représentations encodées de la phrase source. La relation n’est pas nécessairement une correspondance rigide entre un mot et un autre : le mécanisme peut combiner des informations issues de plusieurs positions.
En génération de texte autorégressive, l’auto-attention causale permet à la représentation d’une position d’utiliser le contexte disponible jusque-là, sans prêter attention aux positions ultérieures. Lors de la génération, le modèle estime une distribution pour le jeton suivant à partir du contexte dont il dispose déjà. Le masque causal constitue une contrainte d’accès aux informations ; il ne signifie pas que chaque jeton antérieur contribue de manière égale, ni que le modèle dispose d’une mémoire illimitée.
En vision par ordinateur, un Transformer de vision peut convertir une image en une séquence de représentations de ses patches, puis la traiter au moyen de couches Transformer. L’auto-attention permet à la représentation d’un patch d’être mise en relation avec celles d’autres patches. C’est une façon de modéliser les interactions entre les régions d’une image. Cela ne signifie pas que chaque tête détecte nécessairement un objet précis, ni que les divisions en patches coïncident toujours avec les limites des objets.
Ces exemples montrent que le mécanisme est général, mais pas que tous les modèles l’utilisent de la même manière. La tâche et l’architecture déterminent quelles séquences sont comparées, quels masques sont appliqués et comment les représentations obtenues sont utilisées.
Ce que montrent les poids et ce qu’ils ne permettent pas de conclure
Les poids d’attention indiquent dans quelle mesure les valeurs contribuent, lors d’une opération précise, à la sortie associée à une requête. Présentés sous forme de carte, ils peuvent aider à examiner les motifs d’une couche, d’une tête, d’une entrée et d’une configuration données. Ce sont des données issues du calcul interne, mais leur interprétation dépend de ce qui est visualisé et de la manière dont cette opération est liée à la prédiction finale.
Il n’est pas juste d’assimiler directement un poids élevé à l’idée que « ce mot est important pour le modèle » au sens humain. La prédiction dépend de nombreuses opérations, et les valeurs peuvent être transformées et combinées au fil des couches et des composants. Une carte d’attention ne constitue pas non plus, à elle seule, une explication causale : observer une distribution ne démontre pas que modifier les positions ayant les poids les plus élevés changerait la réponse, ni que la carte reflète la raison déterminante de la prédiction.
Le débat universitaire sur la capacité de l’attention à servir d’explication ne se résume pas à une réponse positive ou négative. Certains travaux contestent que les poids suffisent à expliquer les prédictions ; d’autres discutent les hypothèses et les critères utilisés pour les évaluer. La conclusion prudente consiste à les traiter comme un signal inspectable d’une opération du modèle, et non comme une explication complète ni comme un élément nécessairement dépourvu d’information.
Pour évaluer une interprétation, il faut poser des questions précises : quelle couche et quelle tête sont observées ? Que signifie le poids dans cette opération ? A-t-on vérifié ce qui se passe lorsqu’on modifie ou supprime les informations indiquées ? La conclusion se reproduit-elle sur d’autres entrées ? Une visualisation peut orienter l’analyse, mais elle ne remplace ni les tests de comportement ni une justification causale.
Coût de calcul et optimisations de mise en œuvre
Dans l’attention dense standard, chaque position peut être comparée à toutes les autres positions autorisées de la séquence. Le nombre d’interactions croît donc de façon quadratique avec la longueur de la séquence : si cette longueur double, la matrice des scores contient environ quatre fois plus d’éléments, avant même de tenir compte des masques ou des variantes. Le coût de calcul et le stockage des résultats intermédiaires sont liés, mais ce sont deux aspects distincts.
La complexité quadratique décrit le calcul dense standard, et non toutes les architectures ou toutes les implémentations possibles. Les masques peuvent limiter les interactions, et certaines variantes sont conçues pour traiter les longues séquences autrement. Avant d’appliquer une estimation de coût à un système concret, il est donc utile de déterminer quel type d’attention et quel algorithme sont étudiés.
FlashAttention est une optimisation de mise en œuvre qui tient compte du mouvement des données entre les différents niveaux de mémoire. Elle réorganise le calcul afin de réduire les transferts et l’utilisation de la mémoire intermédiaire, tout en conservant l’opération exacte d’attention qu’elle implémente, au lieu de la remplacer par une autre approximation de l’attention. Le fait que le calcul mathématique soit exact ne signifie pas que toutes les implémentations aient les mêmes performances, les mêmes exigences ou la même empreinte mémoire.
Distinguer opération, coût et mise en œuvre
| Aspect | Ce qu’il décrit | Question utile |
|---|---|---|
| Opération d’attention | Les scores, leur normalisation et la combinaison pondérée. | Quels Q, K, V et quel masque le modèle utilise-t-il ? |
| Complexité de l’attention dense standard | Le nombre d’interactions et de résultats intermédiaires lorsque la séquence s’allonge. | S’agit-il d’une attention dense, et quelle longueur de séquence est traitée ? |
| Optimisation de mise en œuvre | L’organisation du calcul et des accès à la mémoire. | L’opération est-elle conservée ou approchée d’une autre manière ? |
Concepts associés et erreurs fréquentes
L’attention est souvent étudiée avec le Transformer, car ce mécanisme est un composant central de cette architecture, ainsi qu’avec le jeton, car dans les modèles de texte, les positions de la séquence correspondent généralement à des jetons. Un jeton n’est pas nécessairement un mot entier. Les représentations vectorielles qui entrent dans le calcul sont liées aux plongements, tandis que la fenêtre de contexte limite le nombre d’éléments qu’un modèle peut traiter ou avoir à sa disposition dans une configuration donnée.
Dans les systèmes multimodaux, différentes modalités peuvent être représentées par des séquences ou des représentations distinctes. L’attention croisée offre un moyen de les relier lorsque l’architecture fait provenir les requêtes d’une représentation, et les clés et valeurs d’une autre. Sans détails sur le système considéré, mieux vaut ne pas supposer que tous les modèles multimodaux utilisent le même schéma, ni que leurs poids révèlent à eux seuls une correspondance interprétable entre les modalités.
Parmi les erreurs fréquentes, on trouve le fait d’assimiler l’« attention » à la conscience du modèle, d’interpréter les poids comme des probabilités d’importance humaine, de supposer que toutes les têtes ont des fonctions sémantiques évidentes, de confondre l’attention croisée avec l’auto-attention et d’attribuer au masque causal une capacité de mémoire. On confond aussi parfois une optimisation plus efficace avec une modification de la définition mathématique, alors qu’il s’agit de niveaux de description différents.
Repères pratiques pour interpréter une explication de l’attention
Lorsqu’on lit un diagramme ou une carte, il faut d’abord déterminer quelle opération elle représente : auto-attention ou attention croisée ; causale ou bidirectionnelle ; à une tête ou à plusieurs têtes. Vérifiez quelles positions peuvent être consultées et si un masque a été appliqué. Distinguez ensuite les scores avant softmax des poids normalisés et de la combinaison finale des valeurs : ce ne sont pas les mêmes objets.
Demandez-vous ensuite quelle conclusion on cherche à tirer. Si l’affirmation se limite à dire qu’une position a reçu un certain poids au cours d’une opération donnée, la carte peut décrire ce calcul. Si l’on affirme que cette position a causé la prédiction ou qu’elle en fournit une explication fidèle, des preuves supplémentaires sont nécessaires, par exemple des évaluations de sensibilité ou des interventions pertinentes. Un graphique isolé ne permet pas de trancher ces questions.
Enfin, vérifiez la portée de toute affirmation concernant le coût ou l’efficacité. Cherchez à savoir si elle porte sur l’attention dense standard, une variante ou une implémentation optimisée. Pour approfondir, consultez les entrées du glossaire consacrées au Transformer, au jeton, à la fenêtre de contexte et à la multimodalité, ainsi que celle sur l’attention. Ces liens conceptuels aident à situer le mécanisme dans le modèle sans confondre ses composants, les limites de l’entrée et les modes de traitement.
Liste de vérification rapide
- 01Identifiez Q, K et V, ainsi que la séquence dont chacun provient.
- 02Vérifiez le masque et les positions auxquelles l’attention peut accéder.
- 03Distinguez les poids observés des interprétations portant sur l’importance ou la causalité.
- 04Demandez des preuves supplémentaires si la carte est présentée comme une explication d’une prédiction.
- 05Distinguez la complexité de l’opération de l’efficacité de sa mise en œuvre.