Definizione in una frase
Operación que pondera qué partes de una entrada resultan más relevantes al construir cada representación o salida.
Definizione operativa: l’attenzione come interazione tra rappresentazioni
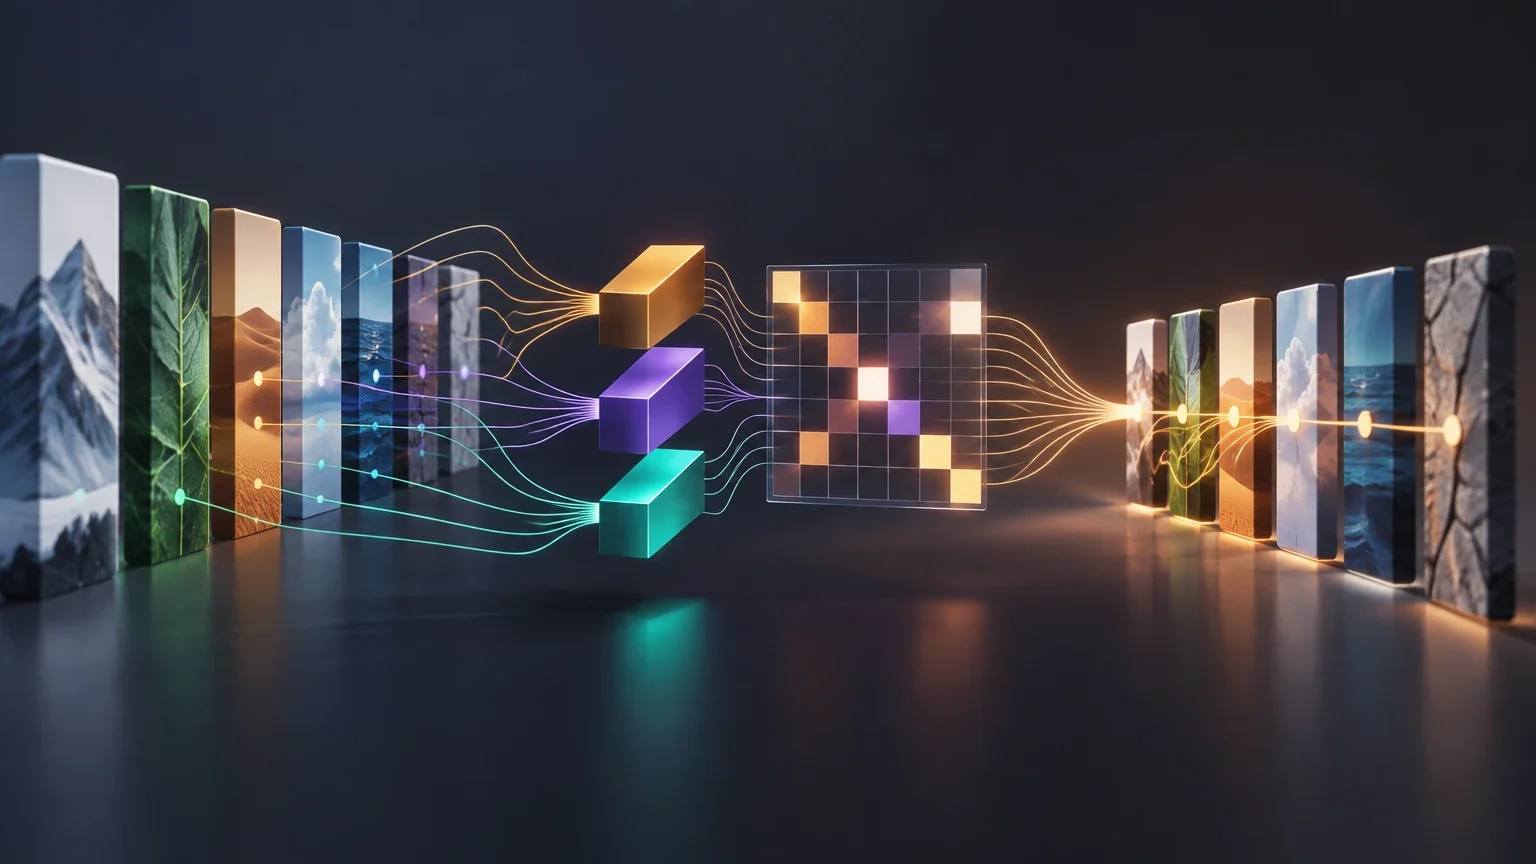
Nel machine learning, l’attenzione è un’operazione che calcola quali rappresentazioni di una sequenza devono contribuire ad aggiornare un’altra rappresentazione. A questo scopo, confronta gli elementi mediante punteggi e combina le informazioni a essi associate usando pesi ricavati da quei punteggi. È un meccanismo computazionale di una rete neurale, non una capacità cosciente di concentrarsi su qualcosa.
La metafora dell’attenzione umana può aiutare a immaginare che il modello selezioni informazioni pertinenti, ma ha dei limiti. Una rete non «guarda» un input come farebbe una persona e non assegna necessariamente a ogni parola un’importanza semantica stabile. Il calcolo consiste in trasformazioni di vettori e operazioni matematiche. La funzione concreta dipende dall’architettura, dai dati, dal livello, dalla testa di attenzione e dal compito.
In un Transformer, il meccanismo permette alle rappresentazioni di elementi diversi dell’input di interagire. Un elemento può incorporare informazioni provenienti da altri elementi consentiti dall’architettura e dalle relative maschere. L’attenzione non sostituisce l’intera elaborazione della rete: è una sua componente, insieme a proiezioni, connessioni residue, normalizzazione e reti di trasformazione.
Come si calcola: query, chiavi e valori
La formulazione più comune dell’attenzione a prodotto scalare scalato utilizza tre insiemi di vettori: query (Q), chiavi (K) e valori (V). In termini intuitivi, ogni query viene confrontata con le chiavi disponibili; i punteggi ottenuti determinano quanto ciascun valore contribuisce alla rappresentazione aggiornata. Di solito Q, K e V si ottengono mediante proiezioni apprese delle rappresentazioni in input.
In notazione compatta, il calcolo è: Attention(Q, K, V) = softmax(QKᵀ / √dₖ)V. L’espressione si può leggere per fasi. Per prima cosa, QKᵀ calcola i prodotti scalari tra query e chiavi: secondo questa operazione, un punteggio più alto indica una compatibilità maggiore. Poi i punteggi vengono divisi per √dₖ, dove dₖ è la dimensione delle chiavi, così da scalarli. In seguito, softmax normalizza ciascun insieme di punteggi in pesi la cui somma è uno. Infine, i pesi vengono applicati a V e i relativi vettori vengono combinati.
L’output di una query è quindi una combinazione ponderata di valori. Non è necessariamente la copia di un singolo elemento: più valori possono contribuire in proporzioni diverse. In una sequenza, le righe della matrice dei punteggi corrispondono alle query e le colonne alle chiavi. Una maschera può escludere alcune posizioni prima della normalizzazione dei punteggi, per esempio per impedire a una posizione di usare informazioni future.
L’equazione descrive il calcolo centrale, ma non determina da sola tutti i dettagli di un modello. Il modo in cui si producono Q, K e V, le dimensioni, le maschere e la combinazione degli output dipendono dall’architettura. Comprendere la formula permette quindi di seguire l’operazione, ma non basta a ricostruire il funzionamento completo di un sistema.
Leggere la formula passo per passo
- 01Proiettare le rappresentazioni per ottenere query, chiavi e valori.
- 02Calcolare i punteggi di compatibilità tra ciascuna query e le chiavi consentite.
- 03Scalare i punteggi e applicare softmax per ottenere pesi normalizzati.
- 04Usare i pesi per combinare i valori e produrre rappresentazioni aggiornate.
Varianti e maschere: quali informazioni possono essere messe in relazione
Nell’autoattenzione, query, chiavi e valori derivano dalla stessa sequenza di rappresentazioni. Gli elementi della sequenza possono così interagire tra loro, entro i limiti stabiliti dalle maschere. Nell’attenzione incrociata, invece, le query provengono da una sequenza o rappresentazione, mentre chiavi e valori provengono da un’altra. Questa configurazione consente a un componente di utilizzare informazioni prodotte da un altro.
L’attenzione bidirezionale permette a una posizione di prestare attenzione ad altre posizioni della sequenza su entrambi i lati, fatte salve le restrizioni imposte dall’implementazione. Nell’attenzione causale, una maschera blocca l’accesso alle posizioni future. In un modello autoregressivo, questo consente di calcolare la previsione del token successivo senza che la rappresentazione utilizzi token che non dovrebbero ancora essere disponibili. La maschera controlla quali punteggi partecipano al calcolo; non modifica la definizione generale di Q, K e V.
Una testa di attenzione esegue un proprio calcolo di attenzione. L’attenzione multi-head esegue in parallelo più calcoli, con proiezioni diverse, e ne combina i risultati. L’obiettivo è permettere al modello di formare diverse rappresentazioni delle interazioni. In assenza di prove specifiche, non bisogna presumere che ogni testa corrisponda a una funzione semantica fissa, come «cercare i soggetti» o «seguire i nomi».
Queste distinzioni descrivono scelte architetturali e non sono categorie reciprocamente esclusive sotto ogni aspetto. Per esempio, il decoder di un’architettura encoder-decoder può utilizzare l’autoattenzione causale sulla sequenza di output e l’attenzione incrociata per consultare le rappresentazioni dell’encoder.
Confronto tra varianti
| Variante | Origine di Q, K e V | Che cosa descrive |
|---|---|---|
| Autoattenzione | Q, K e V derivano dalla stessa sequenza. | Interazioni tra rappresentazioni di quella sequenza. |
| Attenzione incrociata | Q deriva da una rappresentazione; K e V da un’altra. | Uso di informazioni provenienti da una sequenza o da un componente diverso. |
| Causale | La maschera nasconde le posizioni future. | Previsione senza consultare token successivi non ancora disponibili. |
| Bidirezionale | Le posizioni possono essere messe in relazione in entrambe le direzioni, secondo la maschera. | Contestualizzazione mediante le posizioni precedenti e successive consentite. |
| Multi-head | Più insiemi di proiezioni e calcoli di attenzione. | Combinazione di diverse interazioni apprese. |
Tre esempi applicati a compiti diversi
Nella traduzione automatica, l’attenzione può aiutare il decoder a consultare le rappresentazioni della frase di origine mentre produce ogni parola della traduzione. In una configurazione encoder-decoder, le query provengono dalla rappresentazione sul lato dell’output, mentre chiavi e valori provengono dalle rappresentazioni codificate della frase sorgente. La relazione non deve necessariamente essere un allineamento rigido da una parola all’altra: il meccanismo può combinare informazioni provenienti da più posizioni.
Nella generazione autoregressiva di testo, l’autoattenzione causale permette alla rappresentazione di una posizione di utilizzare il contesto disponibile fino a quel punto, senza prestare attenzione alle posizioni successive. Durante la generazione, il modello stima una distribuzione per il token seguente a partire dal contesto che ha già a disposizione. La maschera causale è una condizione di accesso alle informazioni; non implica che ogni token precedente contribuisca nella stessa misura, né che il modello disponga di una memoria illimitata.
Nella visione artificiale, un Transformer visivo può convertire un’immagine in una sequenza di rappresentazioni di patch ed elaborarla con livelli Transformer. L’autoattenzione permette alla rappresentazione di una patch di entrare in relazione con quelle delle altre patch. È un modo per modellare le interazioni tra regioni di un’immagine. Non significa che ogni testa rilevi necessariamente un oggetto specifico, né che le suddivisioni in patch coincidano sempre con i confini degli oggetti.
Gli esempi mostrano che il meccanismo è generale, non che tutti i modelli lo utilizzino nello stesso modo. Il compito e l’architettura determinano quali sequenze vengono confrontate, quali maschere si applicano e come vengono utilizzate le rappresentazioni risultanti.
Che cosa mostrano i pesi e che cosa non permettono di concludere
I pesi di attenzione mostrano in che misura, in una specifica operazione, i valori contribuiscono all’output di una query. Se visualizzati come una mappa, possono aiutare a esaminare i pattern di quel livello, di quella testa, di quell’input e di quella configurazione. Sono dati del calcolo interno, ma la loro interpretazione dipende da che cosa si visualizza e da come quell’operazione si collega alla previsione finale.
Non è corretto equiparare automaticamente un peso elevato a «questa parola è importante per il modello» in senso umano. La previsione dipende da molte operazioni, e i valori possono essere trasformati e combinati lungo diversi livelli e componenti. Una mappa di attenzione, da sola, non è neppure una spiegazione causale: osservare una distribuzione non dimostra che modificare le posizioni con pesi elevati cambierebbe la risposta, né che la mappa rifletta la ragione decisiva della previsione.
Il dibattito accademico sulla possibilità che l’attenzione funzioni da spiegazione non si riduce a un sì o a un no. Alcuni studi mettono in dubbio che i pesi siano sufficienti a spiegare le previsioni; altri discutono le ipotesi e i criteri impiegati per valutarli. La conclusione prudente è considerarli un segnale osservabile di un’operazione del modello, non una spiegazione completa né qualcosa che sia necessariamente privo di informazioni.
Per valutare un’interpretazione occorre porsi domande concrete: quale livello e quale testa si stanno osservando? Che cosa rappresenta il peso in quell’operazione? È stato verificato che cosa succede alterando o rimuovendo le informazioni indicate? La conclusione si ripete con altri input? La visualizzazione può orientare l’analisi, ma non sostituisce le prove comportamentali né una giustificazione causale.
Costo computazionale e ottimizzazioni di implementazione
Nell’attenzione densa standard, ogni posizione può essere confrontata con tutte le altre posizioni consentite della sequenza. Il numero di interazioni cresce quindi in modo quadratico rispetto alla lunghezza della sequenza: se la lunghezza raddoppia, la matrice dei punteggi contiene circa quattro volte più elementi, prima di considerare maschere o varianti. Il costo computazionale e l’archiviazione dei risultati intermedi sono aspetti collegati, ma non identici.
La complessità quadratica descrive il calcolo denso standard, non tutte le architetture o implementazioni possibili. Le maschere possono limitare le interazioni ed esistono varianti progettate per gestire le sequenze lunghe in altri modi. Prima di applicare a un sistema concreto un dato relativo ai costi, è quindi opportuno identificare il tipo di attenzione e l’algoritmo in esame.
FlashAttention è un’ottimizzazione di implementazione che tiene conto del movimento dei dati tra i diversi livelli di memoria. Riorganizza il calcolo per ridurre i trasferimenti e l’uso della memoria intermedia, mantenendo esatta l’operazione di attenzione che implementa, invece di sostituirla con un’approssimazione diversa. Il fatto che il calcolo matematico sia esatto non significa che tutte le implementazioni abbiano le stesse prestazioni, gli stessi requisiti o la stessa impronta di memoria.
Distinguere operazione, costo e implementazione
| Aspetto | Che cosa descrive | Domanda utile |
|---|---|---|
| Operazione di attenzione | Punteggi, normalizzazione e combinazione ponderata. | Quali Q, K, V e maschera usa il modello? |
| Complessità standard densa | Numero di interazioni e risultati intermedi al crescere della sequenza. | Si tratta di attenzione densa e quale lunghezza viene elaborata? |
| Ottimizzazione di implementazione | Organizzazione del calcolo e accesso alla memoria. | L’operazione viene mantenuta o approssimata in un altro modo? |
Concetti correlati ed errori frequenti
L’attenzione si studia spesso insieme al Transformer, perché il meccanismo è un componente centrale di questa architettura, e al token, perché nei modelli di testo le posizioni della sequenza corrispondono spesso a token. Un token non è necessariamente una parola completa. Le rappresentazioni vettoriali che entrano nel calcolo sono collegate agli embedding, mentre la finestra di contesto limita quanti elementi un modello può elaborare o avere a disposizione in una determinata configurazione.
Nei sistemi multimodali possono esserci sequenze o rappresentazioni appartenenti a modalità diverse. L’attenzione incrociata offre un modo per metterle in relazione quando l’architettura fa sì che le query provengano da una rappresentazione e le chiavi e i valori da un’altra. Senza dettagli sul sistema specifico, non è opportuno presumere che tutti i modelli multimodali utilizzino lo stesso schema o che i loro pesi rivelino da soli una corrispondenza interpretabile tra modalità.
Tra gli errori frequenti ci sono chiamare «attenzione» la consapevolezza del modello; interpretare i pesi come probabilità di importanza umana; supporre che tutte le teste abbiano funzioni semantiche chiare; confondere l’attenzione incrociata con l’autoattenzione; e attribuire alla maschera causale una capacità di memoria. Spesso si confonde anche un’ottimizzazione più efficiente con una modifica della definizione matematica, benché si tratti di livelli descrittivi distinti.
Criteri pratici per interpretare una spiegazione dell’attenzione
Quando leggi un diagramma o una mappa, identifica prima l’operazione rappresentata: autoattenzione o attenzione incrociata; causale o bidirezionale; a testa singola o multi-head. Verifica quali posizioni possono essere consultate e se è stata applicata una maschera. Poi distingui i punteggi precedenti a softmax dai pesi normalizzati e dalla combinazione finale dei valori: non sono la stessa cosa.
In seguito, chiediti quale conclusione si vuole trarre. Se si afferma soltanto che una posizione ha ricevuto un determinato peso in una specifica operazione, la mappa può descrivere quel calcolo. Se si sostiene che la posizione abbia causato la previsione o che rappresenti una spiegazione fedele, servono prove ulteriori, per esempio valutazioni di sensibilità o interventi pertinenti. Un grafico isolato non risolve queste questioni.
Infine, verifica la portata di qualsiasi affermazione sui costi o sull’efficienza. Accertati se si parla di attenzione densa standard, di una variante o di un’implementazione ottimizzata. Per approfondire, è utile consultare le schede del glossario su Transformer, token, finestra di contesto e multimodalità, oltre alla voce sull’attenzione. Questi collegamenti aiutano a collocare il meccanismo all’interno del modello senza confondere componenti, limiti dell’input e modalità di elaborazione.
Breve lista di controllo
- 01Identifica Q, K e V e la sequenza da cui deriva ciascuno.
- 02Controlla la maschera e le posizioni a cui è consentito prestare attenzione.
- 03Distingui i pesi osservati dalle interpretazioni in termini di importanza o causalità.
- 04Chiedi prove aggiuntive se la mappa viene presentata come spiegazione di una previsione.
- 05Separa la complessità dell’operazione dall’efficienza di una sua implementazione.