Definição numa frase
Operación que pondera qué partes de una entrada resultan más relevantes al construir cada representación o salida.
Definição operacional: atenção como interação entre representações
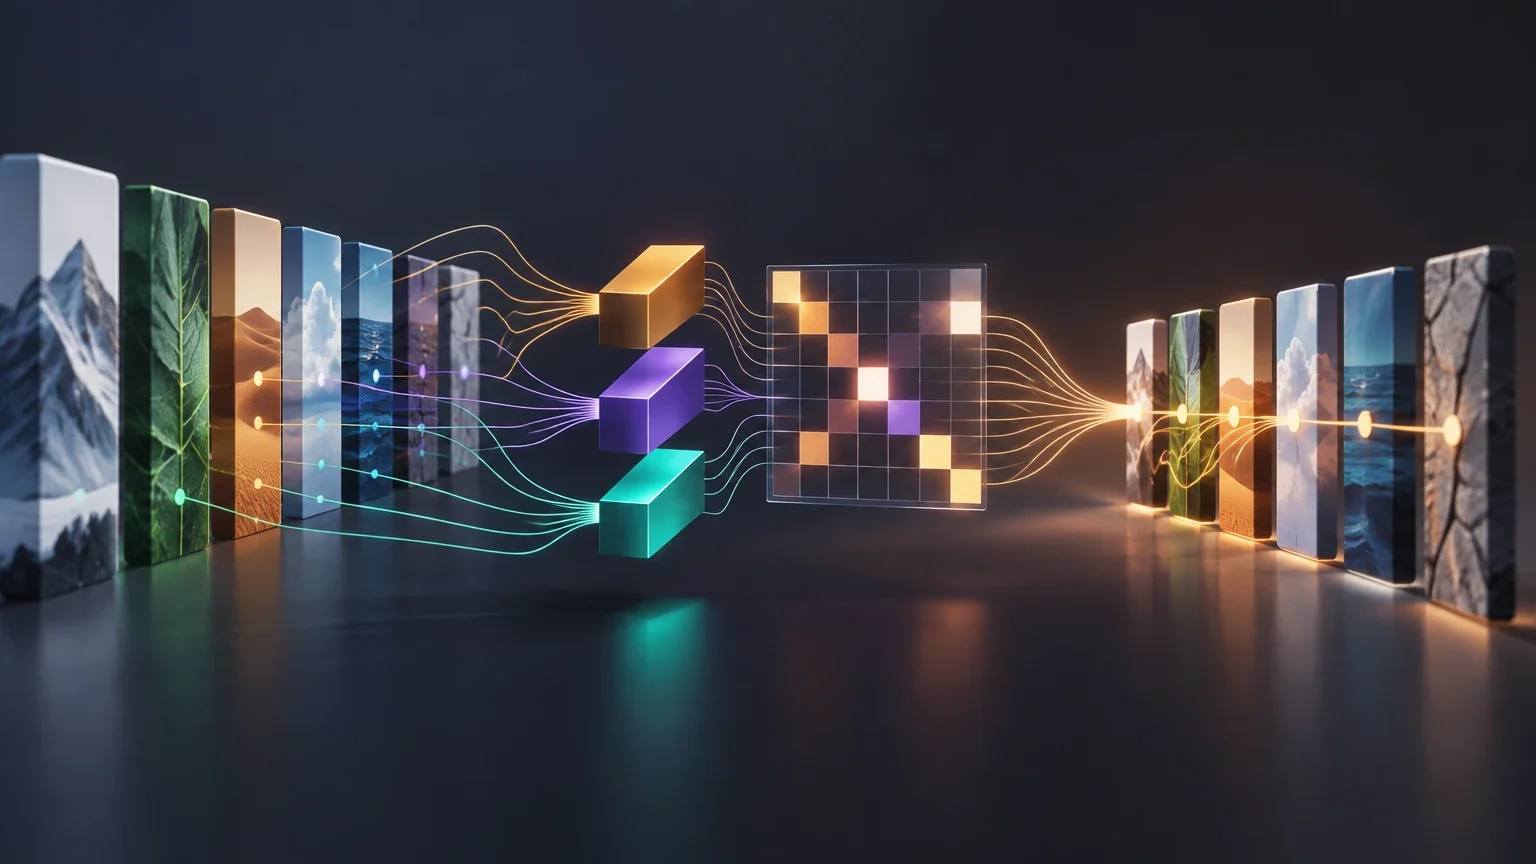
Em aprendizado de máquina, a atenção é uma operação que calcula quais representações de uma sequência devem contribuir para atualizar outra representação. Para isso, compara elementos por meio de pontuações e combina as informações associadas a eles usando pesos derivados dessas pontuações. É um mecanismo computacional de uma rede neural, não uma capacidade consciente de se concentrar em algo.
A metáfora da atenção humana pode ajudar a imaginar que o modelo seleciona informações relevantes, mas tem limites. Uma rede não «olha» para uma entrada como uma pessoa e não necessariamente atribui a cada palavra uma importância semântica estável. O cálculo consiste em transformações de vetores e operações matemáticas. Sua função concreta depende da arquitetura, dos dados, da camada, da cabeça e da tarefa.
Em um Transformer, o mecanismo permite que as representações de diferentes elementos da entrada interajam. Um elemento pode incorporar informações de outros elementos permitidos pela arquitetura e por suas máscaras. A atenção não substitui todo o processamento de uma rede: ela faz parte de um conjunto que também pode incluir projeções, conexões residuais, normalização e redes de transformação.
Como é calculada: consultas, chaves e valores
A formulação habitual da atenção por produto escalar escalado utiliza três conjuntos de vetores: consultas (Q), chaves (K) e valores (V). Em termos intuitivos, cada consulta é comparada às chaves disponíveis; as pontuações resultantes determinam quanto cada valor contribui para a representação atualizada. Q, K e V costumam ser obtidos por meio de projeções aprendidas das representações de entrada.
Em notação compacta, o cálculo é: Attention(Q, K, V) = softmax(QKᵀ / √dₖ)V. A expressão pode ser lida em etapas. Primeiro, QKᵀ calcula produtos escalares entre consultas e chaves: quanto maior uma pontuação, maior a compatibilidade segundo essa operação. Depois, divide-se por √dₖ, em que dₖ é a dimensão das chaves, para escalar as pontuações. Em seguida, o softmax normaliza cada conjunto de pontuações em pesos cuja soma é um. Por fim, os pesos são aplicados a V, e seus vetores são combinados.
A saída de uma consulta é, portanto, uma combinação ponderada de valores. Ela não é necessariamente uma cópia de um único elemento: vários valores podem contribuir em proporções diferentes. Em uma sequência, as linhas da matriz de pontuações correspondem às consultas, e as colunas, às chaves. Uma máscara pode excluir algumas posições antes da normalização das pontuações, por exemplo, para impedir que uma posição use informações futuras.
A equação descreve o cálculo central, mas não determina, por si só, todos os detalhes de um modelo. A maneira de produzir Q, K e V, as dimensões, as máscaras e a forma de combinar as saídas dependem da arquitetura. Por isso, entender a fórmula permite acompanhar a operação, mas não basta para reconstruir o funcionamento completo de um sistema.
Leitura passo a passo da fórmula
- 01Projetar as representações para obter consultas, chaves e valores.
- 02Calcular as pontuações de compatibilidade entre cada consulta e as chaves permitidas.
- 03Escalar as pontuações e aplicar o softmax para obter pesos normalizados.
- 04Usar esses pesos para combinar os valores e produzir representações atualizadas.
Variantes e máscaras: quais informações podem se relacionar
Na autoatenção, consultas, chaves e valores são derivados de uma mesma sequência de representações. Assim, os elementos dessa sequência podem interagir entre si, dentro dos limites estabelecidos pelas máscaras. Na atenção cruzada, por outro lado, as consultas vêm de uma sequência ou representação, enquanto as chaves e os valores vêm de outra. Essa configuração permite que um componente use informações produzidas por outro.
A atenção bidirecional permite que uma posição atenda a outras posições da sequência em ambos os lados, exceto pelas restrições impostas pela implementação. Na atenção causal, uma máscara bloqueia o acesso a posições futuras. Em um modelo autorregressivo, isso permite calcular a previsão do próximo token sem deixar que a representação use tokens que ainda não deveriam estar disponíveis. A máscara controla quais pontuações participam; ela não altera a definição geral de Q, K e V.
Uma cabeça de atenção realiza seu próprio cálculo de atenção. A atenção multi-cabeça executa vários cálculos em paralelo, com projeções distintas, e combina os resultados. A ideia é permitir que o modelo forme várias representações das interações. Não se deve presumir, sem evidências específicas, que cada cabeça corresponda a uma função semântica fixa, como «procurar sujeitos» ou «acompanhar nomes».
Essas distinções descrevem escolhas de arquitetura, não categorias mutuamente exclusivas em todos os sentidos. Por exemplo, o decodificador de uma arquitetura encoder-decoder pode usar autoatenção causal para sua sequência de saída e atenção cruzada para consultar as representações do codificador.
Comparação entre variantes
| Variante | Origem de Q, K e V | O que permite descrever |
|---|---|---|
| Autoatenção | Q, K e V vêm da mesma sequência. | Interações entre representações dessa sequência. |
| Atenção cruzada | Q vem de uma representação; K e V, de outra. | Uso de informações de uma sequência ou componente diferente. |
| Causal | A máscara oculta posições futuras. | Previsão sem consultar tokens posteriores que ainda não estão disponíveis. |
| Bidirecional | As posições podem se relacionar nos dois sentidos, de acordo com a máscara. | Contextualização usando posições anteriores e posteriores permitidas. |
| Multi-cabeça | Vários conjuntos de projeções e cálculos de atenção. | Combinação de diferentes interações aprendidas. |
Três exemplos aplicados a tarefas diferentes
Na tradução automática, a atenção pode ajudar o decodificador a consultar as representações da frase de origem enquanto produz cada palavra da tradução. Em uma configuração encoder-decoder, as consultas vêm da representação do lado da saída, e as chaves e os valores vêm das representações codificadas da frase de origem. A relação não precisa ser uma correspondência rígida de uma palavra para outra: o mecanismo pode combinar informações de várias posições.
Na geração autorregressiva de texto, a autoatenção causal permite que a representação de uma posição use o contexto disponível até aquele ponto, sem atender a posições posteriores. Ao gerar texto, o modelo estima uma distribuição para o próximo token com base no contexto que já tem. A máscara causal é uma condição de acesso às informações; ela não implica que cada token anterior contribua igualmente nem que o modelo mantenha uma memória ilimitada.
Em visão computacional, um Transformer de visão pode converter uma imagem em uma sequência de representações de patches e processá-la com camadas Transformer. A autoatenção permite que a representação de um patch se relacione com as representações de outros patches. Isso oferece uma maneira de modelar interações entre regiões de uma imagem. Não significa que cada cabeça necessariamente detecte um objeto específico, nem que as divisões em patches sempre coincidam com os limites dos objetos.
Os exemplos mostram que o mecanismo é geral, mas não que todos os modelos o utilizem da mesma maneira. A tarefa e a arquitetura determinam quais sequências são comparadas, quais máscaras são aplicadas e como as representações resultantes são usadas.
O que os pesos mostram e o que não permitem concluir
Os pesos de atenção mostram quanto os valores contribuem, em uma operação específica, para a saída de uma consulta. Quando visualizados como um mapa, podem ajudar a inspecionar padrões daquela camada, cabeça, entrada e configuração. São dados do cálculo interno, mas sua interpretação depende do que está sendo visualizado e de como essa operação se relaciona com a previsão final.
Não é correto equiparar automaticamente um peso alto a «esta palavra é importante para o modelo» em sentido humano. A previsão depende de muitas operações, e os valores podem ser transformados e combinados ao longo das camadas e dos componentes. Um mapa de atenção tampouco constitui, por si só, uma explicação causal: observar uma distribuição não demonstra que alterar as posições com pesos altos mudaria a resposta, nem que o mapa reflita o motivo decisivo da previsão.
O debate acadêmico sobre se a atenção pode funcionar como explicação não se reduz a um sim ou não. Há trabalhos que questionam a suficiência dos pesos como explicação de previsões e outros que discutem os pressupostos e critérios usados para avaliá-los. A conclusão prudente é tratá-los como um sinal inspecionável de uma operação do modelo, não como uma explicação completa nem como algo necessariamente desprovido de informação.
Para avaliar uma interpretação, são necessárias perguntas específicas: qual camada e cabeça estão sendo observadas? O que o peso significa naquela operação? Foi verificado o que acontece quando as informações destacadas são alteradas ou removidas? A conclusão se repete em outras entradas? A visualização pode orientar uma análise, mas não substitui testes de comportamento nem uma justificativa causal.
Custo computacional e otimizações de implementação
Na atenção densa padrão, cada posição pode ser comparada com todas as demais posições permitidas da sequência. Por isso, o número de interações cresce quadraticamente com seu comprimento: se o comprimento dobrar, a matriz de pontuações terá aproximadamente quatro vezes mais elementos, antes de considerar máscaras ou variantes. O custo computacional e o armazenamento de resultados intermediários estão relacionados, mas não são a mesma coisa.
A complexidade quadrática descreve o cálculo denso padrão, não toda arquitetura ou implementação possível. Máscaras podem limitar interações, e existem variantes projetadas para lidar com sequências longas de outras maneiras. Por isso, convém identificar que tipo de atenção e que algoritmo estão sendo analisados antes de aplicar uma estimativa de custo a um sistema específico.
FlashAttention é uma otimização de implementação que leva em conta o movimento de dados entre níveis de memória. Ela reorganiza o cálculo para reduzir transferências e o uso de memória intermediária, mantendo a operação exata de atenção que implementa, em vez de substituí-la por uma aproximação diferente de atenção. O fato de o cálculo matemático ser exato não significa que todas as implementações tenham o mesmo desempenho, os mesmos requisitos ou a mesma ocupação de memória.
Diferenciar operação, custo e implementação
| Aspecto | O que descreve | Pergunta útil |
|---|---|---|
| Operação de atenção | Pontuações, normalização e combinação ponderada. | Quais Q, K, V e máscara o modelo usa? |
| Complexidade densa padrão | O número de interações e resultados intermediários à medida que a sequência cresce. | Trata-se de atenção densa e qual comprimento está sendo processado? |
| Otimização de implementação | Como o cálculo e o acesso à memória são organizados. | A operação é mantida ou aproximada de outra maneira? |
Conceitos relacionados e erros frequentes
A atenção costuma ser estudada junto com Transformer, pois o mecanismo é um componente central dessa arquitetura, e com token, porque em modelos de texto as posições da sequência geralmente correspondem a tokens. Um token não é necessariamente uma palavra completa. As representações vetoriais que entram no cálculo estão relacionadas a embeddings, enquanto a janela de contexto limita quantos elementos um modelo pode processar ou ter disponíveis em determinada configuração.
Em sistemas multimodais, podem existir sequências ou representações de modalidades diferentes. A atenção cruzada oferece uma maneira de relacioná-las quando a arquitetura faz com que as consultas venham de uma representação e as chaves e os valores, de outra. Sem detalhes do sistema específico, não convém presumir que todo modelo multimodal use o mesmo padrão nem que seus pesos revelem, por si sós, uma correspondência interpretável entre modalidades.
Erros comuns incluem chamar de «atenção» a consciência do modelo; interpretar os pesos como probabilidades de importância humana; presumir que todas as cabeças têm funções semânticas claras; confundir atenção cruzada com autoatenção; e atribuir à máscara causal uma capacidade de memória. Também é comum confundir uma otimização mais eficiente com uma mudança na definição matemática, embora sejam níveis distintos de descrição.
Critérios práticos para interpretar uma explicação de atenção
Ao ler um diagrama ou mapa, identifique primeiro que operação ele representa: autoatenção ou atenção cruzada; causal ou bidirecional; uma cabeça ou várias. Verifique quais posições podem ser consultadas e se foi aplicada uma máscara. Em seguida, diferencie as pontuações anteriores ao softmax dos pesos normalizados e da combinação final de valores: não são a mesma coisa.
Depois, pergunte que conclusão se pretende tirar. Se a afirmação for apenas que uma posição recebeu determinado peso em uma operação específica, o mapa pode servir como descrição desse cálculo. Se a afirmação for que essa posição causou a previsão ou que representa uma explicação fiel, serão necessárias evidências adicionais, por exemplo, avaliações de sensibilidade ou intervenções pertinentes. Um gráfico isolado não responde a essas perguntas.
Por fim, verifique o alcance de qualquer afirmação sobre custo ou eficiência. Descubra se ela se refere à atenção densa padrão, a uma variante ou a uma implementação otimizada. Para se aprofundar, é útil consultar as fichas do glossário sobre Transformer, token, janela de contexto e multimodalidade, além da entrada sobre atenção. Essas relações ajudam a situar o mecanismo no modelo sem confundir componentes, limites de entrada e modos de processamento.
Lista breve de verificação
- 01Identifique Q, K, V e a sequência da qual cada um se origina.
- 02Verifique a máscara e as posições às quais é permitido atender.
- 03Separe os pesos observados das interpretações sobre importância ou causalidade.
- 04Peça evidências adicionais se o mapa for apresentado como explicação de uma previsão.
- 05Diferencie a complexidade da operação da eficiência de uma implementação.