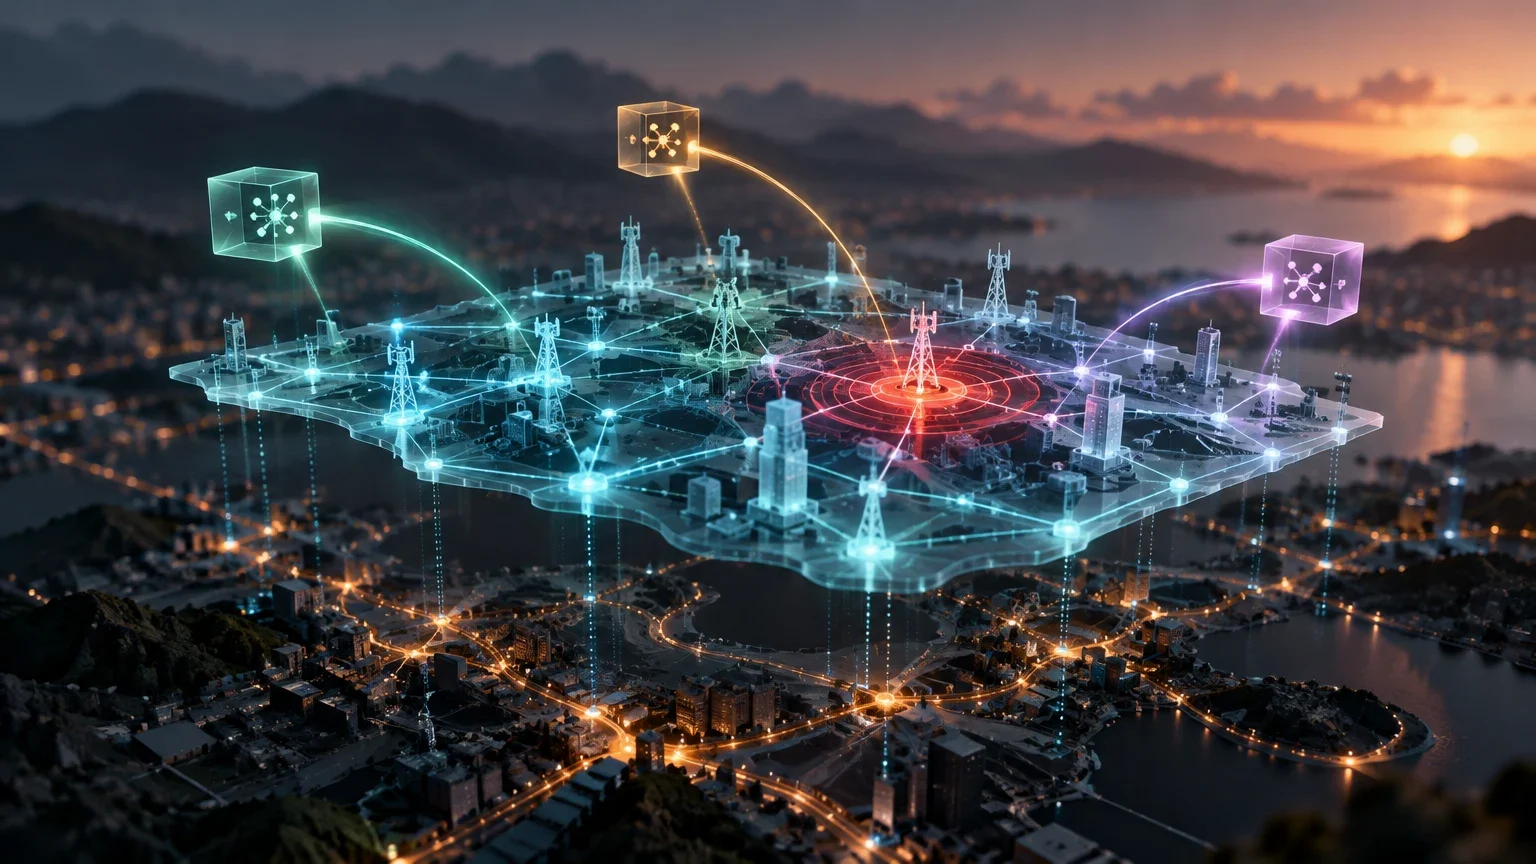
La sfida: trovare la causa tra numerosi allarmi
Quando una rete presenta problemi, i team operativi possono ricevere allarmi da numerosi dispositivi e servizi. Identificare quale abbia dato origine al guasto e distinguerlo dagli effetti successivi richiede di mettere in relazione eventi, connessioni e dipendenze. La pubblicazione di Amazon Science indica che, nelle attività operative tradizionali, analizzare e risolvere incidenti complessi può richiedere dalle quattro alle cinque ore e, in alcuni casi, protrarsi per giorni. Si tratta di una stima riportata dagli autori: le informazioni disponibili non precisano il campione né il metodo con cui è stata calcolata.
La proposta esplora l’uso congiunto di grafi e agenti di intelligenza artificiale per restringere il campo di ricerca. Invece di trattare ogni allarme come un dato isolato, rappresenta gli elementi della rete e le loro relazioni in un modello connesso. Applica poi analisi successive per selezionare i nodi candidati e impiega agenti per coordinare gli strumenti più adatti. L’obiettivo dichiarato è supportare l’analisi delle cause alla radice, non dimostrare che qualsiasi incidente possa essere risolto automaticamente.
Un gemello digitale della rete come punto di partenza
Il primo componente è un grafo sincronizzato con la rete. In questa rappresentazione i vertici corrispondono ai dispositivi e gli archi alle connessioni; gli elementi possono avere attributi. Secondo la descrizione, il modello integra dipendenze, allarmi e indicatori di prestazione (KPI) provenienti da diverse fonti e segmenti. Gli autori chiamano «gemello digitale» questa rappresentazione aggiornata dell’infrastruttura, fisica o definita via software.
Il grafo fornisce un contesto strutturale: permette di osservare quali dispositivi sono connessi, come si distribuiscono le dipendenze e quali relazioni potrebbero aiutare a interpretare una sequenza di allarmi. Da solo, però, un grafo non determina la causa di un guasto. La sua utilità dipende dall’attualità, dalla copertura e dalla qualità dei dati, oltre che dalla capacità del modello di rispecchiare correttamente la topologia reale. La pubblicazione include la sincronizzazione tra gli elementi del progetto, ma il materiale disponibile non specifica frequenza, latenza o comportamento in presenza di dati mancanti.
Tre fasi per ridurre i candidati
L’architettura descritta concatena tre tipi di analisi. Per prima cosa, la scomposizione individua le parti interessate della topologia e può limitare la ricerca ai componenti o ai nodi vicini alle connessioni interrotte. In seguito, algoritmi di clustering, come Louvain o la propagazione di etichette, raggruppano i nodi correlati per aiutare a capire se l’incidente è circoscritto a un gruppo o si estende tra gruppi diversi. La pubblicazione presenta questa sequenza come un modo per passare da migliaia di nodi a centinaia e poi a decine di candidati; l’estratto disponibile non riporta risultati suddivisi per scenario che permettano di valutare tali riduzioni.
La terza fase classifica i candidati mediante misure di centralità adattate all’insieme degli allarmi. La proposta cita PageRank personalizzato, grado e vicinanza rispetto ai nodi che generano allarmi. L’idea è evitare che una misura generica dell’importanza strutturale domini l’analisi: un nodo molto connesso nell’intera rete non è necessariamente rilevante per un incidente specifico. L’algoritmo scelto può variare in base alla forma della topologia coinvolta, per esempio se è gerarchica, a stella o a maglia.
Il contributo di ciascuna fase
La sequenza descritta restringe la ricerca prima che gli agenti esaminino i candidati e il contesto dell’incidente. I risultati dipendono dai dati in ingresso e dal comportamento degli algoritmi in ciascuna topologia.
| Fase | Operazione descritta | A cosa serve |
|---|---|---|
| Scomposizione | Individua i componenti e le aree interessate. | Escludere le zone che sembrano estranee all’incidente. |
| Clustering | Raggruppa nodi con interazioni o dipendenze condivise. | Distinguere guasti locali dalle propagazioni tra gruppi. |
| Classificazione per centralità | Ordina i candidati rispetto ai nodi che generano allarmi. | Dare priorità ai punti rilevanti per quello specifico schema di guasto. |
Gli agenti coordinano l’analisi, ma non sostituiscono le prove
La pubblicazione colloca sopra la cascata di algoritmi un livello di orchestrazione basato su agenti. Prima di eseguire l’analisi completa, il sistema consulta una base di conoscenza degli incidenti: se trova una corrispondenza sufficientemente affidabile, può applicare la procedura associata; in caso contrario, avvia la cascata di grafi. Effettua anche una valutazione iniziale della complessità, considerando quanti nodi sembrano coinvolti, come sono distribuiti nella topologia e se la firma del guasto è chiara.
Dopo aver ottenuto un elenco ordinato, l’agente può ampliare il sottografo dei candidati includendo dipendenze vicine, consultare cronologie degli allarmi e procedure operative e assegnare un punteggio di affidabilità. Secondo la descrizione, il punteggio pondera le prove temporali, la corrispondenza con lo schema topologico, le misure di centralità e gli allarmi correlati. La pubblicazione menziona anche l’apertura o l’aggiornamento di ticket e la possibilità per gli ingegneri di interrogare il gemello digitale. Le informazioni disponibili non definiscono una scala di affidabilità convalidata né descrivono nel dettaglio i controlli di sicurezza e autorizzazione applicati a ciascuna azione.
Flusso di analisi descritto
La pubblicazione illustra il seguente percorso generale per indagare un incidente.
- 01Confrontare lo schema degli allarmi con gli incidenti noti e le relative procedure.
- 02Valutare l’estensione, la distribuzione topologica e la chiarezza del segnale di guasto.
- 03Se necessario, eseguire la cascata di scomposizione, clustering e classificazione.
- 04Esaminare i candidati insieme agli allarmi, alle dipendenze e alle procedure pertinenti.
- 05Proporre una causa alla radice con un punteggio di affidabilità e supportare la gestione del ticket.
Che cosa dimostra la prova e che cosa resta da chiarire
Amazon Science afferma che l’approccio è stato dimostrato insieme a NTT DOCOMO su reti commerciali e che ha permesso di individuare le cause alla radice in pochi minuti. È un’affermazione rilevante relativa a una dimostrazione, ma non equivale a una valutazione indipendente e non prova di per sé che la soluzione sia distribuita in modo continuativo o disponibile per tutti gli operatori. La pubblicazione descrive anche vantaggi attesi rispetto a processi che possono durare ore; tuttavia, il materiale disponibile non contiene una tabella completa dei risultati, le dimensioni dei campioni, le condizioni di prova o intervalli di incertezza.
Nel materiale disponibile non è identificato un articolo tecnico sottoposto a revisione paritaria, né sono riportate metriche comparative sufficienti a riprodurre la valutazione. Non è specificata neppure la percentuale di incidenti risolti correttamente, come siano stati misurati i falsi positivi e i falsi negativi, quale linea di base sia stata usata in ciascun caso o se i valori provengano da prove controllate o da analisi retrospettive di attività operative. Non è quindi possibile concludere che il metodo superi in generale le pratiche esistenti, né attribuirgli un miglioramento quantificato della disponibilità o dei tempi di riparazione.
La descrizione stessa indica possibili sviluppi, come combinare la cascata deterministica con reti neurali a grafo e apprendimento spazio-temporale. Propone inoltre di aumentare gradualmente il livello di autonomia, partendo da raccomandazioni e supervisione prima di consentire azioni più ampie. Questa prospettiva sottolinea una distinzione importante: descrivere un’architettura e presentarne una dimostrazione non equivale ad avere uno strumento convalidato per intervenire senza supervisione in produzione. Per valutarne l’impatto serviranno risultati riproducibili, dati sui limiti e sugli errori e informazioni concrete sull’ambiente operativo.
Che cosa occorre chiarire prima di valutarne l’impatto
Per valutare la proposta in un centro operativo di rete, sarebbe utile sapere quali tipi di incidente siano stati inclusi, quanti siano stati analizzati e che cosa sia stato considerato una causa alla radice corretta. Sarebbe inoltre necessario confrontare il tempo necessario per la diagnosi e la precisione con quelli del processo abituale, specificando se i partecipanti abbiano lavorato su dati in tempo reale, registri retrospettivi o ambienti simulati. Senza queste informazioni, la descrizione consente di comprendere l’architettura, ma non di misurarne con precisione il vantaggio pratico.
Anche la qualità del gemello digitale e il grado di intervento umano sono determinanti. Una topologia non aggiornata, allarmi in ritardo o dipendenze rappresentate in modo errato possono cambiare la classificazione dei candidati. Inoltre, un punteggio di affidabilità non garantisce che la causa proposta sia corretta: occorre documentare come viene calibrato e che cosa accade quando il sistema non dispone di prove sufficienti. La pubblicazione prospetta un’evoluzione graduale dell’autonomia, ma non fornisce dettagli sufficienti per confermare quali livelli di azione siano stati abilitati nella dimostrazione.
In sintesi, il lavoro presenta un’idea tecnica coerente: combinare la struttura della rete con algoritmi a grafo e agenti che scelgono e coordinano le analisi in base all’incidente. Le prove comunicate attestano che, secondo gli autori, è stata realizzata una dimostrazione; non permettono ancora di considerare la proposta una capacità operativa ampiamente convalidata, né di affermare che riduca in generale i tempi di diagnosi.
Domande utili per interpretare una futura valutazione
Questi dati permetterebbero di distinguere una dimostrazione promettente da un miglioramento operativo misurabile.
| Aspetto | Informazioni da richiedere o verificare |
|---|---|
| Copertura | Tipi di guasto, numero di incidenti e caratteristiche delle reti valutate. |
| Confronto | Processo di riferimento e condizioni equivalenti per misurare tempi e accuratezza. |
| Qualità della diagnosi | Definizione di causa alla radice corretta, falsi positivi e falsi negativi. |
| Operatività | Uso di dati in tempo reale o retrospettivi, intervento umano e azioni autorizzate. |
| Robustezza | Risultati in presenza di dati incompleti, cambiamenti di topologia e segnali ambigui. |
Questioni aperte
- Nelle informazioni fornite non è identificato un articolo tecnico associato sottoposto a revisione paritaria.
- Non sono specificati i campioni, le metriche complete, la linea di base o le condizioni di valutazione a sostegno del risultato dichiarato in pochi minuti.
- Non è precisato se il sistema sia utilizzato continuativamente in produzione, quali azioni esegua in automatico o quali controlli siano attivi.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione