O desafio: encontrar a causa entre muitos alarmes
Quando uma rede apresenta problemas, as equipes de operação podem receber alarmes de numerosos dispositivos e serviços. Identificar qual deles iniciou a falha — e distingui-lo dos efeitos posteriores — exige relacionar eventos, conexões e dependências. A publicação da Amazon Science afirma que, em operações tradicionais, a análise e a resolução de incidentes complexos podem levar de quatro a cinco horas e, em alguns casos, se estender por dias. Esse intervalo é uma caracterização apresentada pelos autores; as informações disponíveis não especificam a amostra nem o método usado para calculá-lo.
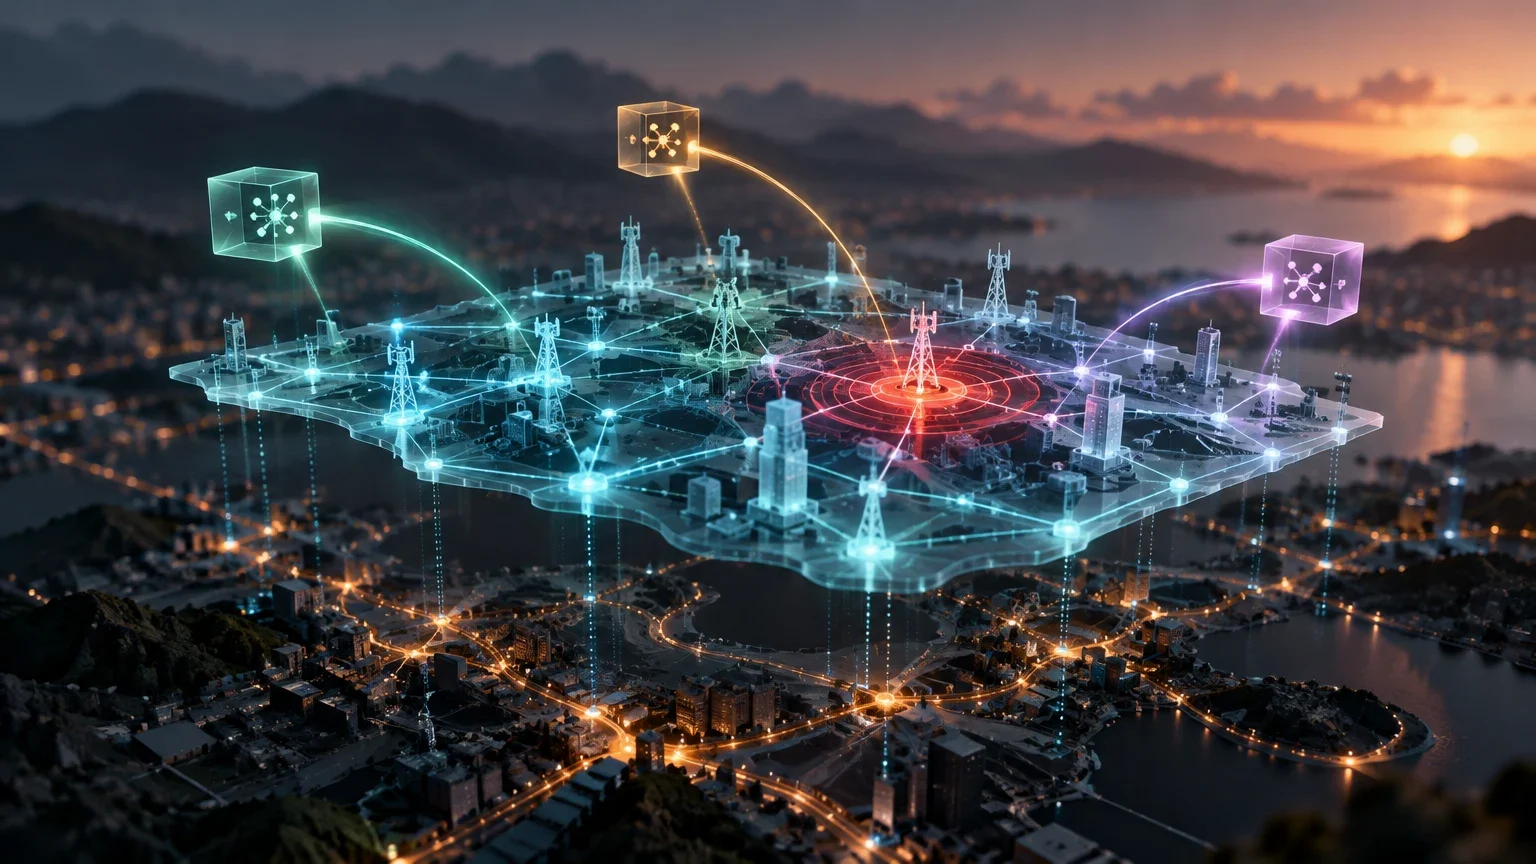
A proposta explora o uso conjunto de grafos e agentes de inteligência artificial para reduzir o espaço de busca. Em vez de tratar cada alerta como um dado isolado, ela representa os elementos da rede e suas relações em um modelo conectado. Em seguida, aplica análises sucessivas para selecionar nós candidatos e usa agentes para coordenar as ferramentas adequadas. O objetivo descrito é dar suporte à análise de causa-raiz, não demonstrar que qualquer incidente possa ser resolvido automaticamente.
Um gêmeo digital da rede como ponto de partida
O primeiro componente é um grafo sincronizado com a rede. Nessa representação, os vértices correspondem a dispositivos e as arestas, às conexões; os elementos podem conter atributos. De acordo com a descrição, o modelo integra dependências, alarmes e métricas de desempenho (KPI) provenientes de diferentes fontes e segmentos. Os autores chamam de “gêmeo digital” essa representação atualizada da infraestrutura, física ou definida por software.
O grafo oferece contexto estrutural: permite observar quais dispositivos estão conectados, como as dependências se distribuem e quais relações podem ajudar a interpretar uma sequência de alarmes. Um grafo, por si só, não determina a causa de uma falha. Sua utilidade depende da atualidade, da cobertura e da qualidade dos dados, além de a representação refletir corretamente a topologia real. A publicação descreve a sincronização como parte do projeto, mas o material disponível não especifica sua frequência, latência nem o comportamento diante de dados ausentes.
Três etapas para reduzir o número de candidatos
A arquitetura descrita encadeia três tipos de análise. Primeiro, a decomposição localiza partes afetadas da topologia e pode limitar a busca a componentes ou nós próximos de conexões interrompidas. Depois, algoritmos de agrupamento — como Louvain ou propagação de rótulos — reúnem nós relacionados para ajudar a identificar se o incidente está restrito a um grupo ou se se espalha entre grupos. A publicação apresenta essa cascata como uma forma de passar de milhares de nós para centenas e, depois, dezenas de candidatos; o trecho disponível não oferece resultados detalhados que permitam avaliar essas reduções em diferentes cenários.
A terceira etapa ordena os candidatos usando medidas de centralidade adaptadas ao conjunto de alarmes. A proposta menciona PageRank personalizado, grau e proximidade relativos aos nós que emitem alertas. A ideia é evitar que uma medida genérica de importância estrutural domine a análise: um nó muito conectado na rede inteira não precisa ser relevante para um incidente específico. O algoritmo escolhido pode variar conforme a forma da topologia afetada — por exemplo, se ela é hierárquica, em estrela ou em malha.
O que cada etapa oferece
A sequência descrita restringe a busca antes de os agentes analisarem os candidatos e o contexto do incidente. Os resultados dependem dos dados de entrada e do comportamento dos algoritmos em cada topologia.
| Etapa | Operação descrita | Finalidade |
|---|---|---|
| Decomposição | Localiza componentes e áreas afetadas. | Afastar da análise regiões aparentemente sem relação com o incidente. |
| Agrupamento | Agrupa nós com interações ou dependências compartilhadas. | Distinguir falhas locais de propagação entre grupos. |
| Classificação por centralidade | Ordena candidatos em relação aos nós que geram alarmes. | Priorizar os pontos relevantes para aquele padrão de falha. |
Os agentes coordenam a análise, mas não substituem as evidências
Sobre a cascata de algoritmos, a publicação descreve uma camada de orquestração baseada em agentes. Antes de executar a análise completa, o sistema consulta uma base de conhecimento de incidentes: se encontra um padrão que corresponde com confiança suficiente, pode aplicar o procedimento associado; se não, aciona a cascata de grafos. Também faz uma avaliação inicial da complexidade, considerando quantos nós parecem afetados, como se distribuem pela topologia e se a assinatura da falha é clara.
Depois de obter uma lista ordenada, o agente pode ampliar o subgrafo dos candidatos para incluir dependências vizinhas, consultar cronologias de alarmes e procedimentos operacionais e atribuir uma pontuação de confiança. A descrição diz que essa pontuação pondera evidências temporais, correspondência com o padrão topológico, centralidade e alarmes correlacionados. Também menciona a abertura ou atualização de chamados e a possibilidade de os engenheiros consultarem o gêmeo digital. As informações disponíveis não definem uma escala de confiança validada nem detalham os controles de segurança ou autorização efetivamente aplicados a cada ação.
Fluxo de análise descrito
A publicação apresenta o seguinte percurso geral para investigar um incidente.
- 01Comparar o padrão de alarmes com incidentes conhecidos e seus procedimentos.
- 02Avaliar o alcance, a dispersão topológica e a clareza do sinal da falha.
- 03Se necessário, executar a cascata de decomposição, agrupamento e classificação.
- 04Revisar os candidatos junto com alarmes, dependências e procedimentos pertinentes.
- 05Propor uma causa-raiz com uma pontuação de confiança e dar suporte à gestão do chamado.
Quais evidências a demonstração apresenta — e o que falta
A Amazon Science afirma que a abordagem foi demonstrada com a NTT DOCOMO em redes comerciais e que identificou causas-raiz em minutos. É uma afirmação relevante sobre uma demonstração, mas não equivale a uma avaliação independente nem comprova, por si só, que a solução esteja implantada continuamente ou disponível para todos os operadores. A publicação também descreve benefícios esperados em comparação com processos que podem durar horas, embora as informações fornecidas não incluam uma tabela completa de resultados, tamanhos de amostra, condições de teste ou intervalos de incerteza.
O material disponível não identifica um artigo técnico associado, revisado por pares, nem apresenta métricas comparativas suficientes para reproduzir a avaliação. Também não especifica qual proporção de incidentes foi resolvida corretamente, como foram medidos falsos positivos e falsos negativos, qual linha de base foi usada em cada caso nem se os números vieram de testes controlados ou de operações retrospectivas. Portanto, não é possível concluir que o método supere, de forma geral, as práticas existentes ou atribuir a ele uma melhoria quantificada na disponibilidade ou nos tempos de reparo.
A própria descrição propõe extensões futuras, como combinar a cascata determinística com redes neurais de grafos e aprendizado espaço-temporal. Também sugere avançar gradualmente no nível de autonomia, começando por recomendações e supervisão antes de permitir ações mais amplas. Essa perspectiva reforça uma distinção importante: descrever uma arquitetura e realizar uma demonstração não é o mesmo que validar uma ferramenta para agir sem supervisão em produção. Para avaliar seu impacto, serão necessários resultados reproduzíveis, dados sobre limites e falhas e detalhes concretos do ambiente operacional.
O que precisa ser esclarecido antes de avaliar o impacto
Para avaliar a proposta em um centro de operações de rede, seria importante saber quais tipos de incidentes foram incluídos, quantos foram analisados e o que foi considerado uma causa-raiz correta. Também seria necessário comparar o tempo até o diagnóstico e a precisão com o processo habitual, indicando se os participantes trabalharam com dados em tempo real, registros retrospectivos ou ambientes simulados. Sem esses elementos, a descrição permite compreender a arquitetura, mas não medir com precisão sua vantagem prática.
A qualidade do gêmeo digital e o grau de intervenção humana também são decisivos. Uma topologia desatualizada, alarmes atrasados ou dependências representadas incorretamente podem alterar a classificação dos candidatos. Além disso, uma pontuação de confiança não garante que a causa proposta esteja correta: é preciso documentar como ela é calibrada e o que acontece quando o sistema não dispõe de evidências suficientes. A publicação aponta para uma evolução gradual da autonomia, mas não oferece detalhes suficientes para confirmar quais níveis de ação foram habilitados na demonstração.
Em síntese, o trabalho apresenta uma ideia técnica coerente: combinar a estrutura da rede com algoritmos de grafos e agentes que escolhem e coordenam análises conforme o incidente. As evidências comunicadas sustentam que houve uma demonstração descrita por seus autores; ainda não permitem tratar a proposta como uma capacidade operacional amplamente validada nem garantir que ela reduza, de forma geral, os tempos de diagnóstico.
Perguntas para interpretar uma avaliação futura
Essas informações ajudariam a diferenciar uma demonstração promissora de uma melhoria operacional mensurável.
| Aspecto | Informação que falta ou convém verificar |
|---|---|
| Cobertura | Tipos de falhas, número de incidentes e características das redes avaliadas. |
| Comparação | Processo de referência e condições equivalentes para medir tempos e acertos. |
| Qualidade do diagnóstico | Definição de causa-raiz correta, falsos positivos e falsos negativos. |
| Operação | Uso de dados em tempo real ou retrospectivos, intervenção humana e ações autorizadas. |
| Robustez | Resultados diante de dados incompletos, mudanças na topologia e sinais ambíguos. |
Questões em aberto
- As informações fornecidas não identificam um artigo técnico associado e revisado por pares.
- Não são detalhadas as amostras, as métricas completas, a linha de base nem as condições de avaliação que sustentariam a afirmação de resultados em minutos.
- Não está especificado se o sistema é usado continuamente em produção, quais ações executa automaticamente nem quais controles estão habilitados.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção