Qué anuncia AWS y qué productos abarca
AWS ha anunciado la Global Inference Gateway para Amazon SageMaker HyperPod, un endpoint gestionado que enruta solicitudes de inferencia entre clústeres de HyperPod dentro de una misma región o entre regiones distintas. El anuncio se publicó el 20 de noviembre de 2026 en el blog oficial de Machine Learning de AWS.
Esta funcionalidad se distingue de la Inference Gateway de HyperPod lanzada en septiembre de 2026, que opera a nivel de clúster (Tier 1) y gestiona el enrutamiento interno de pods. La puerta de enlace global representa la capa de coordinación de flota (Tier 2), que añade conmutación por error entre clústeres, limitación de tasa global y formación de tráfico consciente del coste.
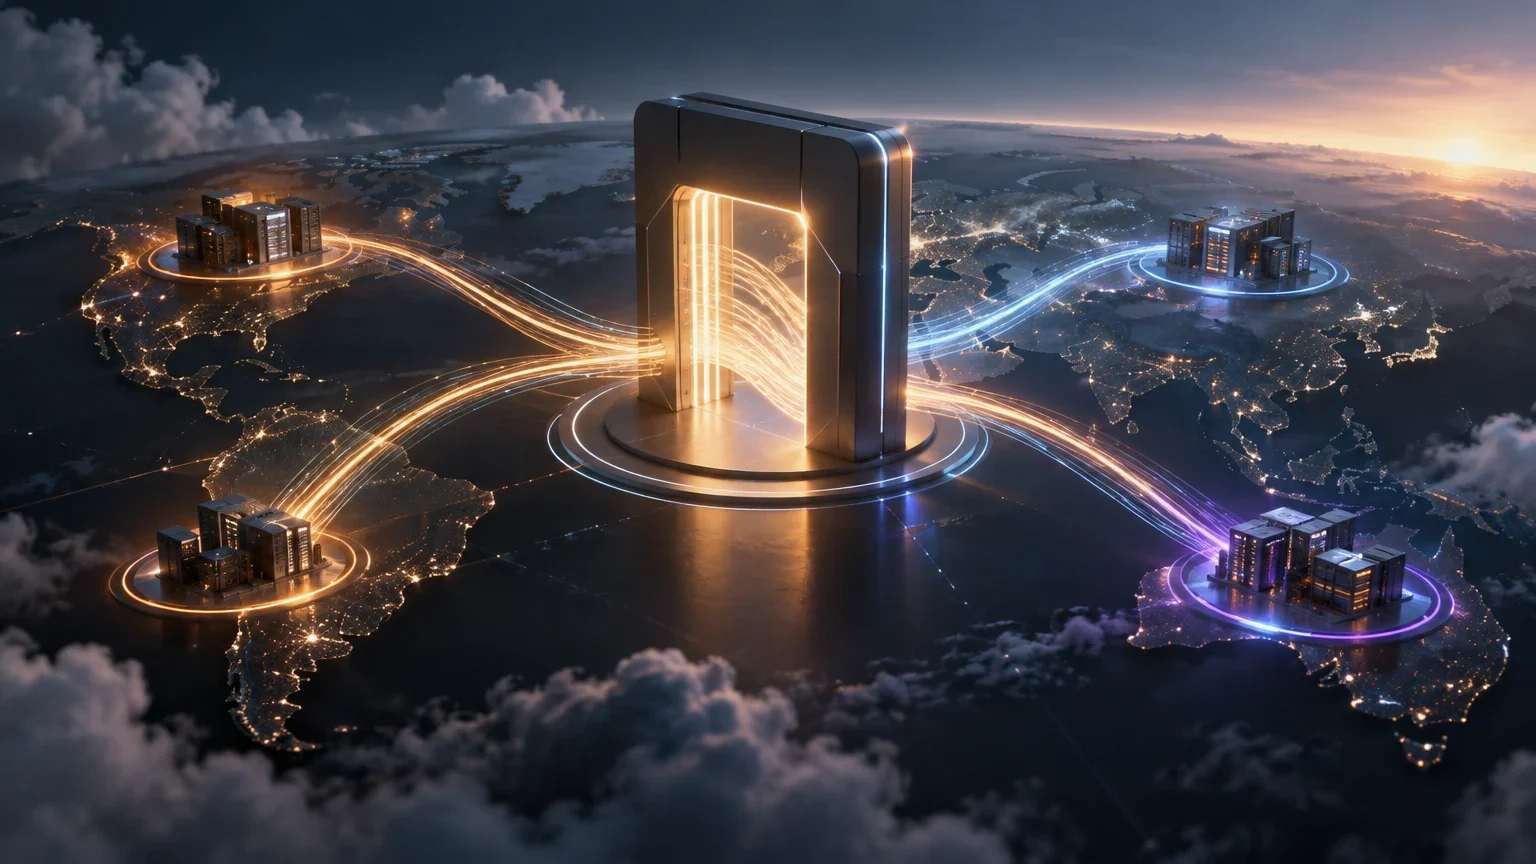
La Global Inference Gateway se ubica como capa de coordinación de flota por encima del enrutamiento interno de cada clúster. Su función es ofrecer una única entrada lógica para la inferencia mientras la flota puede incluir clústeres en la misma región o en regiones distintas, sin que la aplicación tenga que conocer cada destino individual.
Diferencias entre las capas de enrutamiento de SageMaker
| Característica | Inference Gateway (Tier 1) | Global Inference Gateway (Tier 2) |
|---|---|---|
| Alcance | Intra-clúster | Inter-clúster e inter-región |
| Lanzamiento | Septiembre 2026 | Noviembre 2026 |
| Función principal | Selección de pod óptimo por señales de GPU | Coordinación de flota y failover global |
| Autenticación | Integrada con IAM | SigV4 e IAM sobre PrivateLink |
Cómo funciona el endpoint único
La arquitectura se basa en un endpoint único que actúa como punto de entrada para todas las solicitudes de inferencia. En lugar de que la aplicación gestione múltiples direcciones de clúster, el cliente envía la petición a esta puerta de enlace centralizada, que decide internamente hacia qué clúster o región dirigir el tráfico.
El sistema selecciona el clúster de destino basándose en criterios de salud y capacidad. Cuando un clúster experimenta una falla o agotamiento de recursos, la puerta de enlace realiza una conmutación por error automática hacia otro clúster disponible, manteniendo la continuidad del servicio sin intervención manual del usuario.
Al concentrar el acceso en un endpoint único, la aplicación conserva una referencia estable aunque la flota incluya varios clústeres. La puerta de enlace global asume la decisión de destino, de modo que el cliente no necesita mantener listas de direcciones ni lógica de selección manual entre clústeres.
Selección de destino y failover automático
La lógica de enrutamiento evalúa la disponibilidad de los clústeres registrados en la flota. A diferencia del enrutamiento cross-region estándar de SageMaker AI, que se activa ante fallos de plataforma o errores 5xx de contenedor, la puerta de enlace global de HyperPod está diseñada para gestionar la coordinación de flota completa, incluyendo la limitación de tasa global y la optimización de costes.
El failover automático garantiza que las solicitudes no se pierdan ante una indisponibilidad regional. Este mecanismo es crítico para aplicaciones de alta disponibilidad que dependen de modelos de lenguaje de gran escala desplegados en infraestructura de GPU distribuida.
La limitación de tasa global y la formación de tráfico consciente del coste amplían el alcance del failover: la flota puede aplicar límites de tasa a nivel de flota y orientar el tráfico hacia destinos que cumplan los requisitos de salud y capacidad. Este comportamiento es relevante cuando varios clústeres ofrecen el mismo modelo y el objetivo es mantener la disponibilidad sin saturar un único destino.
Integración de seguridad y acceso
La puerta de enlace global integra la autenticación mediante SigV4 y IAM sobre AWS PrivateLink. Esto significa que cada solicitud se autentica con las credenciales de AWS estándar, permitiendo aplicar políticas de acceso granulares sin exponer el endpoint a la red pública.
El uso de PrivateLink asegura que el tráfico entre la aplicación y la puerta de enlace se mantenga dentro de la red de AWS, mejorando la seguridad y la latencia. Esta configuración es consistente con las mejores prácticas de seguridad para servicios de inferencia en entornos empresariales.
La autenticación con SigV4 e IAM sobre PrivateLink permite que el control de acceso se base en identidades y políticas de AWS, en lugar de depender de credenciales específicas del endpoint. Al mantener el tráfico dentro de la red privada, la configuración reduce la exposición de la red y facilita la aplicación de permisos granulares para los servicios que consumen la inferencia.
Detalles operativos y métricas pendientes
Aunque el anuncio confirma la disponibilidad de la funcionalidad, AWS no ha publicado aún métricas detalladas sobre la latencia añadida por el enrutamiento global, los límites de capacidad específicos o los costes adicionales asociados a la coordinación inter-regional.
Los equipos de ingeniería deben realizar pruebas de carga con sus propias cargas de trabajo para evaluar el impacto en la latencia de primer token (TTFT) y la disponibilidad. La documentación técnica específica sobre la configuración de la flota y los parámetros de enrutamiento global sigue en desarrollo.
Hasta que se publiquen métricas oficiales, los valores de latencia, capacidad y coste deben tratarse como provisionales. Los equipos de ingeniería deben validar el comportamiento con sus propias cargas de trabajo, especialmente el impacto en la latencia de primer token y la continuidad del servicio, y confirmar qué clústeres y regiones participan en la flota antes de asumir un comportamiento uniforme.
Pasos para evaluar la implementación
- 01Identificar los clústeres de HyperPod que participarán en la flota global.
- 02Configurar la autenticación SigV4 e IAM para el endpoint de la puerta de enlace.
- 03Realizar pruebas de latencia comparando el acceso directo al clúster con el acceso a través de la puerta de enlace global.
- 04Validar el comportamiento del failover ante la simulación de fallos en un clúster.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección