De una lista fija a una búsqueda que se adapta
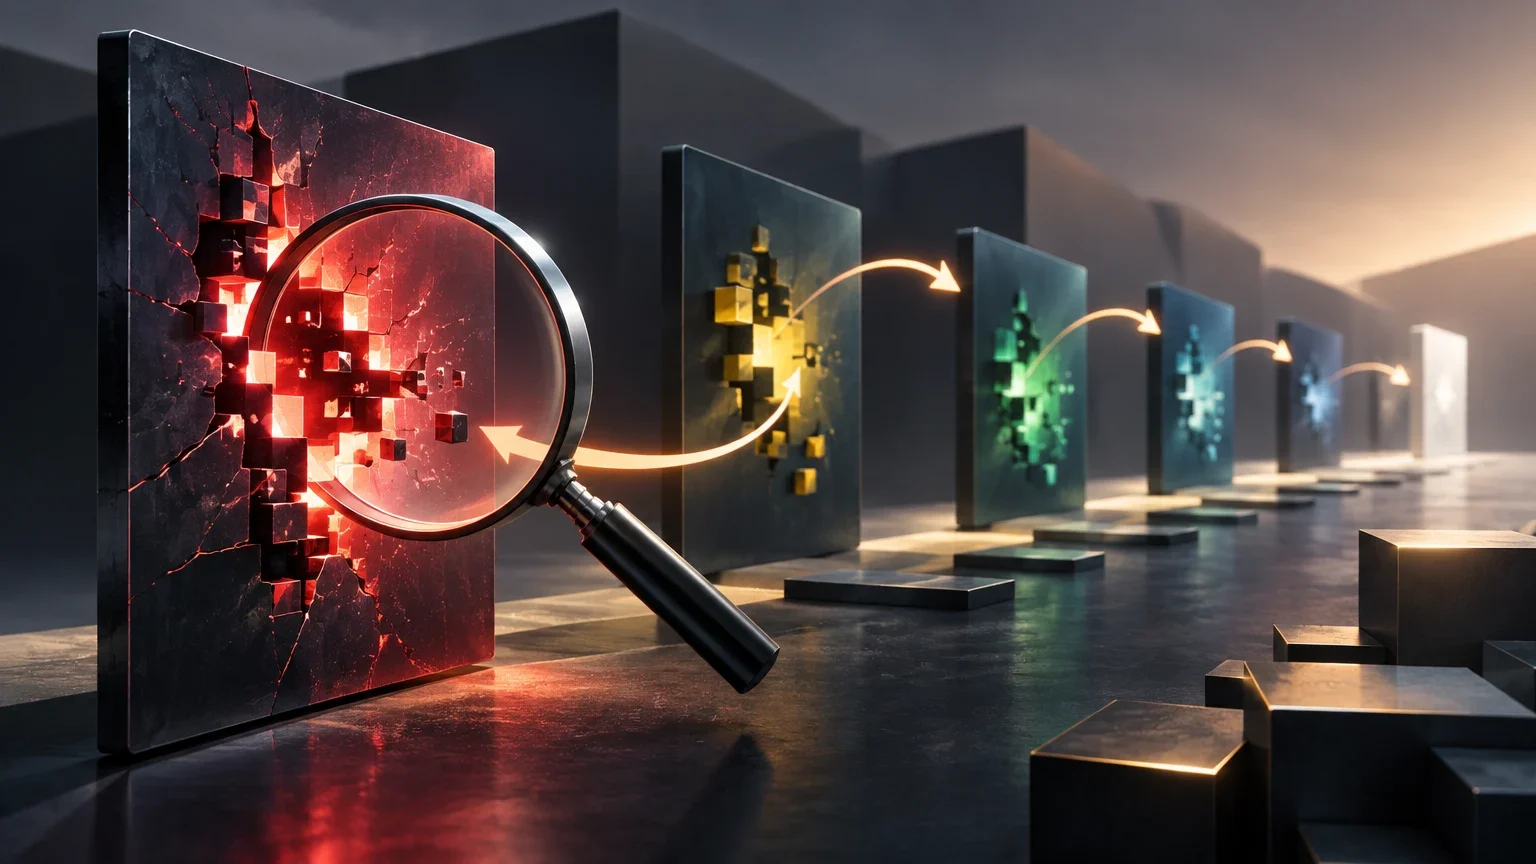
CART —sigla de Closed-Loop Adaptive Red Teaming— es un marco de evaluación que propone adaptar las pruebas de seguridad a medida que aparecen resultados. La idea central es que un hallazgo no sea solo una respuesta que se registra al final de una campaña: también puede orientar cuál será el siguiente intento. El trabajo se presenta en un preprint, es decir, una publicación que todavía no debe confundirse con una validación independiente o con una garantía de seguridad.
El problema que intenta abordar es concreto. Una colección fija de prompts puede servir para comprobar riesgos ya conocidos y facilitar comparaciones repetibles, pero no cambia necesariamente cuando una prueba descubre una debilidad inesperada. Según el resumen del estudio, CART empieza con una cobertura amplia de riesgos, continúa explorando debilidades que emergen y procura que las nuevas pruebas no se reduzcan a variantes repetidas de un mismo ataque.
El planteamiento no implica que las pruebas estáticas dejen de ser útiles. Una batería fija puede aportar una referencia común; el enfoque adaptativo añade una búsqueda guiada por lo ocurrido durante la evaluación. La cuestión es si esa adaptación encuentra fallos relevantes que una repetición de los casos iniciales no habría detectado, y bajo qué condiciones. El resumen afirma que CART descubre más fallos y un riesgo medio más alto que la repetición estática de las pruebas semilla en todos los objetivos para los que había una línea de base disponible. No ofrece en el material aquí resumido cifras con las que medir la magnitud de esa diferencia.
La comparación, por tanto, se refiere a lo que descubren dos políticas de prueba dentro de las evaluaciones realizadas. No permite concluir por sí sola que los sistemas evaluados fallen con mayor frecuencia en el uso cotidiano, ni que CART haya cubierto todos los riesgos posibles.
Qué compara el planteamiento
La diferencia metodológica es la adaptación del siguiente caso de prueba. La tabla no implica que una estrategia sustituya a la otra en todos los usos.
| Enfoque | Qué hace | Qué permite observar | Límite |
|---|---|---|---|
| Repetición estática | Vuelve a ejecutar un conjunto inicial de pruebas. | Resultados sobre casos conocidos y una referencia repetible. | No necesariamente explora debilidades nuevas que aparezcan durante la campaña. |
| CART | Usa resultados de la evaluación para orientar pruebas posteriores, manteniendo una búsqueda amplia y diversa. | Si la adaptación descubre fallos que no aparecen al repetir las pruebas semilla. | Los resultados dependen de las pruebas, los roles y los objetivos que se hayan evaluado. |
Tres funciones separadas dentro del ciclo
El marco distingue tres papeles. El Challenger propone pruebas; el Target es el modelo o agente que recibe esas pruebas; y el Judge valora los resultados. La separación permite estudiar cada función por separado y evita describir CART como si fuera un único modelo que decide, responde y verifica a la vez. El objetivo evaluado puede ser un modelo de texto o un agente con herramientas, aunque el resumen disponible no identifica los modelos concretos ni detalla las herramientas empleadas.
En un ciclo adaptativo, el resultado del Target puede proporcionar señales para decidir qué vulnerabilidad explorar después. El Challenger genera nuevas pruebas con esa orientación; el Judge analiza las respuestas y el proceso conserva la evidencia y la procedencia de los hallazgos. El resumen destaca precisamente el registro de la evidencia y del origen de cada hallazgo, pero no especifica en el material disponible qué campos concretos componen ese registro ni qué formato adopta.
Separar funciones no elimina el riesgo de error. Un juez puede clasificar mal una respuesta, y la elección del Challenger y del Judge puede cambiar qué evidencias aparecen. El propio resumen de CART indica que las combinaciones de Challenger y Judge afectan a la evidencia descubierta. Por eso, el número de fallos señalados no debe tratarse como una medida independiente de las decisiones tomadas para generarlos y evaluarlos.
Ciclo de evaluación descrito por CART
- 01Comenzar con pruebas que cubran un conjunto amplio de riesgos.
- 02Enviar una prueba al Target, que puede ser un modelo de texto o un agente con herramientas dentro de límites definidos.
- 03Evaluar la respuesta mediante el Judge y conservar la evidencia y la procedencia asociadas al hallazgo.
- 04Usar los resultados para orientar nuevas pruebas, intentando ampliar la exploración sin repetir el mismo fallo.
- 05Revisar qué combinación de Challenger y Judge produjo la evidencia antes de interpretar el resultado.
Qué resultados comunica el preprint
El resumen agrupa los experimentos en tres familias: Frontier, JAH y Agentic. Señala que, en cada objetivo para el que había una línea de base disponible, CART encontró más fallos y un riesgo medio más alto que la repetición estática de las pruebas semilla. También afirma que las mejoras se extienden a pruebas de agentes mediadas por herramientas. Es una señal de que la adaptación contextual puede descubrir debilidades que no se ejercitan con la repetición directa de prompts, según los experimentos descritos.
Hay límites importantes a esa lectura. El resumen no facilita aquí el número de objetivos evaluados, los nombres de los modelos, las tasas de detección, las diferencias numéricas entre métodos ni los detalles de cada familia experimental. Tampoco basta con la palabra «más» para conocer la relevancia estadística o práctica de la diferencia. Para valorar esos aspectos hace falta consultar los resultados completos y sus condiciones, no inferirlos del resumen.
Además, los autores advierten que los resultados describen lo que las políticas de prueba descubren, no con qué frecuencia ocurren fallos en despliegues reales. Una campaña de red teaming selecciona entradas, condiciones y criterios de evaluación; no equivale a observar todas las interacciones que tendría un sistema en producción. En consecuencia, CART puede aportar evidencia sobre el rendimiento de una estrategia de búsqueda sin ofrecer una estimación directa de incidentes en uso real.
Qué se puede concluir y qué sigue abierto
| Pregunta | Lo que indica el resumen | Lo que no permite establecer por sí solo |
|---|---|---|
| ¿Qué familias de evaluación se describen? | Frontier, JAH y Agentic. | Los detalles completos de cada protocolo. |
| ¿Cómo se compara CART con la línea de base? | Comunica más fallos y mayor riesgo medio en todos los objetivos con línea de base disponible. | La magnitud numérica de la diferencia y su relevancia práctica. |
| ¿Se probó con agentes? | El resumen informa de resultados en pruebas de agentes mediadas por herramientas. | Qué agentes, herramientas y límites concretos se utilizaron. |
| ¿Cuánto fallan los sistemas en producción? | El trabajo aclara que mide lo descubierto por las políticas de prueba. | La frecuencia de fallos en despliegues reales. |
Trazabilidad, diversidad y límites pendientes
Registrar la procedencia y la evidencia de un hallazgo importa porque facilita revisar cómo se produjo y qué observación respalda su clasificación. Sin esa información, una lista de resultados puede ser difícil de interpretar o reproducir. CART declara que registra evidencia y origen, pero el resumen no describe el esquema de datos, los identificadores, la disponibilidad de los registros ni si una persona independiente puede reconstruir cada prueba.
La diversidad también requiere una definición operativa. Decir que se buscan pruebas diversas no demuestra que los casos sean distintos en el sentido relevante: pueden cambiar las palabras y repetir la misma vulnerabilidad, o parecer similares y explorar mecanismos diferentes. El resumen afirma que CART mantiene diversas las nuevas pruebas, pero no proporciona aquí la métrica, el umbral o el procedimiento utilizado para comprobarlo. Por ello, no se puede confirmar solo con esta descripción cómo se detectan duplicados o cómo se evita premiar variaciones superficiales.
Tampoco queda resuelta la reproducibilidad. Para repetir una evaluación suelen ser importantes elementos como las versiones de los modelos, las instrucciones, las herramientas habilitadas, el presupuesto de búsqueda, el arnés de evaluación y las reglas de puntuación. El material proporcionado no confirma qué elementos de CART se han publicado o si el código, las pruebas generadas y los hallazgos están disponibles para una réplica externa. No es correcto presentar esa disponibilidad como un hecho sin verificarla.
En despliegues reales, la interpretación depende además del producto y de su configuración. Un resultado obtenido en un punto de conexión experimental no necesariamente describe el comportamiento de una interfaz o configuración de producción. La evaluación debería dejar claro qué se probó y con qué límites, y considerar pruebas adicionales sobre el sistema efectivamente desplegado. Esto no cambia los resultados comunicados por CART, pero sí acota qué decisiones pueden apoyarse en ellos.
Una aportación de evaluación, no un certificado de seguridad
La contribución que plantea CART es metodológica: convertir los resultados de una campaña en información para orientar la siguiente ronda de pruebas, en lugar de depender únicamente de una lista que permanece fija. El preprint informa de ventajas frente a una línea de base estática en tres familias de evaluación, incluidas pruebas con agentes y herramientas. Esa evidencia justifica interés en el enfoque, pero no basta para declarar que detecta todos los riesgos, que funciona igual en cualquier modelo o que mejora por sí mismo la seguridad de un producto.
Para decidir cuánto confiar en la propuesta, las preguntas prácticas son: qué objetivos se compararon, cuáles fueron las condiciones y presupuestos, cómo se verificó la diversidad, cómo se controlaron errores del juez y si terceros pueden reproducir los resultados. También conviene comprobar si las pruebas corresponden al modelo y al punto de conexión que se utilizarán realmente. Hasta disponer de respuestas verificables, CART debe leerse como un marco prometedor de búsqueda adaptativa con resultados reportados por sus autores y límites reconocidos, no como una garantía de seguridad.
Criterios para interpretar una evaluación adaptativa
- 01Identificar qué modelos, agentes, herramientas y configuraciones se probaron.
- 02Comparar la estrategia adaptativa con una línea de base claramente definida y revisar las magnitudes, no solo la dirección de los resultados.
- 03Comprobar cómo se midieron la diversidad y la deduplicación de las pruebas.
- 04Revisar los controles humanos o independientes aplicados a los juicios automáticos.
- 05Confirmar qué evidencias, código y registros están disponibles para una réplica.
- 06No extrapolar los resultados de una campaña a la frecuencia de fallos en producción sin evidencia específica.
Qué sigue abierto
- El material proporcionado no detalla las identidades y versiones de los modelos y agentes evaluados ni los límites de las herramientas.
- No se ofrecen aquí cifras detalladas, tamaños de muestra o estimaciones de incertidumbre para cuantificar la ventaja frente a la línea de base.
- No se especifica cómo se mide la diversidad de las pruebas ni cómo se deduplican ataques que exploran el mismo fallo.
- No se confirma qué mecanismos independientes o humanos se usan para detectar falsos positivos y sesgos del Judge.
- No se confirma si el código, las pruebas generadas y los registros están disponibles para replicación externa.
- Los resultados del preprint no establecen la frecuencia de fallos en sistemas desplegados en condiciones reales.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección