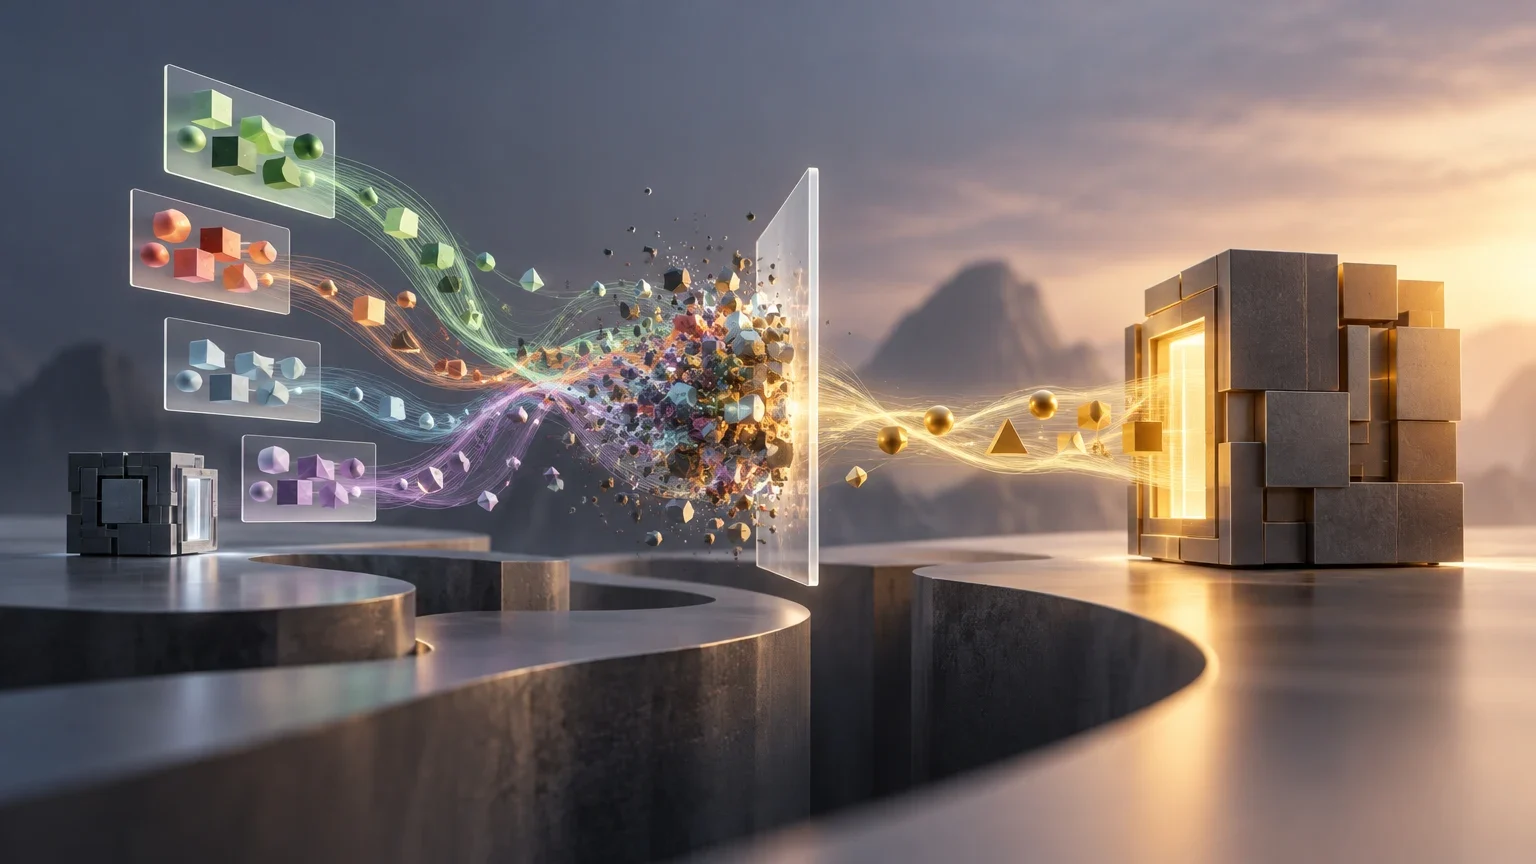
El problema de enrutar solicitudes entre modelos de distinta capacidad
En arquitecturas de inteligencia artificial que combinan modelos pequeños y grandes, surge la necesidad de decidir en tiempo real qué consulta debe ser procesada por el modelo más potente. El objetivo es optimizar el coste y la latencia sin sacrificar la calidad de la respuesta. Si se envía todo al modelo grande, se incurre en costes innecesarios; si se envía todo al pequeño, se pierde precisión en tareas complejas.
El preprint aborda esta cuestión buscando una señal barata que se pueda calcular antes de invocar al modelo grande. Esta señal debe predecir si la escalada será útil. La propuesta evalúa la entropía semántica, una métrica que mide el grado de desacuerdo en el significado de las respuestas generadas por el modelo pequeño al muestrear múltiples salidas.
La tensión entre coste y calidad se manifiesta especialmente cuando las consultas presentan una heterogeneidad intrínseca en su complejidad. En un entorno de producción, el tráfico no es uniforme; coexisten preguntas triviales que cualquier modelo puede resolver con alta confianza y problemas de razonamiento profundo que exigen la capacidad computacional de arquitecturas más extensas. La decisión de enrutamiento debe, por tanto, actuar como un filtro dinámico que identifique esta bifurcación antes de comprometer recursos. Si el sistema no logra discriminar eficazmente entre estas dos categorías, se produce una ineficiencia sistémica: o se desperdicia potencia de cálculo en tareas simples, o se degradan las respuestas en tareas críticas por falta de capacidad adecuada. Esta optimización no es solo una cuestión económica, sino de rendimiento operativo, ya que la latencia percibida por el usuario depende directamente de la velocidad con la que el sistema decide qué recurso invocar.
Cómo funciona la señal de escalado basada en discrepancia
El método consiste en generar varias respuestas para la misma consulta utilizando el modelo pequeño. A continuación, se calcula la entropía semántica de estas respuestas. Si la entropía supera un umbral determinado, se asume que el modelo pequeño no es fiable y la consulta se escala al modelo grande.
Esta técnica se basa en la premisa de que los modelos pequeños tienden a ser más consistentes en tareas que dominan y más erráticos en tareas que superan su capacidad. Por tanto, la inconsistencia semántica actúa como un proxy de la dificultad o la incapacidad del modelo pequeño para resolver la tarea.
La premisa fundamental de utilizar la inconsistencia como señal de incapacidad se apoya en la observación empírica de cómo los modelos de lenguaje generan texto bajo incertidumbre. Cuando un modelo posee un conocimiento sólido sobre un tema, sus salidas muestreadas tienden a converger en una misma interpretación semántica, mostrando una baja entropía. En cambio, cuando el modelo se enfrenta a un problema que excede su capacidad de razonamiento o su base de conocimiento, las salidas divergen, presentando variaciones significativas en la estructura o el contenido. Esta divergencia actúa como un indicador interno de que el modelo está 'adivinando' en lugar de 'resolviendo'. Al cuantificar esta variabilidad, el sistema obtiene una métrica objetiva que no requiere etiquetas externas ni supervisión humana, permitiendo una evaluación en tiempo real de la fiabilidad de la respuesta generada por el modelo pequeño antes de tomar la decisión de escalado.
Flujo de decisión de escalado
Proceso paso a paso para implementar la señal de entropía semántica.
- 01Recibir la consulta del usuario.
- 02Muestrear N respuestas del modelo pequeño.
- 03Calcular la entropía semántica de las N respuestas.
- 04Comparar la entropía con el umbral predefinido.
- 05Si la entropía es alta, enviar la consulta al modelo grande.
- 06Si la entropía es baja, devolver la respuesta del modelo pequeño.
Resultados en benchmarks y métricas reportadas
El estudio evalúa la señal en tres benchmarks y dos familias de modelos. En el benchmark GSM8K, utilizando una pareja de modelos con una diferencia de tamaño de aproximadamente doce veces, la entropía semántica logra un AUROC de 0,871 para distinguir los errores del modelo pequeño.
Además, se reporta una mejora en la precisión enrutada de hasta nueve puntos porcentuales frente al escalado aleatorio, manteniendo un coste comparable. Estos resultados sugieren que la señal tiene capacidad predictiva real en tareas matemáticas de razonamiento.
La métrica AUROC de 0,871 obtenida en el benchmark GSM8K indica una capacidad discriminativa considerable para identificar cuándo el modelo pequeño falla. Este valor sugiere que la entropía semántica no es una señal aleatoria, sino que contiene información predictiva robusta sobre el error. En el contexto de tareas matemáticas, donde la respuesta correcta es binaria y verificable, esta capacidad de distinción es crucial para garantizar la integridad del sistema. La mejora de hasta nueve puntos porcentuales en la precisión enrutada frente a un escalado aleatorio demuestra que la selección basada en la señal de entropía es significativamente más eficiente que la asignación arbitraria de consultas. Esto implica que, al utilizar la señal, el sistema logra capturar una proporción mayor de los casos donde la escalada es realmente necesaria, maximizando el beneficio de la intervención del modelo grande mientras minimiza las intervenciones innecesarias. La consistencia de estos resultados en una familia de modelos específica refuerza la viabilidad de la señal como herramienta de optimización en dominios estructurados.
Resumen de métricas reportadas en el preprint
Datos extraídos del resumen del preprint arXiv:2610.07354.
| Benchmark | Métrica | Valor Reportado | Comparativa |
|---|---|---|---|
| GSM8K | AUROC | 0,871 | Distingue errores del modelo pequeño |
| GSM8K | Mejora de precisión | Hasta 9 puntos | Frente a escalado aleatorio a coste comparable |
Límites del método y trampas metodológicas
El preprint destaca que un resultado aparentemente fuerte en un benchmark sintético resultó ser engañoso. Una regla simple basada solo en la dificultad de la pregunta, sin involucrar ningún modelo, coincidió casi exactamente con la entropía semántica. Esto indica que la señal podría estar capturando solo la dificultad superficial de la pregunta en lugar de la incertidumbre del modelo.
Además, se señala que dos definiciones razonables de 'escalada exitosa' pueden producir resultados muy diferentes con los mismos datos. También se advierte que el coste real del muestreo en vivo puede hacer que el enrutamiento sea más caro que llamar directamente al modelo grande, invalidando la supuesta eficiencia.
La advertencia sobre la correlación espuria con la dificultad de la pregunta es un punto crítico que limita la generalización del método. Si la entropía semántica se correlaciona fuertemente con la longitud o la complejidad léxica de la entrada, entonces la señal podría estar midiendo la dificultad del problema en lugar de la incertidumbre del modelo. Esto tendría implicaciones graves para la implementación, ya que una regla basada en la dificultad de la pregunta sería mucho más barata de calcular y no requeriría el muestreo múltiple costoso. La validación de que la señal aporta información adicional más allá de estas características superficiales es, por tanto, un requisito previo indispensable. Sin esta validación, no se puede afirmar que el método esté capturando la incertidumbre interna del modelo, lo que cuestiona la base teórica de la estrategia de enrutamiento propuesta. Esta limitación subraya la necesidad de pruebas rigurosas en dominios donde la dificultad de la pregunta no sea un predictor obvio del error del modelo.
Consideraciones para la implementación en producción
Antes de desplegar este sistema en producción, es crucial verificar la disponibilidad de código y datos para replicar los resultados. El preprint ofrece una lista de verificación general para evaluar señales de escalado, incluyendo la predicción de si una alternativa más barata basada en caché funcionará en un nuevo conjunto de datos.
Se recomienda probar el método con otros modelos, tareas, idiomas y configuraciones de coste. La generalización de los resultados de GSM8K a otros dominios no está garantizada. Además, se debe medir el coste total de inferencia, incluyendo la latencia del muestreo múltiple, para asegurar que la estrategia de enrutamiento es económicamente viable.
La viabilidad económica del sistema depende de un análisis detallado de los costes de inferencia, que a menudo se subestiman en las evaluaciones teóricas. El muestreo de múltiples respuestas del modelo pequeño introduce una latencia y un coste computacional que deben ser considerados en el balance global. Si la tasa de escalado es alta, el coste acumulado de las consultas que no se escalan (que requieren muestreo múltiple) más las que sí se escalan (que requieren muestreo múltiple más la inferencia del modelo grande) puede superar el coste de utilizar siempre el modelo grande. Por lo tanto, la estrategia de enrutamiento solo es económicamente viable si la señal de entropía logra mantener la tasa de escalada suficientemente baja. Esto requiere una calibración fina del umbral de entropía para equilibrar la precisión y el coste, un proceso que debe ser específico para cada configuración de modelos y dominio de aplicación. La falta de una cuantificación clara de este equilibrio en el resumen del preprint deja una incertidumbre significativa sobre la aplicabilidad práctica del método en escenarios de alto volumen.
Qué sigue abierto
- No se ha verificado la disponibilidad de código o datos para replicar los resultados.
- Los detalles metodológicos completos, como la definición operativa exacta de la entropía semántica y los umbrales utilizados, no están disponibles en el resumen.
- La generalización de los resultados a otros benchmarks, idiomas o familias de modelos no está confirmada.
- El impacto real del coste de inferencia en escenarios de producción no se ha cuantificado en el resumen.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección