Qué ha anunciado Liquid AI
Liquid AI presenta d1 como un modelo de decisión: en vez de redactar una respuesta libre, evalúa una entrada y devuelve resultados estructurados para una decisión delimitada. Su documentación describe tres familias de modelos: d1-3B, un modelo multimodal de texto e imagen; d1-omni-600M, que admite texto, imagen o audio; y d1Hosted, disponible mediante la API de Liquid AI.
El proveedor plantea este tipo de modelo para clasificación, priorización, moderación, asignación de solicitudes y otras tareas con resultados previamente definidos. La distinción es práctica: si el sistema debe escoger una etiqueta o una puntuación, puede responder en una estructura acotada; si debe explicar, resumir o escribir, hace falta una capacidad generativa. La documentación señala expresamente esos casos de generación abierta como usos para un modelo de lenguaje.
La disponibilidad descrita en la documentación no equivale a que cada modalidad, interfaz o modelo esté disponible en todos los entornos. Antes de integrar d1 conviene comprobar el modelo concreto, las entradas aceptadas, la API y las condiciones vigentes. El anuncio de la empresa también presenta como propios los resultados de comparación con Jev; esos resultados deben leerse como afirmaciones del proveedor, no como una validación independiente.
Cómo expresa sus decisiones
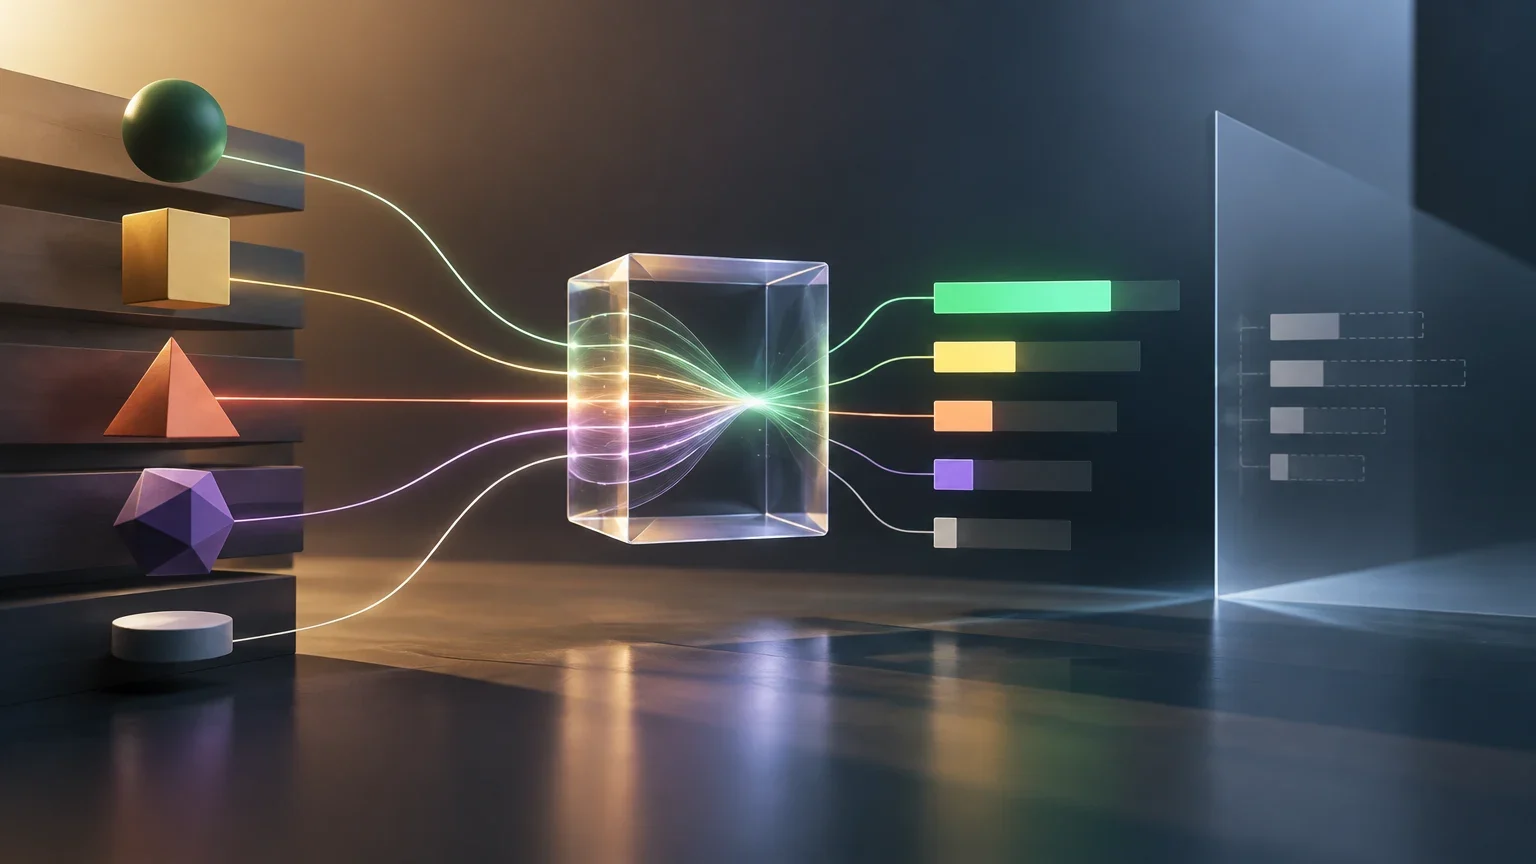
La documentación agrupa las consultas en tres primitivas. Choice selecciona entre categorías sin orden inherente y devuelve una distribución de probabilidades sobre las alternativas nombradas. Score sitúa la respuesta en una escala ordenada, como una rúbrica de gravedad. Noul plantea una pregunta binaria y devuelve una probabilidad entre 0 y 1; por ejemplo, la probabilidad de que un mensaje sea correo no deseado.
Esto permite distinguir entre elegir la opción más probable y conocer también cuánta incertidumbre queda entre las alternativas. Si un sistema asigna probabilidades similares a dos departamentos, puede derivar el caso a una revisión en vez de tratar la etiqueta ganadora como certeza. Pero que una salida sea probabilística no demuestra por sí solo que las probabilidades estén bien calibradas: esa propiedad debe medirse con datos representativos.
Liquid AI afirma que d1 no genera tokens de respuesta y que produce una decisión en una sola llamada. La expresión «cero tokens generados» describe la forma de producir la salida según el proveedor; por sí sola no informa de todos los conceptos de facturación, como el tratamiento de la entrada, la tarifa de la API o los costes de infraestructura. Tampoco basta para concluir que una tarea será siempre más rápida o barata que con un modelo generativo.
Dónde podría encajar en una empresa
La propuesta resulta más pertinente cuando las respuestas posibles están acotadas y la decisión se repite con frecuencia. Entre los usos descritos por Liquid AI están la clasificación de mensajes, el enrutamiento de tickets, la moderación, la evaluación de urgencia, las comprobaciones binarias de seguridad y la aprobación de llamadas a herramientas. Para entradas visuales se mencionan la inspección de imágenes y la clasificación; para audio, la detección de intención y el enrutamiento de comandos de voz en el modelo que admite esa modalidad.
Un ejemplo operativo es el triaje de solicitudes: el sistema asigna probabilidades a categorías conocidas y envía los casos ambiguos a una persona. Otro es una puerta de control que evalúa si una respuesta extraída cumple un requisito antes de aceptar el resultado. En ambos casos, la utilidad depende de que el catálogo de opciones represente los casos reales y de que exista una salida segura para entradas nuevas, incompletas o fuera de distribución.
D1 no sustituye automáticamente a un LLM. La propia documentación recomienda generación para escritura libre, conversación, resumen, código, preguntas abiertas y razonamiento complejo de varios pasos. Una arquitectura puede combinar ambos enfoques: usar un modelo de decisión para una clasificación acotada y recurrir a un modelo generativo o a una persona cuando se necesite una explicación o una respuesta abierta.
Elegir entre decisión estructurada y generación
| Necesidad | Enfoque que puede encajar | Qué comprobar |
|---|---|---|
| Asignar una solicitud a una categoría fija | Modelo de decisión, como Choice | Cobertura de categorías, casos ambiguos y opción de abstención o revisión |
| Puntuar gravedad según una escala definida | Modelo de decisión, como Score | Definición coherente de la escala y acuerdo con evaluadores humanos |
| Redactar una explicación o resumir un caso | Modelo generativo | Calidad del texto, fidelidad a la entrada y controles de seguridad |
| Responder una pregunta abierta o mantener una conversación | Modelo generativo | Razonamiento requerido, contexto y necesidad de seguimiento |
| Aceptar o rechazar una acción con criterios binarios | Modelo de decisión, como Noul | Coste de falsos positivos y negativos, umbral y supervisión |
Qué falta para valorar la comparación con Jev
Liquid AI afirma que d1 supera a Jev en el Decision Index de Hugging Face y también destaca resultados en evaluaciones multilingües, entradas largas y resistencia a la inyección de instrucciones. La existencia de una afirmación del fabricante no permite convertirla en un hecho verificado de manera independiente. Para interpretar el resultado hacen falta la versión exacta del benchmark, sus tareas, los datos evaluados, el protocolo, los modelos comparados y las condiciones de ejecución.
También es importante separar una puntuación agregada de los resultados por tarea. Un índice que reúne distintas clases de evaluación puede orientar una comparación, pero no predice por sí solo cómo funcionará un sistema de clasificación de facturas, moderación de mensajes o enrutamiento de tickets en una empresa concreta. El rendimiento puede cambiar con el idioma, la longitud de la entrada, el diseño de las etiquetas y la frecuencia de casos excepcionales.
Las fuentes aportadas no establecen una comparación independiente de precisión, calibración, latencia y coste frente a Jev o frente a modelos generativos bajo condiciones equivalentes. Para repetir con rigor la afirmación de que d1 «supera» a Jev habría que documentar las versiones comparadas, el conjunto de prueba y su metodología, y comprobar que el resultado sea reproducible fuera de la evaluación anunciada por el proveedor.
Prueba mínima antes de elegir un modelo
Evaluar una tarea representativa y comparar alternativas bajo el mismo protocolo.
- 01Definir la decisión, las opciones válidas y el coste de equivocarse.
- 02Preparar un conjunto de prueba separado de los ejemplos usados para ajustar instrucciones o umbrales.
- 03Incluir idiomas, entradas largas, errores de formato y casos que no encajen en ninguna categoría.
- 04Medir calidad por clase, calibración de probabilidades y tasa de derivación a revisión humana.
- 05Comparar latencia y coste total con una alternativa generativa en la misma infraestructura y con el mismo volumen.
- 06Repetir la evaluación al cambiar datos, configuración, versión del modelo o condiciones de servicio.
Límites y criterios prácticos
Las probabilidades son útiles solo si reflejan razonablemente la frecuencia de aciertos para el caso de uso. Una puntuación alta no debe interpretarse automáticamente como una garantía, y un umbral de decisión puede tener consecuencias distintas según el error: en moderación, por ejemplo, una falsa alarma y un contenido dañino que pasa inadvertido no tienen el mismo coste. La calibración y los umbrales deben comprobarse con datos pertinentes y revisarse cuando cambien las entradas.
También conviene observar el comportamiento ante información irrelevante, instrucciones maliciosas, categorías desconocidas y entradas incompletas. La afirmación empresarial de mayor resistencia a la inyección de instrucciones no elimina la necesidad de pruebas de seguridad propias. En tareas sensibles, una revisión humana, límites de actuación y un mecanismo para escalar casos inciertos son salvaguardas razonables.
Como regla de decisión, d1 merece una prueba cuando el resultado esperado cabe en una estructura definida y puede evaluarse con ejemplos representativos. Un LLM generativo encaja mejor si la tarea exige redactar o responder de forma abierta. Si el proceso mezcla ambas necesidades, se puede probar una canalización híbrida y comparar su calidad, latencia y coste total antes de cambiar un sistema de producción.
Qué sigue abierto
- No hay evidencia independiente aportada que confirme la comparación de rendimiento con Jev ni sus condiciones completas.
- Las fuentes aportadas no establecen resultados comparables de precisión, calibración, latencia y coste en tareas empresariales reales.
- No queda aclarado si «cero tokens generados» implica alguna diferencia concreta en facturación; debe verificarse en las condiciones de la API.
- La disponibilidad, las modalidades y las interfaces pueden variar según el modelo y el entorno; hay que confirmar el estado vigente antes de integrar.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección