Qué resuelve una traza de IA y qué no demuestra
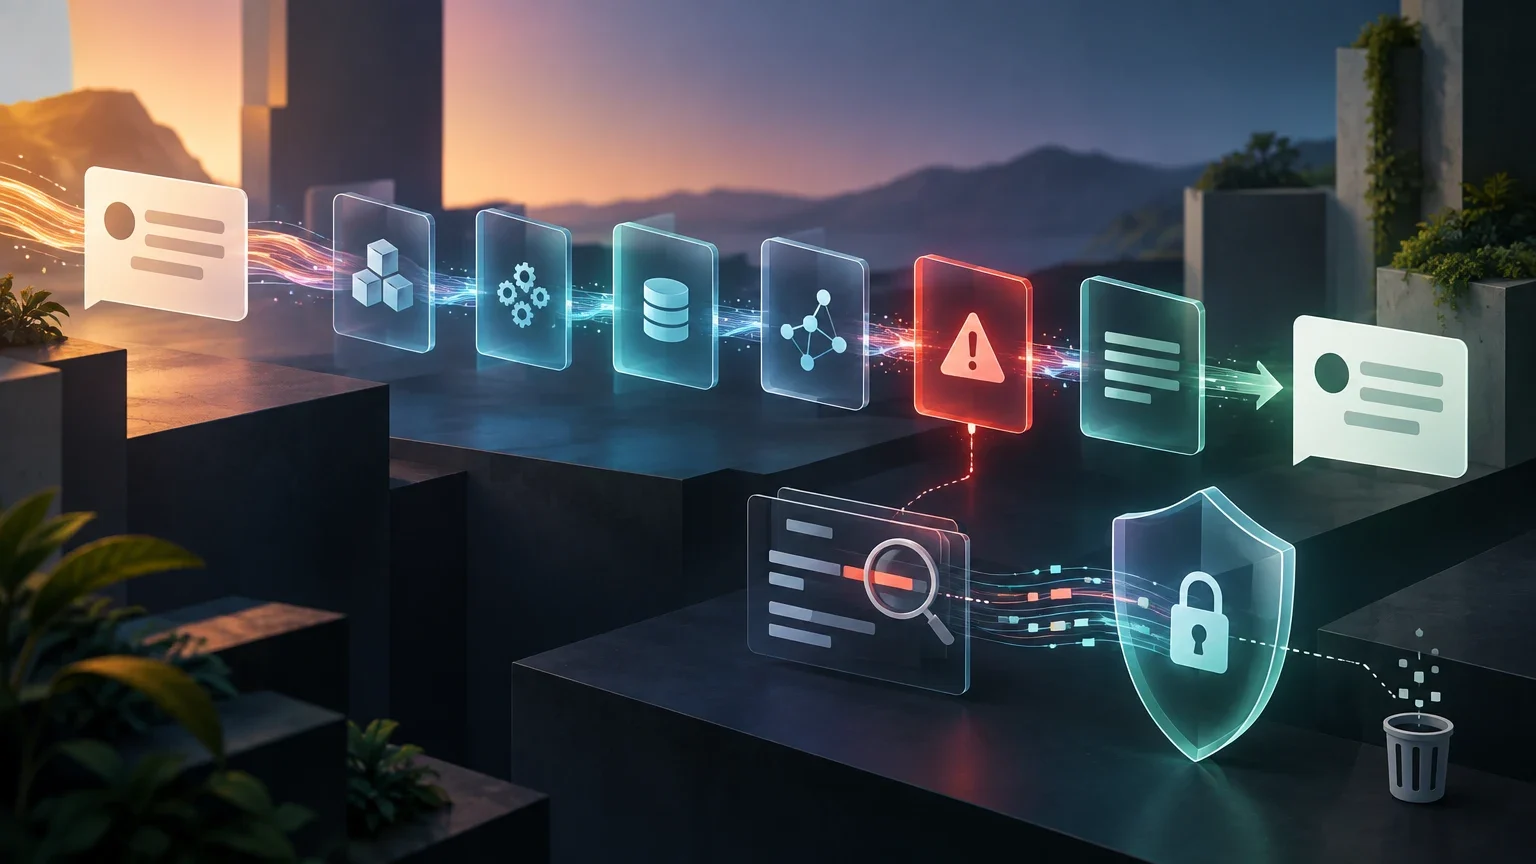
Una traza permite observar las operaciones que forman una petición y sus relaciones. En una aplicación con IA puede conectar la entrada recibida por el servicio, la recuperación de documentos, una o varias llamadas al modelo, las ejecuciones de herramientas, las validaciones y la respuesta entregada. Su utilidad principal es reconstruir el recorrido técnico: qué pasos ocurrieron, en qué orden y dónde se produjo una demora, un error o un resultado inesperado.
Una traza no demuestra por sí sola por qué un modelo generó una frase concreta, que la respuesta sea correcta ni que una ejecución futura vaya a repetirla. Es una representación de lo que el sistema instrumentado observó y decidió registrar. Si faltan spans, atributos o eventos, el recorrido puede quedar incompleto. Si se excluye contenido sensible, quizá tampoco sea posible inspeccionar literalmente la entrada o la respuesta; eso puede ser una decisión de privacidad deliberada, no un defecto de la traza.
Conviene separar los hechos observados de las hipótesis. “La llamada a la herramienta terminó con error” es una observación que puede figurar en la telemetría. “Ese error causó la respuesta incorrecta” es una interpretación que requiere revisar el flujo y, si es posible, contrastarlo con otras ejecuciones. La trazabilidad ayuda a localizar una causa probable; no sustituye las pruebas, la evaluación de calidad ni la revisión de los datos y las instrucciones del sistema.
Trazas, métricas y registros: señales distintas
Una traza representa una ejecución relacionada de extremo a extremo. Sus spans describen operaciones y pueden tener relaciones padre-hijo; por ejemplo, una operación de respuesta puede contener una recuperación y una generación, y esta última puede incluir una llamada a una herramienta. Los eventos asociados a un span añaden sucesos puntuales. Esta estructura permite recorrer una petición sin depender únicamente de buscar mensajes de texto parecidos.
Una métrica resume medidas para observar tendencias o estados agregados, como duración o cantidad de errores. Sirve para detectar cambios y comparar grupos de ejecuciones, pero normalmente no explica por sí sola qué ocurrió en una petición particular. Evita usar identificadores únicos de usuario, petición o documento como dimensiones de métricas: generan alta cardinalidad y dificultan mantener agregaciones manejables. Usa la traza para el detalle y métricas con dimensiones acotadas para la vigilancia agregada.
Un registro es un evento o mensaje independiente, por ejemplo, una advertencia de validación. Puede incluir contexto de traza para enlazarlo con una ejecución, pero no necesariamente conserva la estructura jerárquica de todos los pasos. En la práctica, las tres señales se complementan: métricas para descubrir una anomalía, trazas para recorrer una ejecución y registros para aportar contexto puntual. Ninguna exige guardar el contenido íntegro de una conversación.
Qué señal consultar primero
Decisión práctica: elige la señal según la pregunta y limita los atributos identificables a lo que realmente se necesita.
| Pregunta | Señal principal | Uso recomendado |
|---|---|---|
| ¿Aumentaron la latencia o los errores? | Métrica | Ver tendencias agregadas y acotar el periodo afectado. |
| ¿Qué operaciones recorrió esta petición? | Traza | Inspeccionar spans, relaciones, duración y resultado. |
| ¿Qué advertencia emitió un validador? | Registro o evento | Consultar el suceso y enlazarlo con la traza cuando exista contexto. |
Dibujar el mapa de una petición
Antes de instrumentar, dibuja el flujo real de la aplicación, no el que se supone que sigue. Un recorrido sencillo podría comenzar en el servicio de entrada, comprobar la solicitud, recuperar documentos, construir el contexto, llamar al modelo, ejecutar una herramienta si se solicita, validar la salida y devolver una respuesta. Puede haber reintentos, bifurcaciones, llamadas paralelas o una segunda generación después de una herramienta; deben aparecer como operaciones diferenciadas cuando sean relevantes para el diagnóstico.
Una jerarquía legible podría tener un span raíz para la operación de aplicación y spans hijos para recuperación, generación, herramienta y validación. La relación padre-hijo explica qué operación contiene a cuál; los enlaces de contexto pueden relacionar operaciones que no encajan limpiamente en una jerarquía simple. No hace falta crear un span por cada instrucción interna: instrumenta las fronteras donde se toman decisiones, se llama a una dependencia o puede fallar una operación.
Asigna un identificador de correlación a la ejecución y propágalo a las operaciones que participen en ella, incluidos los servicios propios que acepten contexto de traza. No conviertas ese identificador en parte del nombre del span ni en una dimensión de métrica. Los nombres deben describir operaciones de manera acotada y estable; valores únicos pertenecen, si son necesarios y seguros, a atributos de una traza con controles de acceso.
Campos mínimos para reconstruir el flujo
El esquema mínimo debe permitir contestar cuatro preguntas: ¿qué operación ocurrió?, ¿a qué ejecución pertenece?, ¿cuánto tardó?, ¿cómo terminó? Para ello suele ser útil registrar nombres estables de operaciones, relaciones entre spans, marcas temporales o duración, estado y una categoría de error. Añade atributos acotados que permitan distinguir, por ejemplo, tipo de operación o entorno. Los atributos concretos deben corresponder a la instrumentación y a las convenciones que realmente adopte el equipo.
En llamadas de generación también puede ser útil recoger información operacional, como el proveedor o modelo configurado, la duración, el estado y los contadores de uso disponibles. La disponibilidad y el significado de esos campos dependen de la integración: no supongas que dos instrumentadores llaman igual al mismo dato o lo calculan de la misma manera. Registra también si hubo recuperación, herramienta, reintento o validación, con estados que permitan distinguir “no ejecutado” de “ejecutado y fallido”.
Para localizar un resultado defectuoso sin conservar el prompt o cada documento, combina metadatos de flujo, cantidades y estados: número de resultados recuperados, resultado de la validación, tipo de error, versión identificable de la aplicación y tiempos por operación. Si hace falta comparar entradas, considera huellas o referencias internas con acceso restringido, pero evalúa si son reversibles o permiten vincular datos personales. Una huella no es automáticamente anónima. Evita registrar nombres, direcciones, tokens de acceso, argumentos completos de herramientas y documentos completos por comodidad.
Captura mínima frente a captura de contenido
La columna de captura mínima es un punto de partida de ingeniería, no un conjunto universal obligatorio.
| Necesidad de diagnóstico | Captura mínima posible | Riesgo al ampliar |
|---|---|---|
| Encontrar el paso lento | Duración por span y nombre de operación | Argumentos completos pueden revelar contenido sin mejorar la medición. |
| Saber si la recuperación devolvió resultados | Estado y cantidad de resultados | Registrar documentos enteros expone contenido y datos personales. |
| Entender un fallo de herramienta | Tipo de herramienta, estado y categoría de error | Los argumentos pueden contener secretos, identificadores o texto del usuario. |
| Comparar comportamiento de generaciones | Configuración identificable, estado y uso disponible | Prompt y respuesta completos aumentan la exposición y el coste de protección. |
Contenido sensible: reducir, redactar y controlar
Los prompts, respuestas, documentos recuperados y argumentos de herramientas pueden incluir datos personales, información confidencial o secretos operativos. Trátalos como contenido potencialmente sensible incluso si la aplicación no los clasifica así. La opción más segura para el diagnóstico habitual es no capturarlos por defecto. Si un caso de uso concreto necesita fragmentos, define qué fragmentos, quién puede consultarlos, durante cuánto tiempo y con qué proceso de aprobación.
La redacción puede eliminar o sustituir valores antes de exportarlos; el filtrado puede descartar datos o eventos que no deban salir del proceso. Decide en qué punto se aplican y verifica su efecto con datos de prueba. Una transformación posterior en el Collector puede reducir o modificar telemetría antes de exportarla, pero no debe confundirse con impedir que el contenido se haya generado, capturado o almacenado antes de llegar a ese componente. Revisa cada etapa de la ruta: instrumentador, búfer, Collector, exportador y almacenamiento.
Restringe el acceso a las trazas según la función de trabajo y registra el acceso cuando la plataforma lo permita. Define una retención breve que responda al tiempo necesario para investigar incidentes, y comprueba que las copias, exportaciones y búferes respeten esa política. El muestreo puede reducir volumen, pero no sustituye la protección de cada traza que sí se conserva. Conserva una vía controlada para elevar temporalmente el detalle durante una investigación, con autorización, alcance limitado y fecha de finalización.
Proceso de reducción antes de exportar
Aplica estos controles como diseño de referencia y valida su ubicación en la implementación concreta.
- 01Inventariar los campos que produce cada instrumentador, incluidos argumentos, entradas, salidas y excepciones.
- 02Clasificar los campos: necesarios para operar, útiles solo en investigaciones específicas o innecesarios.
- 03Desactivar la captura de contenido no requerida y redactar o filtrar los campos aprobados antes de su exportación.
- 04Probar con valores señuelo que la redacción cubre spans, eventos, registros y rutas de error, no solo el caso normal.
- 05Verificar destinos, permisos, búferes y plazos de eliminación; documentar quién puede elevar el nivel de captura.
Leer una traza para localizar el componente que falló
Empieza por el span raíz y confirma que representa la ejecución que quieres investigar. Comprueba su estado y recorre los hijos en orden temporal. Busca huecos entre operaciones, spans sin resultado o dependencias que hayan tardado de forma anómala respecto a su propio historial. Una duración total alta no identifica por sí sola el componente: puede deberse a una recuperación lenta, una llamada al modelo, espera de herramienta, reintentos o trabajo no instrumentado.
Si la respuesta no contiene información que debería haber recuperado, inspecciona primero el estado y la cantidad de resultados, los filtros de recuperación y la construcción del contexto. Si el contexto parece adecuado pero la generación falla o tarda, revisa el span de modelo, su estado y los reintentos. Si el modelo solicita una acción pero el resultado final es incorrecto, sigue el span de herramienta y comprueba si falló, devolvió datos inesperados o quedó fuera del flujo. Si la respuesta se generó pero no llegó al usuario, examina la validación y la operación que construye la salida.
Estas rutas son hipótesis de trabajo, no reglas para atribuir culpa automáticamente. Una herramienta puede devolver una respuesta válida que la aplicación procese mal; una validación puede rechazar una salida correcta por configuración; una traza incompleta puede ocultar una operación intermedia. Anota qué evidencia respalda cada conclusión y qué dato falta. Si el diagnóstico exige mirar contenido, solicita una captura temporal y aprobada en una ejecución de prueba, en lugar de activar indiscriminadamente el registro de prompts de usuarios.
Repetición no significa reproducción exacta
Volver a ejecutar una petición puede ayudar a comparar cambios, pero no garantiza que se reproduzca la respuesta original. El modelo puede producir variaciones; además, pueden cambiar el estado de la aplicación, los documentos recuperables, la versión del índice, el contenido de una herramienta externa o la configuración del servicio. Una repetición posterior puede recorrer spans parecidos y aun así no ser una reproducción exacta.
Para que una comparación sea más informativa, registra de forma segura y acotada la versión de la aplicación, la configuración relevante, los identificadores de modelo que la integración exponga, el estado o la versión del índice cuando se conozca y las versiones de herramientas propias. Anota también la hora y el entorno. Mantén las entradas de prueba bajo control, con contenido sintético o autorizado, si el objetivo permite hacerlo. Si una dependencia externa no ofrece una versión o instantánea, declara esa limitación en el análisis.
Distingue entre repetir una petición al sistema actual y reproducir una ejecución histórica con las mismas dependencias y estado. La primera sirve para observar el comportamiento presente; la segunda exige conservar y poder restablecer más condiciones, y puede ser impracticable o improcedente si implica retener datos sensibles. No llames “reproducible” a una prueba solo porque reutiliza el mismo texto de entrada. Describe qué se mantuvo igual, qué pudo cambiar y qué comparación sí se puede sostener.
OpenTelemetry GenAI: una base útil, todavía en desarrollo
OpenTelemetry publica convenciones semánticas para sistemas de IA generativa que cubren eventos, excepciones, métricas y spans relacionados con modelos y agentes. Su utilidad es ofrecer vocabulario compartido y facilitar que instrumentaciones distintas representen operaciones comparables. La documentación del proyecto marca estas convenciones como “Development”. Por tanto, son una referencia útil para evaluar nombres y atributos, no un contrato universal cuya estabilidad o adopción completa pueda darse por supuesta.
Antes de basar dashboards, alertas o exportaciones en atributos concretos, revisa la versión de las convenciones y la implementación que usa cada SDK. Comprueba qué campos se emiten, cómo se nombran, si incluyen contenido y qué ajustes modifican la captura. Dos instrumentadores pueden cubrir jerarquías parecidas pero diferir en nombres, valores, opciones de redacción, exportación o gestión de búferes. Esa variación obliga a probar la interoperabilidad y documentar el mapeo, en vez de asumirla.
La documentación del SDK de OpenAI Agents describe una jerarquía de spans para agentes, generaciones y herramientas, junto con opciones relacionadas con datos sensibles, exportación, buffering y redacción. También advierte que desactivar el trazado no elimina necesariamente datos que ya estén en un búfer. Esto ilustra una cautela general: una opción de apagado no debe tratarse como mecanismo de borrado retroactivo. Verifica el comportamiento en la versión concreta y considera todos los puntos donde los datos pueden permanecer.
No hay información suficiente en las fuentes disponibles para afirmar qué se captura por defecto en cada SDK o instrumentador oficial, ni para comparar exhaustivamente dos implementaciones y sus opciones. Esa respuesta debe obtenerse de la documentación de la versión desplegada y de una prueba controlada. Hasta verificarlo, adopta la hipótesis prudente: inspecciona el contenido exportado y configura explícitamente la reducción de datos.
Qué verificar antes de adoptar una convención
La convención orienta el esquema; la prueba de la implementación confirma el comportamiento efectivo.
| Aspecto | Comprobación práctica | Cautela |
|---|---|---|
| Estado y versión | Identificar la versión de las convenciones y del SDK. | El estado de desarrollo puede implicar cambios. |
| Cobertura | Comparar spans, eventos, métricas y excepciones emitidos. | Una categoría nombrada no garantiza que todos los instrumentadores la implementen. |
| Contenido sensible | Inspeccionar una exportación de prueba y probar la redacción. | No inferir los valores predeterminados de una descripción general. |
| Exportación y búfer | Verificar qué se exporta y qué puede quedar almacenado temporalmente. | Desactivar trazado no equivale a borrar datos ya almacenados. |
Lista de comprobación para instrumentar una aplicación
Empieza por un caso de uso operativo concreto: localizar latencia, fallos de recuperación, errores de herramientas o rechazos de validación. Dibuja el recorrido y acuerda nombres estables para los spans. Comprueba que el contexto se propaga entre componentes propios y que la traza permite seguir la petición completa sin incorporar identificadores únicos a nombres o métricas. Registra estados y duraciones antes de plantearte capturar contenido.
Revisa cada atributo con una pregunta sencilla: ¿qué decisión de operación permitirá tomar?, ¿contiene información sensible?, ¿cuánto tiempo debe conservarse?, ¿quién lo verá? Si no hay una respuesta clara, omítelo. Define redacción y filtrado en los puntos apropiados de la canalización, y prueba también excepciones, reintentos y fallos de exportación. Configura permisos, retención y muestreo de manera coherente con el riesgo y la necesidad de diagnóstico.
Por último, ejecuta pruebas controladas con una recuperación vacía, un error simulado de herramienta, una respuesta rechazada por validación y un caso normal. Comprueba que los spans distinguen los resultados y que no aparecen secretos ni contenido no aprobado en las exportaciones. Documenta las limitaciones conocidas, incluida la imposibilidad de repetir exactamente dependencias cambiantes. Revisa periódicamente la política: una instrumentación que era adecuada para un flujo puede dejar de serlo al añadir nuevos agentes, herramientas o tipos de datos.
Revisión operativa antes del despliegue
Usa esta lista como puerta de revisión y conserva evidencia de las pruebas realizadas.
- 01El recorrido incluye entrada, recuperación, generación, herramientas, validación y salida cuando existan.
- 02Cada span importante tiene nombre estable, relación comprensible, duración y estado.
- 03Las métricas usan dimensiones acotadas; no incluyen identificadores únicos de ejecución o usuario.
- 04La captura de prompts, documentos y argumentos está desactivada salvo necesidad justificada y aprobada.
- 05La redacción y el filtrado se prueban antes de exportar, también en rutas de error.
- 06Acceso, retención, búferes, destinos y muestreo tienen responsables y límites documentados.
- 07La prueba distingue hechos observados de hipótesis y registra qué dependencias impiden reproducir exactamente una ejecución.
Qué sigue abierto
- Las fuentes aportadas no permiten establecer qué contenido se captura por defecto en cada SDK o instrumentador ni comparar de forma exhaustiva dos implementaciones oficiales; hay que revisar la documentación de la versión desplegada y probar sus exportaciones.
- La disponibilidad, el nombre y el significado de atributos de tokens, modelo, recuperación o herramientas dependen de la integración y de la versión de las convenciones adoptada.
- No se puede garantizar una reproducción exacta cuando el modelo o las dependencias externas no ofrecen una versión o un estado que pueda conservarse y restablecerse.
- El punto efectivo de redacción depende de la arquitectura: una transformación del Collector puede actuar antes de exportar desde ese componente, pero no demuestra que el dato no se haya capturado o almacenado antes.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección