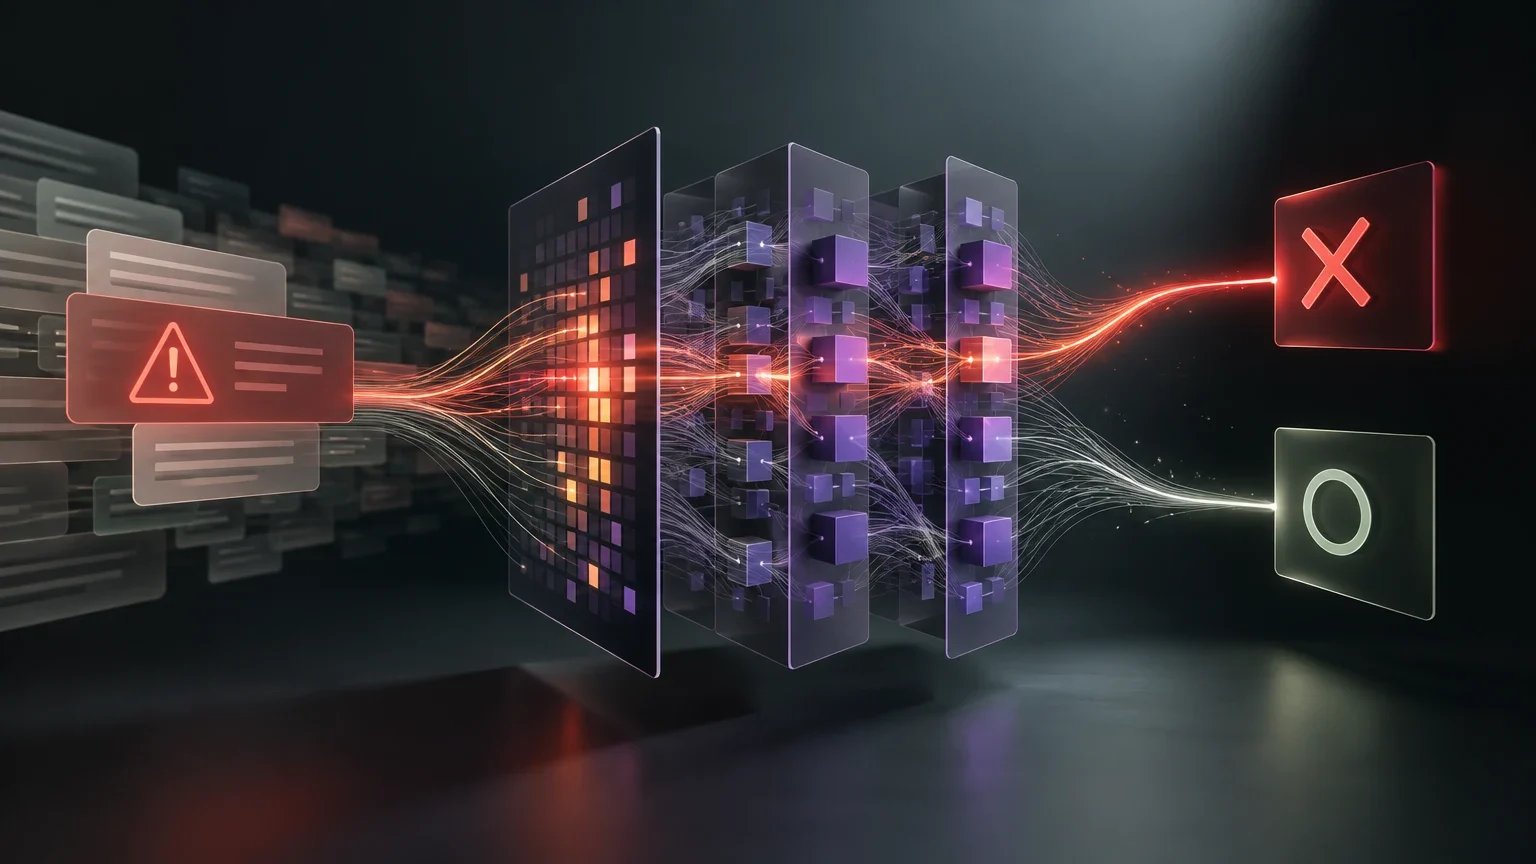
Distinguir entre reconocer el daño y escribir el rechazo
Los modelos de lenguaje alineados con la seguridad siguen siendo vulnerables a los jailbreaks y pueden rechazar en exceso solicitudes benignas. Para comprender estos fallos, es necesario distinguir entre el reconocimiento de la peligrosidad de una solicitud y el cálculo que genera la respuesta de rechazo.
Los autores del estudio reformulan este problema como una cuestión de ruta interna dentro del modelo. Proponen una medición en las actualizaciones del flujo residual de los Transformers de solo decodificación, separando la información de peligrosidad que una actualización de módulo expone del cambio que produce en la evidencia legible de rechazo.
Señales internas: atención y capas MLP
El análisis se centra en las actualizaciones de atención y en las capas de perceptrón multicapa (MLP). Los resultados indican que la información sobre la peligrosidad se decodifica más fácilmente de las actualizaciones de atención, especialmente en las capas iniciales del modelo.
Por otro lado, las actualizaciones de MLP contribuyen de manera más fuerte a la escritura selectiva de rechazos en los modelos alineados. Esto sugiere una división funcional donde la atención actúa como sensor y las capas MLP como el mecanismo de ejecución de la respuesta de seguridad.
Roles de los módulos en la ruta de seguridad
Comparación de la función de la atención y las capas MLP según el estudio.
| Módulo | Función principal | Ubicación predominante |
|---|---|---|
| Atención | Decodificación de información de peligrosidad | Capas iniciales |
| MLP | Escritura selectiva de rechazo | Capas más profundas (post-entrenamiento) |
Alcance de la muestra: 18 pares de modelos
El estudio evalúa 18 pares de modelos Base-Instruct que abarcan las familias Qwen, Llama y Gemma. Esta selección permite observar patrones comunes en arquitecturas de solo decodificación ampliamente utilizadas.
Se observa que el entrenamiento posterior (post-training) fortalece la escritura de rechazo en las capas MLP en los 18 pares, sin mejorar sistemáticamente la decodificabilidad de la peligrosidad. Además, la escritura positiva de MLP se vuelve más concentrada en capas más profundas tras el entrenamiento posterior.
Intervenciones causales y el método Sentinel
Las intervenciones causales respaldan esta ruta: restablecer las actualizaciones de MLP aguas abajo a sus valores limpios reduce sustancialmente el cambio de rechazo causado por intervenciones de atención aguas arriba. Esto confirma la dependencia funcional entre ambos módulos.
Basándose en estos hallazgos, los autores introducen Sentinel, un método que combina una puntuación de percepción derivada de la atención (P) con una puntuación de decisión derivada de MLP (D). El enrutamiento condicional con ambas señales logra una tasa de error agregada más baja que el enrutamiento de señal única en ocho modelos evaluados.
Flujo de Sentinel
Proceso de evaluación de seguridad propuesto.
- 01Extraer puntuación de percepción (P) de las actualizaciones de atención.
- 02Extraer puntuación de decisión (D) de las actualizaciones de MLP.
- 03Aplicar enrutamiento condicional basado en el perfil conjunto de P y D.
- 04Comparar la tasa de error contra baselines de señal única.
Implicaciones y limitaciones del estudio
En seis modelos con capacidad de razonamiento, la peligrosidad sigue siendo decodificable durante el razonamiento, mientras que la escritura fuerte de rechazo se concentra al inicio de la respuesta. Este patrón persiste incluso con el razonamiento desactivado.
Es importante señalar que este es un preprint y no un trabajo revisado por pares. Los resultados no demuestran que los jailbreaks queden resueltos, sino que ofrecen una herramienta para diagnosticar fallos. La reproducibilidad completa y la robustez ante todas las variantes de prompts requieren verificación adicional más allá del resumen del preprint.
En los seis modelos con capacidad de razonamiento, la persistencia de una señal decodificable de peligrosidad durante el razonamiento, junto con la concentración temprana de la escritura fuerte de rechazo, separa temporalmente dos patrones que podrían confundirse si solo se examinara la respuesta final. Que el patrón persista cuando el razonamiento está desactivado amplía lo observado dentro de esas condiciones estudiadas, pero no demuestra que se mantenga en toda configuración de razonamiento ni ante cualquier prompt.
Las limitaciones señaladas afectan a la fuerza con que pueden generalizarse los resultados. El trabajo es un preprint y la revisión por pares y la replicación independiente no están confirmadas. Además, la robustez ante todas las variantes de jailbreaks y prompts ambiguos no queda completamente verificada en el resumen, y la reproducibilidad exacta de las mediciones requiere acceso al código y a los datos completos, que no se detallan allí. Estas reservas aconsejan tratar las conclusiones como evidencia preliminar, no como una validación exhaustiva del método.
La contribución descrita es diagnóstica: ofrece una forma de separar señales asociadas con el reconocimiento de peligrosidad de aquellas vinculadas con la escritura de rechazo. No demuestra que los jailbreaks queden resueltos ni que el enrutamiento elimine el rechazo excesivo. Para sostener afirmaciones más amplias haría falta verificar la reproducibilidad y la robustez más allá de la información resumida, manteniendo la distinción entre un resultado observado en los modelos evaluados y una garantía general de seguridad.
Qué sigue abierto
- No se ha confirmado la revisión por pares del estudio.
- La robustez ante todas las variantes de jailbreaks y prompts ambiguos no está completamente verificada en el resumen.
- La reproducibilidad exacta de las mediciones requiere acceso al código y datos completos, no detallados en el abstract.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección