Definición en una frase
Familia de métodos que usa preferencias humanas para entrenar señales de recompensa y orientar el comportamiento de un modelo.
Qué es RLHF
El aprendizaje por refuerzo a partir de retroalimentación humana —RLHF, por sus siglas en inglés— es una familia de métodos que utiliza evaluaciones o preferencias humanas para construir una señal de recompensa y orientar la optimización de un modelo. En una implementación habitual, las personas comparan varias respuestas posibles; esas comparaciones se usan para entrenar un modelo de recompensa, que después puntúa respuestas generadas por la política que se está ajustando.
La idea resulta útil cuando es más fácil juzgar cuál de dos resultados es preferible que escribir una regla matemática completa para definir el resultado ideal. Una persona puede, por ejemplo, valorar si una respuesta es clara, pertinente o prudente. El modelo de recompensa aproxima esos juicios en los datos disponibles; no convierte por sí mismo criterios subjetivos en una definición universal de calidad.
RLHF no designa una única receta invariable. Puede cambiar el tipo de feedback, el modo de recogerlo, el modelo utilizado para aprender las preferencias y el método de optimización posterior. En modelos de lenguaje, una configuración conocida combina ajuste fino supervisado, comparaciones humanas, entrenamiento de una recompensa y optimización por aprendizaje por refuerzo. PPO es un algoritmo posible en esa última etapa, no un requisito para toda técnica basada en preferencias humanas.
La definición también exige separar la señal humana del procedimiento que la procesa. La preferencia observada es un dato, el modelo de recompensa es una aproximación aprendida y la política optimizada es el sistema que se busca modificar. Confundirlos lleva a exagerar lo que el método demuestra: mejorar una puntuación aprendida no prueba por sí solo que el modelo sea veraz, seguro o representativo de todas las personas.
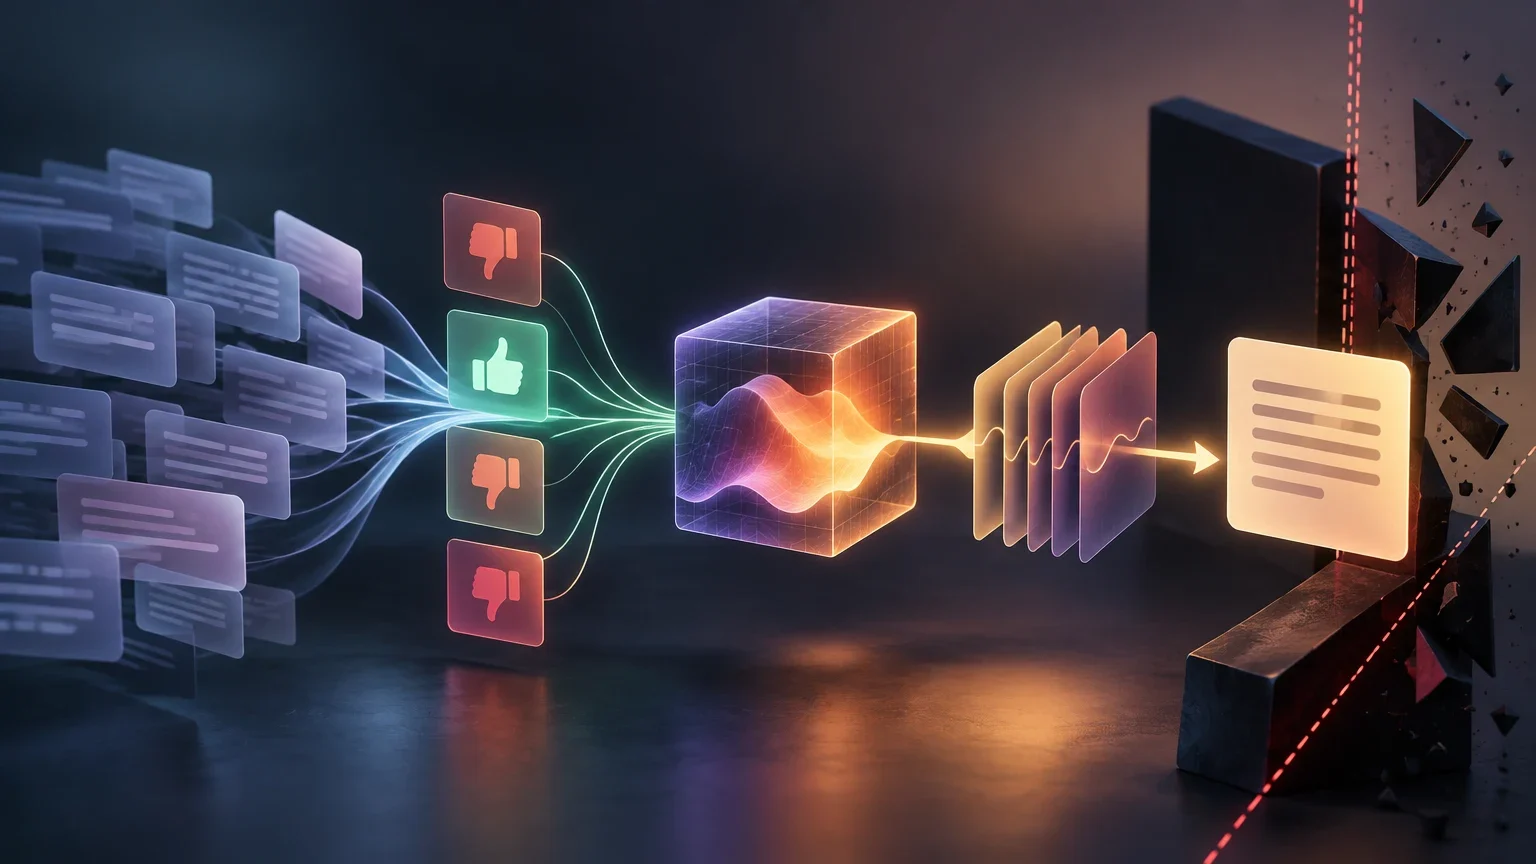
El flujo técnico, de los datos a la política
En un flujo frecuente para modelos de lenguaje, el proceso empieza con una política inicial capaz de producir respuestas. Esta política puede proceder de un modelo preentrenado y pasar antes por un ajuste fino supervisado, en el que aprende a imitar respuestas de demostración. Las demostraciones y las preferencias cumplen funciones distintas: las primeras muestran ejemplos de comportamiento; las segundas permiten comparar candidatos.
A continuación, el sistema genera varias respuestas para una misma instrucción. Anotadores humanos las comparan o clasifican con criterios definidos para el proyecto. Una comparación por pares puede indicar que, ante una pregunta concreta, la respuesta A se prefiere a la B. El juicio recoge una decisión contextual, no necesariamente el motivo completo ni el acuerdo de todos los evaluadores.
Con las comparaciones se entrena un modelo de recompensa. En el caso usual de preferencias por pares, aprende a asignar puntuaciones de modo que la respuesta elegida tienda a puntuar más que la descartada. Después, la política genera nuevas respuestas y se optimiza para obtener puntuaciones altas según esa recompensa aprendida. Algoritmos como PPO pueden actualizar la política; en algunas configuraciones también se limita cuánto se aleja de un modelo de referencia.
El ciclo produce artefactos diferentes en cada etapa: demostraciones para el ajuste supervisado, pares o rankings anotados, un modelo de recompensa y una política ajustada. Mantenerlos diferenciados facilita auditar qué señal entró en el sistema y qué transformación se aplicó. Si se omite una etapa —por ejemplo, se ajusta directamente con demostraciones—, no debe describirse automáticamente como el flujo clásico de RLHF con un modelo de recompensa explícito.
Este esquema es una referencia, no una especificación universal. Hay diseños que usan otras formas de feedback o métodos de optimización distintos. También existen enfoques de optimización de preferencias que evitan entrenar una recompensa separada y aplicar después un ciclo convencional de aprendizaje por refuerzo; por eso conviene nombrar el método concreto, en vez de asumir que toda alineación basada en preferencias sigue exactamente los mismos pasos.
Etapas habituales y sus resultados
El orden siguiente resume una configuración frecuente para un modelo de lenguaje; los detalles varían entre implementaciones.
- 01Preparar una política inicial; si corresponde, ajustarla con demostraciones supervisadas.
- 02Generar varias respuestas para instrucciones seleccionadas.
- 03Recoger comparaciones, rankings u otras evaluaciones humanas bajo criterios definidos.
- 04Entrenar un modelo de recompensa que aproxime las preferencias observadas.
- 05Optimizar la política con esa recompensa, usando un algoritmo de aprendizaje por refuerzo cuando el diseño lo requiera.
- 06Evaluar el modelo resultante por separado: la recompensa de entrenamiento no sustituye una evaluación independiente.
Ejemplos aplicados
En un asistente conversacional, ante una misma pregunta se pueden mostrar dos respuestas a evaluadores. Estos podrían preferir la que responde directamente, distingue hechos de incertidumbres y evita contenido irrelevante. Las comparaciones sirven para aprender una recompensa orientada a esos criterios y luego ajustar la política. El ejemplo ilustra el mecanismo, pero no afirma que un asistente específico haya sido entrenado de esta manera.
En moderación de contenido, los evaluadores podrían comparar decisiones del sistema sobre un mismo fragmento: permitir, retirar o enviar a revisión. El feedback puede reflejar reglas y prioridades definidas para un contexto particular. Antes de usarlo para optimizar una política, habría que especificar el daño que se intenta reducir, el coste de falsos positivos y falsos negativos y las vías de apelación. La preferencia de un grupo de anotadores no constituye por sí sola una norma social universal.
En recomendación, una persona puede preferir un resultado a otro dentro de una situación concreta: por ejemplo, una opción relevante para una búsqueda puntual frente a una opción popular pero poco ajustada a la consulta. Esa comparación podría alimentar un modelo de recompensa para ordenar resultados. Sin embargo, un clic o una elección observada no siempre expresa satisfacción: puede depender de la posición, la interfaz o de información incompleta. Antes de traducir esa conducta en feedback, es necesario aclarar qué objetivo se intenta aproximar.
En los tres casos, el núcleo es el mismo —usar juicios para construir una señal de optimización—, pero cambian la unidad evaluada, las personas que juzgan y las consecuencias de equivocarse. Por ello, describir una aplicación exige separar lo que es un ejemplo conceptual de lo que está documentado para un sistema real.
RLHF y conceptos próximos
El ajuste fino supervisado directo entrena un modelo con demostraciones: se proporciona una entrada y una respuesta de referencia, y el modelo aprende a producir una respuesta parecida. Eso no requiere necesariamente aprender una recompensa a partir de comparaciones ni optimizar después la política mediante aprendizaje por refuerzo. Puede formar parte del flujo de RLHF como etapa inicial, pero no es sinónimo de todo el procedimiento.
El aprendizaje por refuerzo sin feedback humano utiliza una recompensa definida por otra vía, por ejemplo una puntuación automática o una condición verificable. Sigue siendo aprendizaje por refuerzo, pero no se convierte en RLHF solo porque el sistema optimice una recompensa. A la inversa, que una persona participe en una anotación no basta para demostrar que se entrenó un modelo de recompensa o que se aplicó aprendizaje por refuerzo.
El aprendizaje en contexto ocurre cuando un modelo usa instrucciones y ejemplos presentados durante la consulta para producir una salida, sin que por ello se actualicen sus parámetros mediante el entrenamiento descrito. Puede influir en el comportamiento observado en una conversación, pero no es, por sí solo, RLHF.
Estos métodos no siempre son alternativas excluyentes. Un sistema puede usar demostraciones supervisadas antes de recoger preferencias y combinar varias formas de evaluación durante su desarrollo. Técnicas de optimización directa de preferencias, como DPO, usan datos de preferencias sin seguir necesariamente el ciclo explícito de entrenar una recompensa separada y optimizarla mediante un algoritmo de RL. La etiqueta más precisa depende de los componentes que realmente se hayan usado.
Guía para distinguir métodos
La presencia de feedback humano no basta para identificar todas las etapas del entrenamiento.
| Método | Señal principal | Qué no implica por sí solo |
|---|---|---|
| RLHF habitual | Preferencias humanas usadas para aprender una recompensa y orientar la política | No garantiza veracidad, seguridad ni consenso universal |
| Ajuste supervisado directo | Demostraciones de entradas y salidas deseadas | No exige un modelo de recompensa ni optimización por RL |
| Aprendizaje por refuerzo sin feedback humano | Recompensa automática, programada o verificable | No es RLHF si la señal no procede de feedback humano |
| Aprendizaje en contexto | Instrucciones y ejemplos suministrados en la consulta | No implica actualizar los parámetros del modelo |
| Optimización directa de preferencias | Pares o rankings de preferencias usados directamente en el ajuste | No exige necesariamente el ciclo explícito de recompensa más RL |
Qué permite concluir la preferencia y qué no
Una comparación humana registra una elección bajo condiciones específicas: quién evaluó, qué alternativas vio, con qué instrucciones y en qué momento. Puede ayudar a entrenar un sistema para imitar patrones de preferencia de ese conjunto, pero no demuestra que la elección represente a toda la población ni que refleje valores estables en contextos distintos.
El modelo de recompensa es un sustituto aprendido de los juicios que recibió. Puede generalizar mal a instrucciones o respuestas fuera de su cobertura, confundir una señal superficial con la cualidad deseada o puntuar de forma inconsistente. Si la política se optimiza intensamente contra esa señal, puede encontrar resultados que obtienen una puntuación alta sin cumplir el objetivo humano subyacente; este riesgo suele llamarse explotación o sobreoptimización de la recompensa.
También influyen las decisiones del proceso: cómo se redactan los criterios, qué alternativas se generan, qué perfiles de anotadores participan, cómo se resuelven los desacuerdos y qué distribución de instrucciones se usa. La falta de variedad puede dejar preferencias o situaciones poco representadas. No se corrige automáticamente con más optimización; la calidad de la señal y la cobertura de evaluación siguen siendo determinantes.
Por estas razones, RLHF no certifica por sí solo seguridad ni veracidad. Un modelo puede sonar más útil para los evaluadores y continuar cometiendo errores factuales. Las propiedades deseadas requieren pruebas específicas, evaluación fuera de los datos de entrenamiento, análisis de fallos y, en usos de riesgo, salvaguardas operativas y supervisión apropiadas. La recompensa debe leerse como un objetivo de entrenamiento, no como un certificado de comportamiento.
Errores frecuentes y criterios prácticos
Un error frecuente es decir que «los humanos enseñan directamente los valores al modelo». En un flujo habitual, las personas aportan juicios acotados y un modelo de recompensa aprende a predecirlos. La política se ajusta después a esa aproximación. El resultado depende de cómo se definieron los criterios, quién anotó y cómo se entrenaron y evaluaron los componentes.
Otro error es tratar como equivalentes demostraciones, comparaciones y puntuaciones. Una demostración ofrece un ejemplo de salida; una comparación indica cuál de varias opciones se prefiere; una puntuación asigna una valoración según una escala. Son señales diferentes y requieren interpretaciones y procedimientos de entrenamiento distintos. Asimismo, no se debe llamar RLHF a cualquier ajuste posterior al preentrenamiento si no se ha verificado la intervención de preferencias humanas y el mecanismo utilizado.
También conviene evitar afirmar que el método «alinea el modelo con los valores humanos» sin especificar de quién son los juicios y cómo se midió el resultado. Una formulación más precisa identifica la tarea, la población de evaluadores, el tipo de feedback y el alcance de la evaluación. Si solo hay un ejemplo ilustrativo, debe presentarse como escenario hipotético y no como resultado observado.
Para revisar una afirmación sobre RLHF, pregunta: ¿qué se evaluó?, ¿quién lo evaluó?, ¿qué señal se produjo?, ¿se entrenó un modelo de recompensa separado?, ¿qué algoritmo modificó la política?, ¿qué evaluación independiente respalda la conclusión? Estas preguntas permiten distinguir una descripción técnica concreta de una afirmación general sobre alineación.
Esta ficha se centra en modelos de aprendizaje automático y, especialmente, en el flujo habitual aplicado a modelos de lenguaje. El libro técnico de Nathan Lambert ofrece una exposición amplia de los métodos y etapas de RLHF, pero la página consultada presenta el libro en una versión de arXiv; esta evidencia, por sí sola, no permite afirmar que sea una obra revisada por pares. La documentación explicativa de AWS aporta una descripción complementaria del flujo, aunque no sustituye los artículos primarios de cada implementación.
Lista de comprobación antes de describir un sistema
Usa estas preguntas para evitar confundir una etapa, una señal de datos y una garantía de desempeño.
| Pregunta | Qué aclarar |
|---|---|
| ¿Qué feedback se recogió? | Comparaciones, rankings, puntuaciones, correcciones o demostraciones |
| ¿Quién evaluó? | Población, especialización, instrucciones y procedimiento para discrepancias |
| ¿Cómo se usó? | Ajuste supervisado, entrenamiento de recompensa, optimización directa u otra vía |
| ¿Qué afirmación se quiere hacer? | Preferencia observada, calidad, seguridad, veracidad u otro resultado |
| ¿Qué evidencia la sostiene? | Evaluación específica, externa al entrenamiento y adecuada al contexto |