Le vrai problème : relier des applications ne revient pas à automatiser une décision
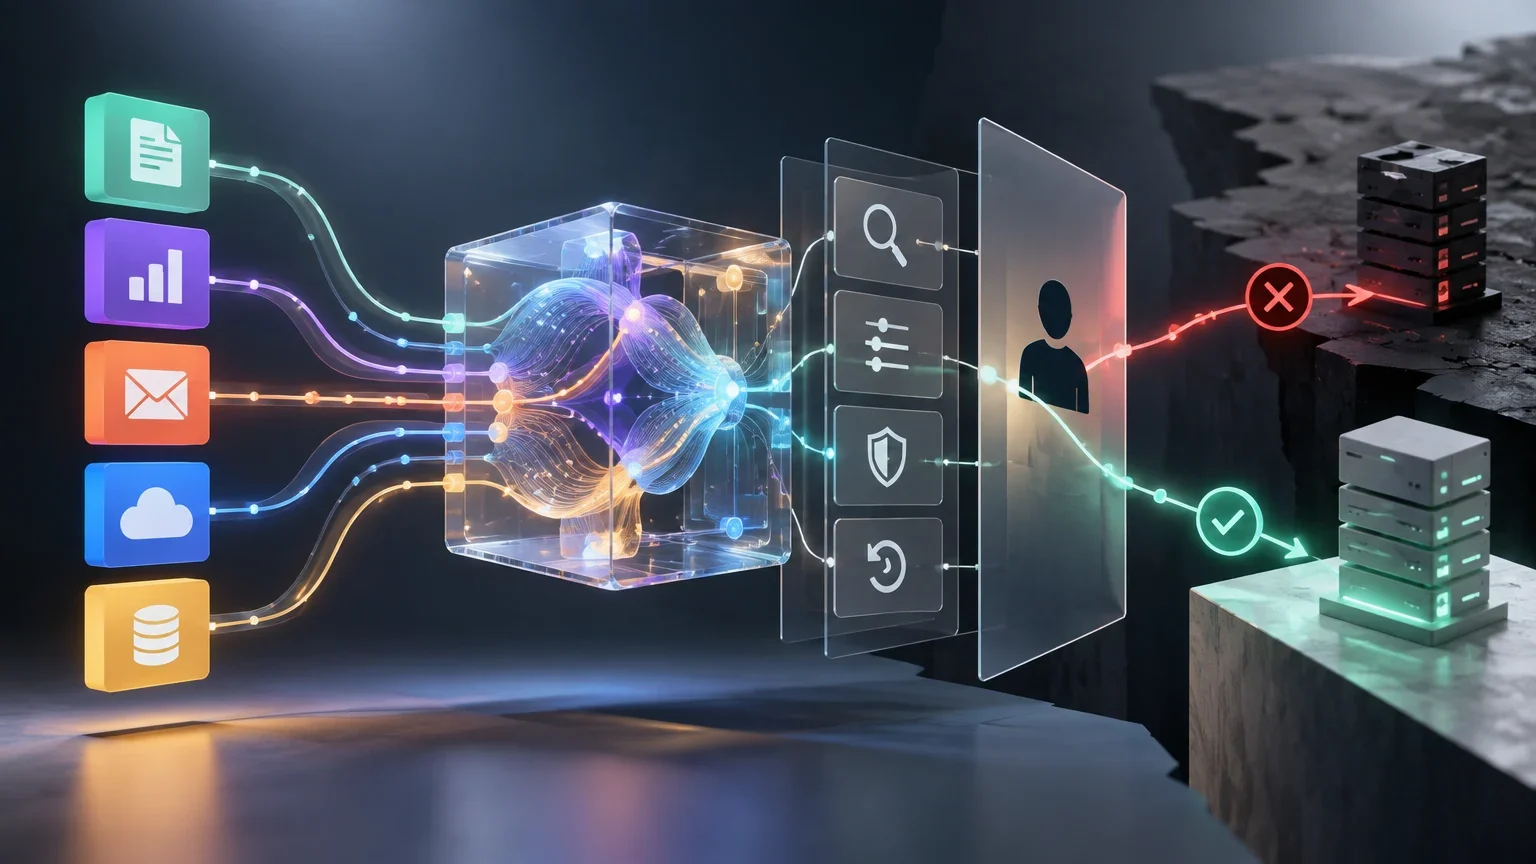
Un flux entre CRM, messagerie, tickets, documents, feuilles de calcul et systèmes internes est souvent présenté comme une chaîne simple : une donnée arrive, un modèle l’interprète et une application reçoit une action. Cette description omet pourtant les éléments qui déterminent le risque opérationnel. Il faut savoir quel événement a déclenché l’exécution, quelles données ont été fournies au modèle, quelle règle a limité sa réponse, quelle validation a été appliquée, qui a autorisé l’action et ce que le système cible a confirmé.
L’IA peut être utile pour les tâches dont les entrées sont non structurées ou variables, telles que résumer un e-mail, extraire des champs d’une facture ou proposer une catégorie pour un ticket. Elle ne transforme pas à elle seule ce résultat en instruction fiable permettant de modifier un enregistrement, d’envoyer une communication ou de clôturer un dossier. La sortie du modèle doit être traitée comme une proposition qui exige un format attendu, des limites de valeurs, des règles métier et, selon l’impact, une revue humaine.
Le choix d’un outil devrait commencer par le processus, non par le catalogue d’intégrations. Deux outils peuvent relier les mêmes applications tout en différant fortement lorsqu’il s’agit de tester une modification, conserver l’historique, séparer les configurations, comparer des versions ou arrêter une action risquée. Ces capacités deviennent déterminantes lorsqu’une classification est erronée, qu’un document est incomplet, qu’une intégration répond de façon ambiguë ou qu’une exécution est répétée après une erreur réseau.
Il convient aussi de distinguer deux questions souvent confondues. La première est de savoir si le flux peut produire une décision utile. La seconde est de savoir si l’organisation peut l’inspecter, la corriger et se remettre de ses effets. Ce guide se concentre sur la seconde. Il n’évalue pas la qualité intrinsèque des modèles et ne promet pas d’autonomie ; il propose une manière de déterminer l’architecture opérationnelle et les contrôles minimaux nécessaires dans chaque cas.
Lors de l’exploration d’outils dans les sections découvrir, comparer et apprendre du site, utilisez le même cas métier et les mêmes données de test. Vous éviterez ainsi d’attribuer à la plateforme des différences qui proviennent d’un autre déclencheur, d’une autre instruction donnée au modèle ou d’une autre configuration d’identifiants.
Les quatre architectures : choisissez le degré d’automatisation selon le risque de l’action
L’architecture appropriée dépend de la nature de l’entrée et des conséquences d’une erreur. Une recommandation interne réversible n’exige pas les mêmes contrôles qu’une mise à jour financière, un message adressé à un client ou la clôture d’un incident. Le volume compte, mais il ne remplace pas l’analyse d’impact : une petite erreur répétée des milliers de fois peut coûter davantage qu’une erreur isolée à fort impact.
La première architecture repose sur des règles déterministes avec une IA auxiliaire. Le modèle résume, traduit, extrait des termes ou rédige un brouillon, tandis que les règles décident de l’orientation et de l’action. Elle convient lorsque la décision peut s’exprimer par des critères stables et vérifiables. Par exemple, une règle attribue les tickets selon le produit et le niveau de service ; l’IA génère uniquement un résumé pour l’agent qui les reçoit.
La deuxième est l’extraction et le routage. L’IA transforme ici une entrée variable en champs structurés, puis le flux dirige le cas vers une file, un système ou un responsable. Cette approche fonctionne mieux lorsque l’ensemble des sorties est borné : type de document, langue, priorité autorisée ou catégorie de demande. Elle doit inclure une validation du schéma, des valeurs autorisées et un chemin explicite pour les données incomplètes, contradictoires ou hors classification.
La troisième est la revue humaine intégrée. Le flux rassemble le contexte, prépare une proposition et s’arrête jusqu’à ce qu’une personne approuve, refuse ou modifie celle-ci. La documentation de Power Automate décrit des flux pouvant attendre une décision d’approbation, tandis que la documentation de Zapier décrit des demandes de collecte de données ou d’approbation avant la poursuite du flux. Ces fonctions sont utiles lorsque le critère exige du jugement, que la donnée est sensible ou que l’erreur n’est pas aisément réversible. Elles ne suppriment pas la responsabilité humaine : elles rendent visible le point où la décision est prise.
La quatrième est l’exécution autonome limitée. Le flux peut réaliser une action sans approbation à chaque cas, mais seulement dans un périmètre défini : champs précis, applications autorisées, montants ou états limités, horaires d’exécution et règles de blocage. C’est une option pour les tâches fréquentes, à faible impact et réversibles, après avoir démontré par des éléments probants que les entrées et les défaillances prévisibles sont couvertes. Elle ne devrait pas constituer le point de départ pour des actions irréversibles ou de grande portée.
Le terme « autonome » ne doit pas être compris comme l’absence de contrôles. Dans une architecture limitée, l’autonomie est encadrée par les autorisations, les validations, les seuils, les journaux et les mécanismes d’arrêt. Si l’outil n’indique pas précisément quelle version a exécuté une action, avec quelle entrée et quel résultat, l’organisation aura du mal à étendre ce modèle de manière responsable.
Architectures opérationnelles et seuil d’utilisation
| Architecture | Usage principal | Action externe | Contrôle minimal |
|---|---|---|---|
| IA auxiliaire avec règles | Résumé, rédaction ou aide contextuelle | Décidée par des règles fixes | Validation des entrées et journalisation de la sortie |
| Extraction et routage | Transformer des documents ou messages en champs | Envoyer vers une file ou créer un brouillon | Schéma, valeurs autorisées et chemin d’exception |
| Revue humaine intégrée | Cas ambigus ou sensibles | Uniquement après approbation, refus ou modification | Contexte suffisant, responsable identifié et preuve de la décision |
| Autonomie limitée | Tâches répétables et réversibles | Dans des limites prédéfinies | Limites de périmètre, confirmation et annulation ou rapprochement |
Cartographie du flux : d’un déclencheur à une reprise vérifiable
Avant d’évaluer une plateforme, dessinez le flux complet. Le déclencheur identifie ce qui l’initie : un e-mail reçu, un document déposé, un changement d’état ou une nouvelle ligne. Vient ensuite le contexte : données client, historique du ticket, champs du document, règles applicables et toute information fournie au modèle. Le contexte doit suffire à la décision sans être plus étendu que nécessaire, en particulier lorsqu’il contient des données personnelles ou confidentielles.
La décision transforme ce contexte en sortie opérationnelle, telle qu’une catégorie, un ensemble de champs ou une proposition de réponse. La validation vérifie que la sortie existe, respecte le format, appartient à l’ensemble autorisé et est cohérente avec des règles indépendantes du modèle. L’action peut créer, modifier, envoyer, escalader ou bloquer un élément dans une autre application. Le journal conserve les preuves nécessaires pour comprendre l’exécution. La reprise définit quoi faire si l’action a échoué, est restée dans un état inconnu ou ne s’est exécutée que partiellement.
Cette cartographie fait apparaître une différence essentielle entre échec et ambiguïté. Un échec clair est, par exemple, un rejet explicite du système cible. Un résultat ambigu se produit lorsque le délai d’attente expire après l’envoi de la demande : le système cible a peut-être effectué la mise à jour, bien que le flux n’ait reçu aucune confirmation. Réessayer automatiquement sans clé d’idempotence, requête de vérification ou règle de rapprochement peut dupliquer un message, une commande ou un enregistrement.
Les outils de test doivent être évalués face à ces situations. Le guide Microsoft sur les tests de flux mentionne l’utilisation de données de test et de l’historique des exécutions, et avertit que la réexécution d’une exécution peut créer des doublons selon les actions concernées. Ainsi, « réexécuter » ne signifie pas « reprendre en toute sécurité ». Demandez quelles étapes seront répétées, lesquelles peuvent être consultées avant répétition et comment les tentatives sont reliées à l’opération initiale.
La traçabilité ne signifie pas non plus tout conserver indéfiniment. Microsoft indique que les entrées et sorties peuvent être visibles dans l’historique d’exécution et que des options permettent de les protéger. Masquer des données sensibles réduit l’exposition, mais peut limiter l’enquête ultérieure. La décision devrait préciser quels champs sont masqués, quels identifiants non sensibles restent disponibles, qui peut consulter les journaux et pendant combien de temps.
Conception minimale d’une exécution récupérable
- 01Définissez l’événement déclencheur et attribuez un identifiant de corrélation à l’exécution.
- 02Récupérez uniquement le contexte nécessaire et enregistrez des références stables aux données sources.
- 03Obtenez une sortie structurée du composant d’IA et validez les champs, types et valeurs autorisées.
- 04Appliquez des règles déterministes de blocage, des limites de périmètre et, si nécessaire, une approbation humaine.
- 05Demandez l’action externe avec une clé facilitant la détection des doublons lorsque le système cible l’accepte.
- 06Confirmez l’état en consultant le système cible ou en enregistrant une réponse vérifiable.
- 07Face à un résultat ambigu, envoyez le cas en rapprochement avant de répéter une action ayant des effets externes.
- 08Enregistrez la version du flux, le résultat des validations et la décision de reprise.
Critères de sélection : tests, preuves, limites et données
Les connecteurs sont une exigence de compatibilité, non une garantie de contrôle. Vérifiez qu’ils couvrent les actions concrètes requises par le processus : lire un changement, consulter un état, créer un brouillon, mettre à jour un champ, joindre une preuve ou annuler une opération. Un connecteur qui ne permet que de créer des objets, sans consulter leur résultat, complique le rapprochement. De même, une intégration disponible ne confirme pas qu’elle expose les champs nécessaires à la validation de l’action.
Exigez une séparation effective entre développement, test et production. Les variables d’environnement de Power Automate sont documentées pour modifier les valeurs de configuration entre environnements lors de l’exportation et de l’importation de solutions. Cette capacité est utile car elle permet de conserver la logique du flux tout en remplaçant les destinations, identifiants ou paramètres. Vérifiez néanmoins, pour chaque outil, comment les changements sont promus, quels éléments échappent au versionnage et si un identifiant de test peut par erreur agir sur des données réelles.
Le versionnage doit permettre de répondre à des questions opérationnelles : quelle version s’est exécutée, qu’a-t-elle modifié par rapport à la précédente et comment revenir à une version connue. Zapier documente les brouillons et les versions, notamment leur comparaison et le retour à une version antérieure dans certains contextes. Cela confirme que le versionnage est une fonction de produit évaluables, mais ne prouve pas à lui seul une stratégie complète de déploiement. Il faut tester si les instructions au modèle, validations, schémas, paramètres et références de connexion sont également versionnés.
Pour chaque exécution, la preuve minimale souhaitable comprend le déclencheur, les références au contexte, la sortie validée, les règles appliquées, l’approbation éventuelle, l’action demandée et le résultat observé dans la cible. Zapier documente un historique d’exécutions qui peut être filtré, notamment par version. Confirmez quelles parties du contenu sont effectivement affichées, combien de temps elles sont conservées et ce qu’il advient des informations masquées ou protégées. Ne confondez pas l’existence d’un panneau d’historique avec une politique suffisante de conservation, d’accès et d’exportation.
Les limites d’exécution doivent se trouver au plus près de l’action risquée. Une règle d’approbation générale pour l’ensemble du flux peut créer des retards inutiles, alors qu’une règle localisée peut ne bloquer que l’envoi externe ou la modification d’un champ sensible. Les politiques de prévention de perte de données de Power Automate permettent de contrôler les connecteurs et leur combinaison dans les environnements. Elles illustrent un contrôle utile à évaluer : empêcher que certaines données circulent entre des services incompatibles avant l’exécution du flux.
L’examen des données doit couvrir la résidence, la conservation, l’accès et le contenu des traces. Les sources disponibles ne permettent pas d’établir une réponse générale, pour toutes les plateformes, sur le lieu d’hébergement des données, leur durée de conservation ou les données traitées par un modèle connecté. Demandez ces conditions au fournisseur et confrontez-les aux politiques internes et réglementaires applicables. Si la réponse ne distingue pas les données d’exécution, fichiers, identifiants, journaux et données envoyées aux services d’IA, l’incertitude est significative.
Questions d’achat et preuves à demander
| Capacité | Question de vérification | Preuve pratique |
|---|---|---|
| Environnements | Le test est-il isolé des actions réelles ? | Promouvoir le même flux du test à la production avec des destinations différentes, sans modifier sa logique. |
| Versionnage | Une configuration antérieure peut-elle être identifiée et restaurée ? | Comparer deux versions et revenir à une version connue ; vérifier les éléments inclus. |
| Historique | La chaîne de décision complète est-elle visible ? | Inspecter une exécution avec entrée, validation, action et résultat dans la cible. |
| Approbation | Seule l’action sensible peut-elle être arrêtée ? | Approuver, refuser et modifier une proposition sans bloquer le reste du traitement. |
| Reprise | Comment un délai d’attente ambigu est-il traité ? | Simuler une perte de réponse et vérifier que l’action n’est pas dupliquée. |
| Données | Qu’est-ce qui est conservé et qui peut le voir ? | Examiner les options de masquage, conservation, autorisations et exportation des journaux. |
Exigences par processus et réalisation d’un test d’achat reproductible
Le triage des tickets relève souvent de l’extraction et du routage. L’IA peut proposer une catégorie, une urgence et un résumé ; les règles doivent limiter les catégories, détecter les champs manquants et orienter les cas peu certains vers une file humaine. Avant d’autoriser une clôture automatique, vérifiez si le flux distingue une suggestion d’une résolution confirmée et s’il conserve le motif de chaque routage.
L’enrichissement d’un CRM exige une attention particulière à la provenance et à l’écrasement des données. Un outil peut ajouter des données dérivées d’une source autorisée, mais il ne devrait pas remplacer un champ maintenu par une personne sans règle explicite. Commencez par créer des champs de proposition, une date de mise à jour et une source ; ne promouvez vers les champs canoniques qu’après validation. Si la mise à jour est automatisée, limitez les objets, champs et états que le flux peut modifier.
L’extraction documentaire bénéficie de schémas clairs et d’un chemin d’exception. Définissez les champs obligatoires, les formats admissibles et les documents devant être refusés en raison d’une faible lisibilité ou d’une incohérence. Pour les documents ayant des conséquences contractuelles, financières ou réglementaires, l’extraction ne doit pas remplacer une revue appropriée. Le volume n’est pas une raison suffisante pour supprimer des contrôles lorsque la donnée extraite déclenche un paiement, un engagement ou une modification d’obligation.
Pour les réponses par e-mail, le risque dépend du destinataire et de l’effet du message. Une réponse interne ou un brouillon peut être automatisé plus facilement qu’une communication externe définitive. Exigez des listes de destinataires autorisés, des modèles approuvés lorsque nécessaire, le blocage des pièces jointes non autorisées et la confirmation que le message a été envoyé. Un brouillon révisable constitue souvent une architecture plus prudente pour les premiers déploiements.
Pour les mises à jour de systèmes internes, l’exigence clé est de pouvoir consulter l’état ultérieur et restaurer ou compenser le changement. Lorsqu’aucune annulation technique n’existe, réduisez l’autonomie : utilisez une approbation, créez un journal de changement et concevez une procédure de correction. Une action irréversible ne devient pas sûre parce qu’elle s’exécute rapidement.
Le test d’achat doit être reproductible et appliqué aux finalistes avec le même jeu de données. Préparez au moins quatre cas : un cas normal, une entrée ambiguë, une défaillance d’intégration et une action que la politique doit bloquer. Mesurez non seulement si le flux se termine, mais aussi quelles preuves il laisse, quelle personne ou quelle règle a pris la décision, s’il peut être répété sans dupliquer les effets et combien de temps il faut pour détecter un état anormal.
Dans le cas normal, examinez le résultat métier et sa confirmation dans la cible. Pour l’entrée ambiguë, vérifiez que le flux n’invente pas de valeur et ne force pas une catégorie : il doit demander une information, orienter vers une revue ou s’arrêter. Dans la défaillance d’intégration, simulez une réponse rejetée et une réponse perdue ; ces scénarios sont différents. Dans l’action bloquée, tentez une modification hors du périmètre autorisé et vérifiez que la barrière s’applique avant l’action externe, laisse une trace et ne peut être contournée en modifiant le texte de l’entrée.
La décision finale peut être résumée dans une matrice simple. Moins une action est réversible et plus son impact est élevé, plus le contrôle humain doit être proche et plus les exigences de preuve doivent être strictes. Pour un volume élevé d’actions à faible impact, une autonomie limitée peut être justifiée si le système démontre validation, limites et rapprochement. S’il ne peut le démontrer lors d’un test, maintenez le processus dans une architecture moins autonome.
Test d’achat en quatre scénarios
- 01Configurez un flux de test avec des données synthétiques ou autorisées et une destination hors production.
- 02Exécutez un cas normal et vérifiez le résultat final dans l’application cible.
- 03Exécutez une entrée ambiguë et vérifiez que le chemin d’exception ou la revue humaine est activé.
- 04Simulez un rejet explicite de l’intégration et examinez le journal et la notification.
- 05Simulez un délai d’attente après une demande d’action et vérifiez la procédure de rapprochement avant toute nouvelle tentative.
- 06Tentez une action interdite par le périmètre, le champ, le destinataire ou une règle métier.
- 07Comparez les exécutions : version utilisée, données visibles, décisions, délais, actions réalisées et capacité de correction.
- 08Documentez les résultats et conservez comme exigence tout contrôle ayant empêché une action erronée.
Matrice finale de choix
| Impact et réversibilité | Volume | Architecture initiale recommandée | Capacités minimales |
|---|---|---|---|
| Faible impact et facilement réversible | Faible ou moyen | IA auxiliaire avec règles | Règles fixes, validation élémentaire, historique et confirmation de la cible |
| Impact modéré et sortie structurables | Moyen ou élevé | Extraction et routage | Schéma, valeurs autorisées, file d’exception, tests et versionnage |
| Impact élevé ou critère ambigu | Tout volume | Revue humaine intégrée | Approbation ou modification, contexte visible, preuve de décision et audit |
| Faible impact mais très fort volume | Élevé | Autonomie limitée après test | Limites d’action, détection des doublons, rapprochement, arrêt et revue périodique |
| Irréversible ou à conséquences significatives | Tout volume | Revue humaine ou refonte du processus | Confirmation indépendante, séparation des fonctions et procédure de correction |
Questions ouvertes
- Les sources fournies décrivent des fonctions précises de Microsoft Power Automate et de Zapier ; elles ne permettent pas de généraliser leurs capacités à tous les outils d’automatisation.
- La disponibilité des fonctions peut dépendre de l’offre souscrite, de la région, du type de connecteur, de la configuration de l’environnement et de changements ultérieurs du fournisseur.
- Les sources fournies ne permettent pas de déterminer une politique commune de résidence, conservation, accès ou utilisation des données pour toutes les plateformes et tous les services d’IA connectés.
- La qualité de classification, d’extraction ou de génération dépend du modèle, des instructions, des données et des validations du processus ; elle ne découle pas de la présence d’une intégration.
- L’annulation effective dépend aussi des capacités du système cible : restaurer une version du flux n’annule pas nécessairement les actions déjà exécutées.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction