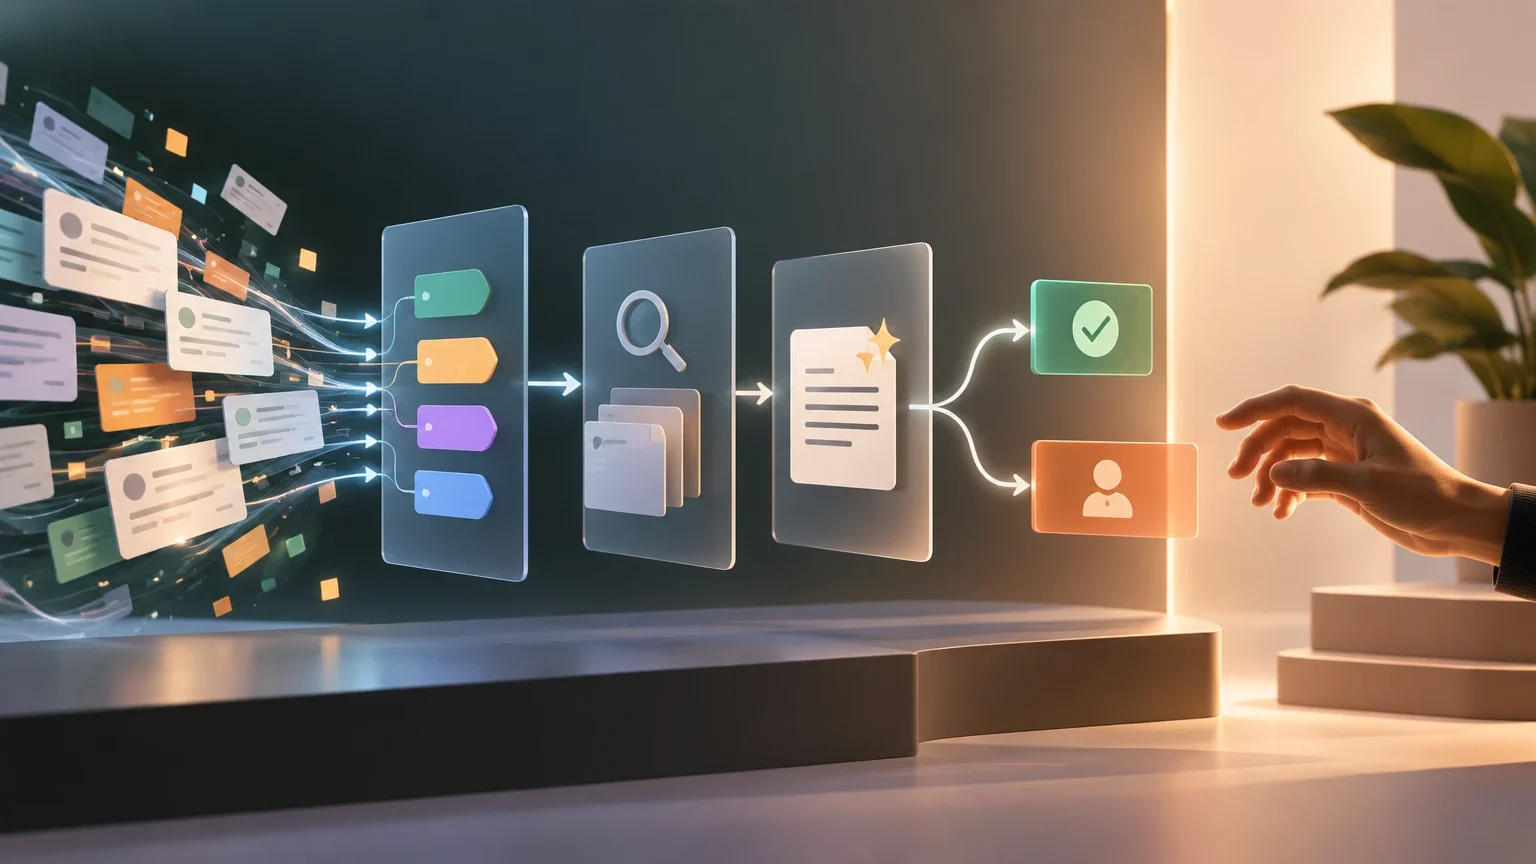
L’errore iniziale: rispondere a tutti i ticket come se avessero lo stesso rischio
Un team di assistenza può ricevere migliaia di email, chat e moduli che sembrano ripetitivi. Questa ripetizione invita ad automatizzare l’intera risposta: il sistema legge il messaggio, sceglie una categoria, redige una risposta e magari modifica un account, gestisce una disdetta o promette un rimborso. Il problema non è che queste quattro attività avvengano in pochi secondi, ma che non abbiano lo stesso significato né lo stesso rischio per la persona assistita.
Classificare un ticket come possibile problema di accesso è una previsione operativa. Recuperare un articolo di assistenza è una ricerca di evidenze. Redigere una spiegazione è produzione di linguaggio. Cambiare il piano, rivelare dati, reimpostare credenziali, annullare un servizio o decidere un indennizzo è un’azione che può incidere su diritti, denaro, sicurezza o relazione contrattuale del cliente. Un flusso responsabile non tratta questi risultati come equivalenti.
Ridurre il tempo medio fino alla prima risposta non dimostra, da solo, che l’assistenza sia migliorata. Una risposta istantanea che interpreta male la richiesta, si basa su documentazione datata o costringe il cliente a ripetere informazioni può aumentare riaperture, trasferimenti e frustrazione. La valutazione deve concentrarsi sul fatto che il caso arrivi al percorso appropriato e sia risolto correttamente, con evidenze pertinenti e una possibilità concreta di correzione quando il sistema fallisce.
Prima di scegliere modelli o fornitori, il team deve decidere quale classe di lavoro desidera automatizzare e quali conseguenze accetta in caso di errore. La guida alla selezione dei casi d’uso può aiutare a delimitare il problema; le decisioni sull’autonomia vanno trattate come una questione di sicurezza e governance, non come una semplice impostazione di produttività.
Separare le quattro operazioni del flusso di assistenza
Progettare il flusso come un’unica automazione nasconde dove si producono gli errori. Conviene dividerlo in operazioni osservabili e registrare l’esito di ciascuna. La prima è la classificazione: identificare intenzione, prodotto, lingua, urgenza apparente, categoria e coda di destinazione. La seconda è il recupero: individuare informazioni autorizzate e aggiornate nella base di conoscenza, nella cronologia del caso e, se opportuno, nei sistemi interni consentiti. La terza è la redazione: trasformare tali evidenze in una bozza comprensibile e coerente con il tono dell’assistenza. La quarta è l’esecuzione: chiudere il caso, inviare la risposta o apportare una modifica in un sistema.
Questa separazione consente di applicare controlli diversi. La classificazione può suggerire una coda e mostrare il proprio livello di confidenza, ma una confidenza elevata non dimostra che l’etichetta sia corretta. Il recupero richiede di verificare l’ambito delle autorizzazioni, la validità della policy e la corrispondenza tra fonte e caso. La redazione deve evitare che il modello colmi lacune con informazioni plausibili ma prive di supporto. L’esecuzione richiede regole di autorizzazione, validazioni preventive e tracciabilità specifica, anche quando la redazione è stata impeccabile.
La separazione chiarisce inoltre un limite importante: l’IA non dovrebbe usare tutti i campi disponibili solo perché può leggerli tecnicamente. I campi del ticket e del profilo devono essere collegati a una finalità definita di assistenza, necessari per risolvere il caso e soggetti a una conservazione controllata. Informazioni particolarmente sensibili, dati non pertinenti o attributi che possano distorcere il percorso vanno esclusi fin dalla progettazione, salvo necessità giustificata e controlli adeguati.
L’inventario degli accessi deve documentare, per ogni operazione, quali dati il sistema può consultare, quale fonte li fornisce, quali autorizzazioni sono richieste e cosa resta espressamente escluso. Una policy di accesso vaga lascia al modello e alle sue integrazioni il ruolo di arbitri impliciti della necessità dei dati; non è un ruolo adatto a un sistema di previsione del testo.
Operazioni separate e controllo principale
| Operazione | Risultato previsto | Controllo minimo | Può agire da sola? |
|---|---|---|---|
| Classificare | Etichetta, priorità e coda suggerite | Campione revisionato, soglia per categoria e percorso di astensione | Sì, per l’instradamento; no per decidere casi sensibili |
| Recuperare evidenze | Fonti autorizzate e pertinenti | Autorizzazioni, validità, corrispondenza con il caso e registro delle fonti | Sì, entro l’ambito autorizzato |
| Redigere | Bozza basata su evidenze | Revisione del supporto, tono, dati rivelati e affermazioni non verificate | Solo nei casi a basso impatto |
| Eseguire | Modifica, chiusura o impegno esterno | Autorizzazione, validazione delle regole, registro e reversibilità | Solo per azioni preautorizzate e circoscritte |
Inventario dei casi e matrice di autonomia
Il passo successivo consiste nel costruire un inventario a partire da ticket reali, non da categorie ideali. Una richiesta informativa su orari o funzioni documentate non presenta lo stesso rischio di un problema tecnico con possibile perdita di dati. Una modifica dell’account può richiedere la verifica dell’identità e dei permessi. Un reclamo economico può incidere su una fattura o su un rimborso. Una segnalazione di sicurezza, una richiesta di accesso o cancellazione dei dati e un messaggio con segnali di danno grave richiedono percorsi specializzati.
Per ogni tipo di caso, valutate almeno cinque dimensioni: impatto se la risposta è sbagliata; reversibilità dell’azione; qualità e attualità delle evidenze disponibili; certezza della classificazione; e tempo ammissibile per rispondere. L’urgenza non giustifica da sola una maggiore autonomia. In alcuni casi richiede proprio un’escalation più rapida a una persona o a un team competente.
La matrice non deve funzionare come un punteggio che nasconde decisioni delicate. Alcune categorie sono escluse dalla risposta autonoma anche se tutte le altre variabili sembrano favorevoli. Fra queste rientrano di norma rimborsi e altri pagamenti, disdette con conseguenze contrattuali, modifiche rilevanti degli accessi, privacy, sicurezza, eccezioni di policy, sospensione del servizio e comunicazioni contenenti minacce, autolesionismo, molestie o segnali di frustrazione critica. La definizione esatta dipenderà dal servizio e dai suoi obblighi, ma l’esclusione deve essere esplicita e verificabile.
Nelle categorie a basso impatto, la risposta automatica è ragionevole solo quando le condizioni sono chiuse: l’intento rientra in un insieme noto, l’evidenza proviene da una fonte aggiornata, non è necessaria un’azione esterna, non esiste conflitto tra fonti e la risposta può essere corretta senza un pregiudizio rilevante. Se manca anche una sola di queste condizioni, il sistema deve astenersi, porre una domanda di chiarimento limitata oppure escalare.
Matrice orientativa di autonomia
| Tipo di caso | Rischio abituale | Autonomia iniziale | Condizione di uscita |
|---|---|---|---|
| Richiesta informativa documentata | Basso se non richiede dati dell’account | Risposta automatica circoscritta | Fonte aggiornata, caso incluso e nessun conflitto |
| Problema tecnico | Variabile | Classificazione e bozza | Escalare in caso di perdita di dati, sicurezza o diagnosi incerta |
| Modifica dell’account | Medio o alto | Raccolta guidata e bozza | Approvazione o verifica dell’identità secondo l’azione |
| Reclamo economico | Alto | Classificazione e preparazione del contesto | Revisione umana prima di impegnarsi su importi o condizioni |
| Privacy o sicurezza | Alto | Instradamento prioritario | Team autorizzato; nessuna risposta sostanziale automatica |
| Linguaggio ad alto rischio | Alto | Avviso e percorso specializzato | Intervento umano secondo il protocollo applicabile |
Progettare un ticket verificabile, non una scatola nera conversazionale
Ogni caso elaborato dall’IA dovrebbe poter essere ricostruito in seguito. Questo non significa conservare indefinitamente tutti i contenuti, ma mantenere il registro necessario e proporzionato per rivedere una decisione, indagare un incidente e migliorare il flusso. Il registro deve distinguere ciò che ha detto il cliente, ciò che hanno fornito i sistemi autorizzati, ciò che il modello ha inferito, ciò che ha proposto una persona e l’azione infine eseguita.
Una struttura utile include l’identificativo del caso; l’input originale e gli allegati consentiti; l’identità o lo stato di verifica disponibile all’agente, senza esporre più informazioni del necessario; la categoria e il percorso suggeriti; le fonti recuperate con la relativa versione o data di validità; la bozza; le validazioni applicate; l’approvatore, quando presente; e l’azione finale. È inoltre opportuno registrare la versione del modello, le istruzioni di alto livello, gli strumenti usati e i risultati restituiti da tali strumenti.
La tracciabilità non rende corretta una decisione errata, ma consente di individuare schemi ricorrenti: una policy recuperata in modo sbagliato, una coda che riceve casi non pertinenti, un’integrazione che esegue un’azione ambigua o una categoria in cui la confidenza dichiarata non corrisponde alle prestazioni reali. È anche la base per interrompere un’automazione in modo selettivo anziché disattivare l’intero sistema.
La documentazione deve assegnare responsabilità. L’assistenza può essere proprietaria del processo e dell’esperienza del cliente; la qualità può revisionare campioni e definire criteri di risoluzione; sicurezza e privacy possono approvare accessi e controlli; il prodotto può mantenere le policy che incidono su funzioni e piani; e il team tecnico può gestire il modello e le sue integrazioni. Nessun team dovrebbe presumere che un altro controlli l’effetto finale se questa responsabilità non è stata definita.
Registro minimo di una risoluzione assistita
- 01Conservare la richiesta originale e indicare quali parti sono state inviate al sistema.
- 02Registrare categoria, coda suggerita, livello di confidenza e motivo dell’astensione, se avvenuta.
- 03Registrare le fonti consentite recuperate, la loro validità e qualsiasi conflitto rilevato.
- 04Separare la bozza dell’IA dalle modifiche e dalla decisione della persona revisora.
- 05Registrare validazioni, autorizzazione, azione eseguita, esito e meccanismo di annullamento disponibile.
- 06Applicare un periodo di conservazione definito e controlli di accesso al registro.
Le evidenze determinano quando rispondere, astenersi o escalare
Una base di conoscenza consente di rispondere quando contiene un’istruzione applicabile al caso, è aggiornata, proviene da un responsabile identificabile e può essere spiegata senza aggiungere condizioni non verificate. Il sistema non dovrebbe presentare come policy una sintesi che mescola documenti incompatibili, né trasformare una raccomandazione generale in una garanzia concreta per quel cliente.
L’assenza di evidenze è un’informazione operativa, non un invito a improvvisare. Se non esiste un articolo applicabile, se il documento è obsoleto, se due fonti divergono o se la cronologia non basta a confermare un fatto, l’output appropriato può essere una domanda di chiarimento o un trasferimento. La bozza deve poter indicare i propri limiti in modo chiaro: cosa è stato verificato, cosa manca e quale team proseguirà la revisione.
Il recupero deve inoltre essere specifico per il caso. Un articolo su un piano standard può essere irrilevante per un cliente con una condizione contrattuale diversa. Un dato sullo stato dell’account può essere cambiato dall’ultimo contatto. Per questo, l’evidenza non si misura soltanto dal numero di documenti trovati, ma dalla loro pertinenza, autorevolezza e attualità. La copertura delle evidenze può diventare una metrica: quale proporzione di risposte automatiche includeva un supporto sufficiente secondo una revisione umana.
In nessun caso la conversazione deve essere usata per estrarre o rivelare dati che il cliente non necessita per risolvere la propria richiesta. Le risposte devono evitare dettagli interni, informazioni di terzi, credenziali, identificativi non necessari o spiegazioni che rendano più semplice abusare dei sistemi. Quando il cliente chiede un’azione che richiede autenticazione, l’automazione può indirizzarlo verso il processo approvato, ma non sostituire le verifiche richieste.
Regole di escalation non negoziabili e test prima del rilascio
Le regole di escalation devono essere implementate, ove possibile, al di fuori del testo libero del modello. Un classificatore può suggerire che un caso riguardi la sicurezza, ma una regola basata su parole chiave, metadati, tipo di modulo o risultato di uno strumento può aggiungere una barriera indipendente. Se compare uno qualsiasi di questi segnali, il flusso deve indirizzare il caso alla coda appropriata e bloccare azioni incompatibili con quel percorso.
Oltre a pagamenti, disdette, privacy e sicurezza, includete percorsi per eccezioni di policy, impegni contrattuali, possibili discriminazioni, minacce, account compromessi e linguaggio ad alto rischio. L’elenco va rivisto con chi conosce l’operatività reale: agenti, responsabili della qualità, team legali quando opportuno, sicurezza e responsabili di prodotto. Un caso escluso dall’automazione non è un fallimento del sistema; è una decisione di controllo.
Prima di inviare risposte automatiche, testate il flusso con un insieme storico congelato. Separate tale insieme dagli esempi usati per progettare le istruzioni o adeguare le regole. Includete conversazioni lunghe, messaggi incompleti, errori ortografici, lingue ammesse, richieste multiple, cambi di contesto, fonti contraddittorie, clienti arrabbiati e casi che imitano categorie semplici ma contengono un’eccezione. Valutate per segmento, non solo tramite una media generale.
Le conversazioni avversariali non devono essere necessariamente attacchi sofisticati. È sufficiente verificare cosa accade quando un cliente chiede all’assistente di ignorare le procedure, inserisce istruzioni in un allegato, richiede dati di un’altra persona o mescola una domanda informativa con un’azione sensibile. Il sistema deve trattare tale contenuto come parte della richiesta, non come istruzioni operative capaci di modificare le sue regole. I test devono confermare che resta separato il testo del cliente da policy interne, strumenti e autorizzazioni.
Rilascio graduale con condizioni di annullamento
- 01Iniziare in modalità bozza: un agente revisiona e modifica ogni risposta proposta.
- 02Attivare suggerimenti di classificazione e misurare l’accuratezza di instradamento rispetto a campioni revisionati da specialisti.
- 03Consentire risposte automatiche solo in una categoria chiusa, senza azione esterna e con evidenze sufficienti.
- 04Revisionare quotidianamente errori, riaperture, trasferimenti, reclami e casi di escalation omessa nella fase iniziale.
- 05Definire soglie prima del lancio per sospendere o annullare l’automazione per categoria.
- 06Ampliare l’ambito solo se i risultati si mantengono per segmento e gli incidenti vengono indagati e corretti.
Misurare la risoluzione corretta, non solo la velocità
Il cruscotto deve confrontare il flusso assistito con un processo di riferimento e suddividere i risultati per tipo di caso, canale, lingua, prodotto e coda quando tali segmentazioni sono pertinenti e consentite. Un indicatore aggregato può nascondere che il sistema funzioni bene per richieste semplici e male per modifiche dell’account o reclami. La decisione di ampliare l’autonomia deve basarsi su questo livello di dettaglio.
L’accuratezza di instradamento misura se il ticket arriva alla coda che avrebbe scelto una revisione esperta. La risoluzione corretta valuta se la risposta e l’azione finale hanno risolto il caso secondo criteri di qualità definiti. I tassi di riapertura e trasferimento rivelano se una risposta apparentemente rapida ha lasciato lavoro in sospeso. Il rispetto degli SLA mostra se l’automazione accorcia o allunga il tempo fino a un’assistenza adeguata, non soltanto fino al primo messaggio.
Aggiungete metriche di sicurezza e di evidenza: proporzione di risposte con una fonte pertinente e aggiornata; frequenza delle astensioni giustificate; incidenti di accesso o divulgazione impropria di dati; percentuale di azioni bloccate da una regola di escalation; e danno causato da risoluzione errata. Quest’ultimo indicatore richiede una tassonomia condivisa, ad esempio inconveniente minore correggibile, danno economico, esposizione di dati, inadempimento di un impegno o impatto sulla sicurezza. Non è opportuno nascondere questi casi all’interno di un’unica metrica di soddisfazione.
Il costo per caso può informare le decisioni operative, ma non deve compensare automaticamente un aumento di errori gravi. La soddisfazione del cliente offre un segnale utile, sebbene non sia sufficiente da sola: una persona può apprezzare la rapidità di una risposta che in seguito si rivela errata. La revisione umana dei campioni, l’indagine sugli incidenti e la possibilità di ricostruire ogni caso integrano le metriche di percezione.
Metriche e decisioni che consentono di prendere
| Metrica | Domanda a cui risponde | Segnale di allerta |
|---|---|---|
| Accuratezza di instradamento | Il caso arriva alla coda corretta? | Calo nelle categorie sensibili o minoritarie |
| Risoluzione corretta | La risposta e l’azione hanno risolto il caso? | Divario tra velocità e qualità revisionata |
| Riaperture e trasferimenti | Il lavoro è stato spostato su contatti successivi? | Aumento dopo l’attivazione della risposta automatica |
| Copertura delle evidenze | La risposta è supportata da fonti pertinenti? | Fonti vecchie, assenti o contraddittorie |
| SLA fino all’assistenza adeguata | Il cliente ha ricevuto un aiuto utile in tempo? | Prima risposta rapida ma escalation tardiva |
| Danno da errore | Quali conseguenze hanno avuto gli errori? | Qualsiasi incidente grave richiede una revisione immediata |
Checklist per approvare o interrompere un’automazione
Approvate un’automazione solo se potete descriverne con precisione l’ambito: categorie incluse, fonti autorizzate, dati esclusi, azioni consentite, responsabili e condizioni di escalation. Se il team non sa spiegare cosa fa il sistema davanti a una fonte assente, a una bassa confidenza, a una richiesta fuori policy o a un risultato ambiguo di uno strumento, il flusso non è ancora pronto per operare con autonomia.
Deve inoltre esistere un meccanismo semplice affinché agenti e responsabili della qualità correggano una classificazione, segnalino una fonte errata e interrompano una risposta automatica per categoria. La correzione deve alimentare una revisione del processo, non diventare un’eccezione silenziosa. Le modifiche a policy, prodotti, prezzi o condizioni contrattuali richiedono di riesaminare gli articoli recuperabili e, quando opportuno, di testare nuovamente l’automazione.
Interrompete o riducete l’ambito se emergono errori gravi, se riaperture o trasferimenti superano la soglia definita, se cala la copertura delle evidenze, se cambia il profilo dei ticket o se non può essere mantenuta la tracciabilità richiesta. L’annullamento è una capacità di progettazione: deve essere possibile riportare una categoria alla modalità bozza senza interrompere l’assistenza clienti.
L’automazione dell’assistenza è più controllabile quando inizia da attività che riducono il carico amministrativo senza sostituire decisioni ad alto impatto. Classificare, recuperare evidenze e redigere bozze possono creare valore se mantengono limiti chiari. Eseguire una risoluzione sull’account, sul denaro, sui dati o sui diritti di una persona richiede un livello di controllo proporzionato. Per decidere quale livello sia appropriato in ciascun caso, collegate questa guida ai criteri di selezione dei casi, ai controlli di sicurezza e alla valutazione di costi e ambito dell’automazione.
Questioni aperte
- Le categorie che richiedono approvazione umana e le soglie di annullamento dipendono dal servizio, dagli obblighi applicabili, dai sistemi connessi e dalla tolleranza al rischio di ogni organizzazione.
- La guida non determina quali verifiche di identità, periodi di conservazione o flussi legali siano richiesti in una specifica giurisdizione o settore.
- Un’elevata confidenza dichiarata da un modello non equivale necessariamente ad accuratezza; deve essere validata con campioni rappresentativi e revisione specializzata.
- La disponibilità, l’attualità e l’autorevolezza della base di conoscenza devono essere verificate in ogni organizzazione prima di abilitare risposte automatiche.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione