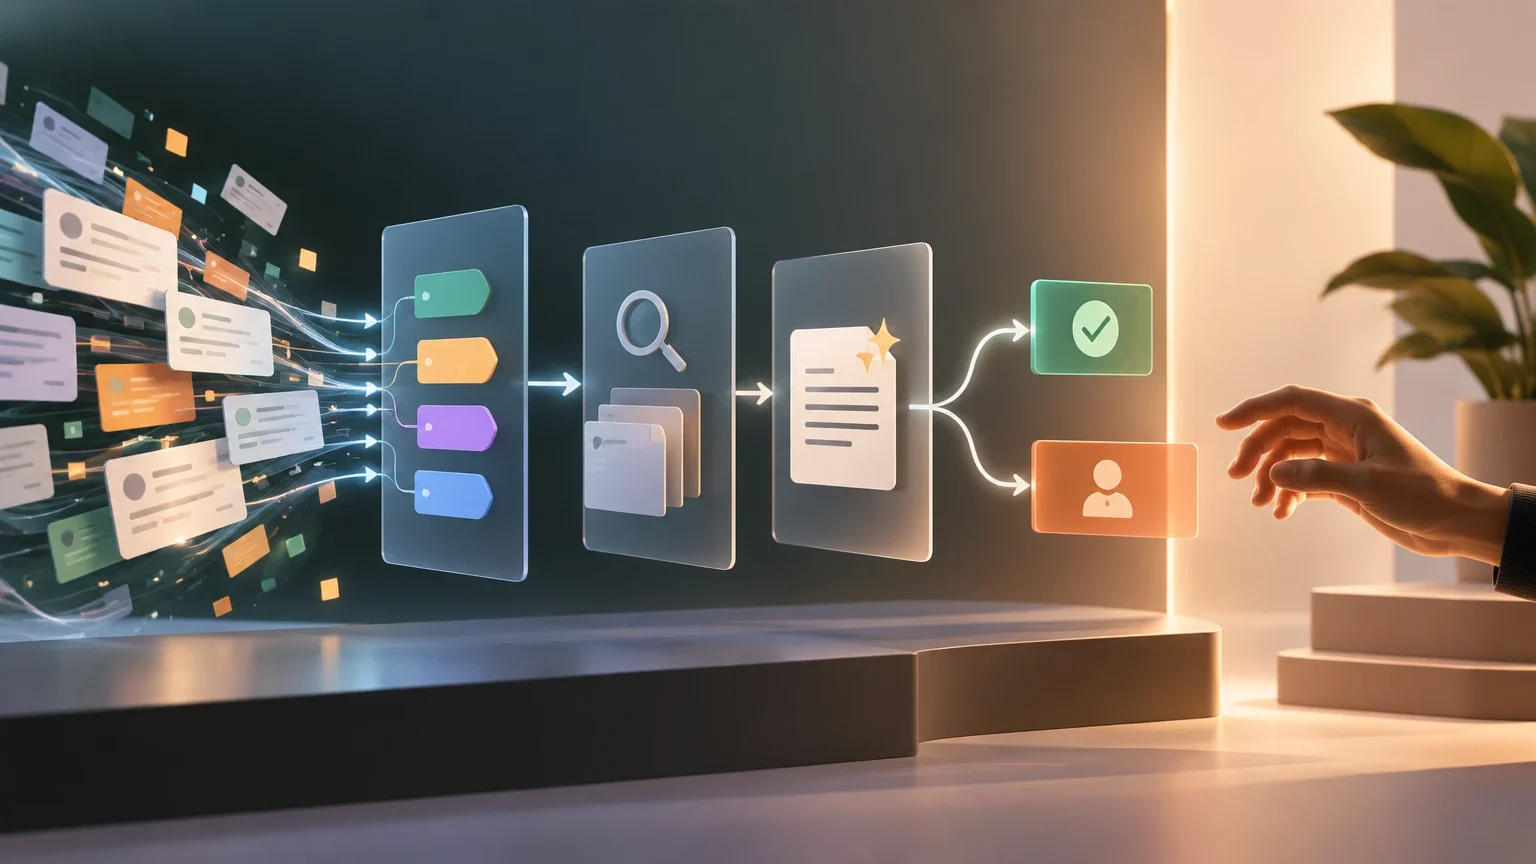
El error de partida: responder todos los tickets como si tuvieran el mismo riesgo
Un equipo de soporte puede recibir miles de correos, chats y formularios que parecen repetitivos. Esa repetición invita a automatizar la respuesta completa: el sistema lee el mensaje, elige una categoría, redacta una contestación y quizá modifica una cuenta, tramita una baja o promete un reembolso. El problema no es que esas cuatro tareas ocurran en segundos, sino que no tienen el mismo significado ni el mismo riesgo para la persona atendida.
Clasificar un ticket como posible incidencia de acceso es una predicción operativa. Recuperar un artículo de ayuda es una búsqueda de evidencia. Redactar una explicación es una producción de lenguaje. Cambiar el plan, revelar datos, restablecer credenciales, cancelar un servicio o decidir una compensación es una acción que puede afectar derechos, dinero, seguridad o la relación contractual del cliente. Un flujo responsable no trata esos resultados como equivalentes.
Reducir el tiempo medio hasta la primera respuesta tampoco prueba, por sí solo, que el soporte haya mejorado. Una contestación instantánea que interpreta mal la solicitud, se apoya en documentación antigua o fuerza al cliente a repetir información puede aumentar las reaperturas, las transferencias y la frustración. La evaluación debe centrarse en si el caso llega a la ruta adecuada y se resuelve correctamente, con evidencia pertinente y con una posibilidad real de corrección cuando el sistema falla.
Antes de elegir modelos o proveedores, el equipo debe decidir qué clase de trabajo quiere automatizar y qué consecuencias acepta si se equivoca. La guía sobre selección de casos de uso puede ayudar a delimitar el problema; las decisiones sobre autonomía conviene tratarlas como una cuestión de seguridad y gobernanza, no como una simple configuración de productividad.
Separar las cuatro operaciones del flujo de soporte
Diseñar el flujo como una única automatización oculta dónde se producen los errores. Conviene dividirlo en operaciones observables y registrar el resultado de cada una. La primera es la clasificación: identificar intención, producto, idioma, urgencia aparente, categoría y cola de destino. La segunda es la recuperación: localizar información autorizada y vigente en la base de conocimiento, el historial del caso y, si procede, los sistemas internos permitidos. La tercera es la redacción: convertir esa evidencia en un borrador comprensible y ajustado al tono de soporte. La cuarta es la ejecución: cerrar el caso, enviar la respuesta o realizar un cambio en un sistema.
Esta separación permite aplicar controles distintos. La clasificación puede sugerir una cola y mostrar su confianza, pero una confianza alta no demuestra que la etiqueta sea correcta. La recuperación necesita comprobar el alcance de los permisos, la vigencia de la política y la correspondencia entre fuente y caso. La redacción necesita evitar que el modelo complete lagunas con información plausible pero no respaldada. La ejecución requiere reglas de autorización, validaciones previas y trazabilidad propia, incluso si la redacción ha sido impecable.
También aclara un límite importante: la IA no debería usar todos los campos disponibles solo porque técnicamente puede leerlos. Los campos del ticket y del perfil deben estar relacionados con una finalidad definida de atención, ser necesarios para resolver el caso y tener una retención controlada. Información especialmente sensible, datos no pertinentes o atributos que puedan sesgar la ruta deben excluirse por diseño salvo que exista una necesidad justificada y controles adecuados.
El inventario de accesos debe documentar, por cada operación, qué datos puede consultar el sistema, qué fuente los aporta, qué permisos se exigen y qué queda expresamente fuera. Una política de acceso vaga deja al modelo y a sus integraciones como árbitros implícitos de la necesidad de datos; ese no es un papel apropiado para un sistema de predicción de texto.
Operaciones separadas y control principal
| Operación | Resultado esperado | Control mínimo | ¿Puede actuar por sí sola? |
|---|---|---|---|
| Clasificar | Etiqueta, prioridad y cola sugeridas | Muestra revisada, umbral por categoría y ruta de abstención | Sí, para enrutar; no para decidir casos sensibles |
| Recuperar evidencia | Fuentes autorizadas y pertinentes | Permisos, vigencia, coincidencia con el caso y registro de fuentes | Sí, dentro del alcance autorizado |
| Redactar | Borrador basado en evidencia | Revisión de respaldo, tono, datos revelados y afirmaciones no verificadas | Solo en casos de bajo impacto |
| Ejecutar | Cambio, cierre o compromiso externo | Autorización, validación de reglas, registro y reversibilidad | Solo en acciones preautorizadas y acotadas |
Inventario de casos y matriz de autonomía
El siguiente paso es construir un inventario a partir de tickets reales, no de categorías ideales. Una consulta informativa sobre horarios o funciones documentadas no presenta el mismo riesgo que una incidencia técnica con posible pérdida de datos. Un cambio de cuenta puede requerir comprobar identidad y permisos. Una reclamación económica puede afectar una factura o un reembolso. Un aviso de seguridad, una petición de acceso o supresión de datos y un mensaje con señales de daño grave requieren rutas especializadas.
Para cada tipo de caso, valore al menos cinco dimensiones: impacto si la respuesta es incorrecta; reversibilidad de la acción; calidad y actualidad de la evidencia disponible; certeza de la clasificación; y tiempo admisible para responder. La urgencia no justifica por sí sola una mayor autonomía. En ocasiones exige precisamente un escalado más rápido a una persona o equipo capacitado.
La matriz no debe funcionar como una puntuación que esconda decisiones delicadas. Algunas categorías se excluyen de la respuesta autónoma aunque todas las demás variables parezcan favorables. Entre ellas suelen estar reembolsos y otros pagos, bajas con consecuencias contractuales, cambios de acceso relevantes, privacidad, seguridad, excepciones de política, suspensión de servicio y comunicaciones que contengan amenazas, autolesión, acoso o señales de frustración crítica. La definición exacta dependerá del servicio y de sus obligaciones, pero la exclusión debe ser explícita y comprobable.
En categorías de bajo impacto, la respuesta automática solo es razonable cuando las condiciones están cerradas: la intención está dentro de un conjunto conocido, la evidencia procede de una fuente vigente, no se necesita una acción externa, no hay conflicto entre fuentes y la respuesta puede corregirse sin perjuicio relevante. Si falta cualquiera de estas condiciones, el sistema debe abstenerse, pedir una aclaración limitada o escalar.
Matriz orientativa de autonomía
| Tipo de caso | Riesgo habitual | Autonomía inicial | Condición de salida |
|---|---|---|---|
| Consulta informativa documentada | Bajo si no requiere datos de cuenta | Respuesta automática acotada | Fuente vigente, caso incluido y sin conflicto |
| Incidencia técnica | Variable | Clasificación y borrador | Escalar si hay pérdida de datos, seguridad o diagnóstico incierto |
| Cambio de cuenta | Medio o alto | Recogida guiada y borrador | Aprobación o verificación de identidad según la acción |
| Reclamación económica | Alto | Clasificación y preparación de contexto | Revisión humana antes de comprometer importes o condiciones |
| Privacidad o seguridad | Alto | Enrutamiento prioritario | Equipo autorizado; sin respuesta sustantiva automática |
| Lenguaje de alto riesgo | Alto | Alerta y ruta especializada | Intervención humana conforme al protocolo aplicable |
Diseñar un ticket verificable, no una caja negra conversacional
Cada caso procesado por IA debería poder reconstruirse después. Esto no significa conservar indefinidamente todo el contenido, sino mantener el registro necesario y proporcional para revisar una decisión, investigar un incidente y mejorar el flujo. El registro debe distinguir lo que dijo el cliente, lo que aportaron los sistemas autorizados, lo que el modelo infirió, lo que propuso una persona y la acción finalmente ejecutada.
Una estructura útil incluye el identificador del caso; la entrada original y los adjuntos permitidos; la identidad o el estado de verificación disponible para el agente, sin exponer más información de la necesaria; la categoría y la ruta sugeridas; las fuentes recuperadas con su versión o fecha de vigencia; el borrador; las validaciones aplicadas; el aprobador cuando lo haya; y la acción final. También conviene registrar la versión del modelo, las instrucciones de alto nivel, las herramientas usadas y los resultados devueltos por ellas.
La trazabilidad no convierte una decisión errónea en correcta, pero permite detectar patrones: una política que se recupera de forma incorrecta, una cola que recibe casos que no le corresponden, una integración que ejecuta una acción ambigua o una categoría donde la confianza declarada no coincide con el rendimiento real. Es además la base para detener una automatización de manera selectiva en vez de desactivar todo el sistema.
La documentación debe asignar responsables. Soporte puede ser propietario del proceso y de la experiencia del cliente; calidad puede revisar muestras y definir criterios de resolución; seguridad y privacidad pueden aprobar accesos y controles; producto puede mantener las políticas que afectan a funciones y planes; y el equipo técnico puede operar el modelo y sus integraciones. Ningún equipo debería asumir que otro revisa el efecto final sin que esa responsabilidad esté definida.
Registro mínimo de una resolución asistida
- 01Conservar la solicitud original y marcar qué partes se enviaron al sistema.
- 02Registrar categoría, cola sugerida, nivel de confianza y motivo de abstención si se produjo.
- 03Registrar las fuentes permitidas recuperadas, su vigencia y cualquier conflicto detectado.
- 04Separar el borrador de IA de las modificaciones y la decisión de la persona revisora.
- 05Registrar validaciones, autorización, acción ejecutada, resultado y mecanismo de reversión disponible.
- 06Aplicar un plazo de conservación definido y controles de acceso al registro.
La evidencia determina cuándo responder, abstenerse o escalar
Una base de conocimiento permite responder cuando contiene una instrucción aplicable al caso, está vigente, procede de un propietario identificable y puede explicarse sin añadir condiciones no verificadas. El sistema no debería presentar como política una síntesis que mezcla documentos incompatibles, ni convertir una recomendación general en una garantía concreta para ese cliente.
La ausencia de evidencia es información operativa, no una invitación a improvisar. Si no existe un artículo aplicable, si el documento está desactualizado, si dos fuentes discrepan o si el historial no basta para confirmar un hecho, la salida adecuada puede ser una pregunta aclaratoria o una transferencia. El borrador debe poder indicar sus límites de forma clara: qué se ha comprobado, qué falta y qué equipo continuará la revisión.
La recuperación también debe ser específica al caso. Un artículo sobre un plan estándar puede ser irrelevante para un cliente con una condición contractual distinta. Un dato de estado de cuenta puede haber cambiado desde el último contacto. Por eso, la evidencia no se mide solo por el número de documentos encontrados, sino por su pertinencia, autoridad y actualidad. La cobertura de evidencia puede convertirse en una métrica: qué proporción de respuestas automáticas incluía apoyo suficiente según una revisión humana.
En ningún caso debe usarse la conversación para extraer o revelar datos que el cliente no necesita para resolver su solicitud. Las respuestas deben evitar detalles internos, información de terceros, credenciales, identificadores innecesarios o explicaciones que faciliten un abuso de los sistemas. Cuando el cliente pida una acción que exige autenticación, la automatización puede orientar hacia el proceso aprobado, pero no sustituir las verificaciones requeridas.
Reglas de escalado no negociables y pruebas antes del despliegue
Las reglas de escalado deben estar implementadas fuera del texto libre del modelo siempre que sea posible. Un clasificador puede sugerir que un caso trata sobre seguridad, pero una regla basada en palabras clave, metadatos, tipo de formulario o resultado de una herramienta puede añadir una barrera independiente. Si cualquiera de esas señales aparece, el flujo debe dirigir el caso a la cola adecuada y bloquear acciones incompatibles con esa ruta.
Además de pagos, bajas, privacidad y seguridad, incluya rutas para excepciones de política, compromisos contractuales, posibles discriminaciones, amenazas, cuentas comprometidas y lenguaje de alto riesgo. La lista debe revisarse con quienes conocen la operación real: agentes, responsables de calidad, equipos jurídicos cuando corresponda, seguridad y responsables de producto. Un caso excluido de la automatización no es un fracaso del sistema; es una decisión de control.
Antes de enviar respuestas automáticas, pruebe el flujo con un conjunto histórico congelado. Separe ese conjunto de los ejemplos utilizados para diseñar instrucciones o ajustar reglas. Incluya conversaciones largas, mensajes incompletos, faltas de ortografía, idiomas admitidos, solicitudes múltiples, cambios de contexto, fuentes contradictorias, clientes enfadados y casos que imitan categorías fáciles pero contienen una excepción. Evalúe por segmento, no solo con un promedio general.
Las conversaciones adversariales no tienen que ser ataques sofisticados. Basta con comprobar qué ocurre cuando un cliente pide al asistente que ignore procedimientos, introduce instrucciones en un adjunto, solicita datos de otra persona o mezcla una pregunta informativa con una acción sensible. El sistema debe tratar ese contenido como parte de la solicitud, no como instrucciones operativas que puedan modificar sus reglas. Las pruebas deben confirmar que se mantiene la separación entre texto del cliente, políticas internas, herramientas y autorizaciones.
Despliegue gradual con condiciones de reversión
- 01Empezar en modo borrador: un agente revisa y modifica toda respuesta propuesta.
- 02Activar sugerencias de clasificación y medir la exactitud de ruta contra muestras revisadas por especialistas.
- 03Permitir respuestas automáticas solo en una categoría cerrada, sin acción externa y con evidencia suficiente.
- 04Revisar diariamente errores, reaperturas, transferencias, quejas y casos de escalado omitido durante la fase inicial.
- 05Definir umbrales antes del lanzamiento para pausar o revertir la automatización por categoría.
- 06Ampliar el alcance únicamente si los resultados se mantienen por segmento y las incidencias se investigan y corrigen.
Medir resolución correcta, no solo velocidad
El cuadro de mando debe comparar el flujo asistido con un proceso de referencia y desglosar los resultados por tipo de caso, canal, idioma, producto y cola cuando esos cortes sean pertinentes y estén permitidos. Un indicador agregado puede ocultar que el sistema funciona bien en consultas simples y mal en cambios de cuenta o reclamaciones. La decisión de ampliar autonomía debe basarse en ese detalle.
La exactitud de ruta mide si el ticket llega a la cola que habría elegido una revisión experta. La resolución correcta evalúa si la respuesta y la acción final resolvieron el caso según criterios de calidad definidos. Las tasas de reapertura y transferencia revelan si una respuesta aparentemente rápida dejó trabajo pendiente. El cumplimiento de SLA muestra si la automatización acorta o alarga el tiempo hasta una atención adecuada, no solo hasta el primer mensaje.
Añada métricas de seguridad y evidencia: proporción de respuestas con fuente pertinente y vigente; frecuencia de abstenciones justificadas; incidencias de acceso o revelación indebida de datos; porcentaje de acciones bloqueadas por una regla de escalado; y daño por resolución errónea. Este último indicador requiere una taxonomía acordada, por ejemplo, inconveniente menor corregible, perjuicio económico, exposición de datos, incumplimiento de compromiso o impacto de seguridad. No conviene ocultar estos casos dentro de una métrica única de satisfacción.
El coste por caso puede informar decisiones operativas, pero no debe compensar de forma automática un aumento de errores graves. La satisfacción del cliente aporta una señal útil, aunque tampoco basta por sí sola: una persona puede valorar la rapidez de una respuesta que, más tarde, resulta incorrecta. La revisión humana de muestras, la investigación de incidentes y la posibilidad de reconstruir cada caso complementan las métricas de percepción.
Métricas y decisiones que permiten tomar
| Métrica | Pregunta que responde | Señal de alerta |
|---|---|---|
| Exactitud de ruta | ¿El caso llega a la cola correcta? | Caída en categorías sensibles o minoritarias |
| Resolución correcta | ¿La respuesta y la acción resolvieron el caso? | Diferencia entre velocidad y calidad revisada |
| Reaperturas y transferencias | ¿El trabajo se desplazó a contactos posteriores? | Aumento tras activar respuesta automática |
| Cobertura de evidencia | ¿La respuesta se apoya en fuentes pertinentes? | Fuentes antiguas, ausentes o contradictorias |
| SLA hasta atención adecuada | ¿El cliente recibió ayuda útil a tiempo? | Primera respuesta rápida pero escalado tardío |
| Daño por error | ¿Qué consecuencias tuvieron los fallos? | Cualquier incidente grave exige revisión inmediata |
Checklist para aprobar o detener una automatización
Apruebe una automatización solo si puede describir con precisión su alcance: categorías incluidas, fuentes autorizadas, datos excluidos, acciones permitidas, responsables y condiciones de escalado. Si el equipo no puede explicar qué hace el sistema ante una fuente ausente, una baja confianza, una solicitud fuera de política o un resultado ambiguo de una herramienta, el flujo aún no está listo para operar con autonomía.
También debe existir un mecanismo sencillo para que agentes y responsables de calidad corrijan una clasificación, señalen una fuente incorrecta y detengan una respuesta automática por categoría. La corrección debe alimentar una revisión del proceso, no convertirse en una excepción silenciosa. Las modificaciones de políticas, productos, precios o condiciones contractuales exigen revisar los artículos recuperables y, cuando corresponda, volver a probar la automatización.
Detenga o reduzca el alcance si aparecen errores graves, si las reaperturas o transferencias superan el umbral fijado, si baja la cobertura de evidencia, si cambia el perfil de tickets o si no puede mantenerse la trazabilidad requerida. La reversión es una capacidad de diseño: debe ser posible devolver una categoría a modo borrador sin interrumpir la atención al cliente.
La automatización de soporte resulta más controlable cuando empieza por tareas que reducen carga administrativa sin sustituir decisiones de alto impacto. Clasificar, recuperar evidencia y redactar borradores pueden aportar valor si se mantienen límites claros. Ejecutar una resolución sobre la cuenta, el dinero, los datos o los derechos de una persona exige un nivel de control proporcional. Para decidir qué nivel corresponde en cada caso, relacione esta guía con los criterios de selección de casos, los controles de seguridad y la evaluación de costes y alcance de la automatización.
Qué sigue abierto
- Las categorías que requieren aprobación humana y los umbrales de reversión dependen del servicio, las obligaciones aplicables, los sistemas conectados y la tolerancia al riesgo de cada organización.
- La guía no determina qué verificaciones de identidad, plazos de conservación ni flujos jurídicos son exigibles en una jurisdicción o sector concreto.
- Una alta confianza declarada por un modelo no equivale necesariamente a exactitud; debe validarse con muestras representativas y revisión especializada.
- La disponibilidad, vigencia y autoridad de la base de conocimiento deben comprobarse en cada organización antes de habilitar respuestas automáticas.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección