Definizione in una frase
Grado di incertezza su una previsione, una risposta, le prove disponibili o la validità di una misurazione.
Definizione e concetti da non confondere
L'incertezza è il grado di mancanza di certezza su una previsione, una risposta, l'evidenza disponibile o la validità di una misurazione. Nel contesto della statistica e dell'apprendimento automatico, non si tratta di un errore puntuale, ma di una misura della variabilità potenziale dei risultati. Come ha sottolineato lo statistico George Box, "tutti i modelli sono sbagliati, ma alcuni sono utili"; l'incertezza consente di quantificare quanto un modello si discosti dalla realtà e, quindi, di determinarne l'utilità pratica.
È cruciale distinguere l'incertezza dall'accuratezza e dalla precisione. L'accuratezza si riferisce all'approssimazione di una previsione a un valore noto, mentre l'incertezza descrive quanto le previsioni e i valori obiettivo possano variare. Un sistema può essere preciso (ripetibile) ma non accurato, o viceversa. La quantificazione dell'incertezza (UQ) trasforma l'affermazione vaga che "un modello potrebbe essere errato" in informazioni specifiche e quantificabili sul grado e sulla natura dell'errore possibile, il che è vitale in campi dove l'affidabilità è primaria, come la medicina o l'ingegneria.
Differenze chiave tra concetti correlati
Tabella comparativa per distinguere i concetti che spesso vengono confusi nella valutazione dei modelli.
| Concetto | Definizione | Si può ridurre con più dati? |
|---|---|---|
| Incertezza aleatoria | Rumore intrinseco al processo di generazione dei dati (stocastico). | No, è irriducibile. |
| Incertezza epistemica | Mancanza di conoscenza sul modello ottimale o dati insufficienti. | Sì, teoricamente riducibile. |
| Accuratezza | Vicinanza della previsione al valore vero. | Dipende dalla qualità del modello e dei dati. |
| Precisione | Coerenza delle previsioni tra loro (ripetibilità). | Sì, con una migliore calibrazione. |
Funzionamento passo dopo passo: dalla previsione alla distribuzione
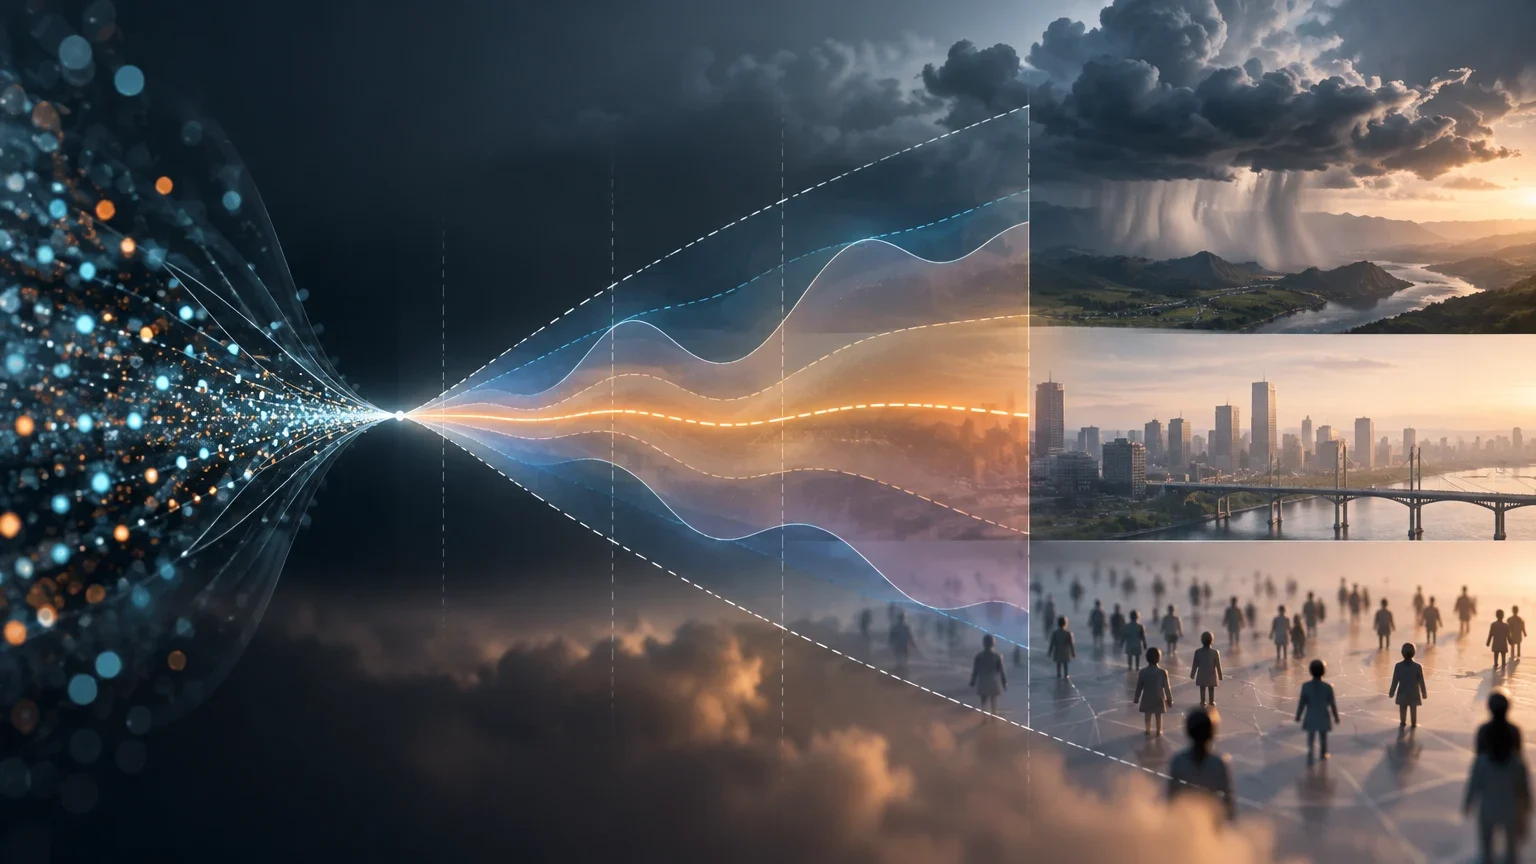
Il funzionamento della quantificazione dell'incertezza parte dal considerare le uscite di un modello non come valori fissi, ma come variabili casuali. Invece di generare una singola stima puntuale, il modello produce una distribuzione di probabilità. L'ampiezza di questa distribuzione è la misura diretta dell'incertezza: più ampia è la distribuzione, maggiore sarà l'incertezza associata al risultato.
Esistono due fonti principali di questa variabilità. La prima è l'incertezza aleatoria, che deriva da processi stocastici o caratteristiche casuali nel sistema. Ad esempio, la variabilità naturale nella risposta di un materiale a una forza. La seconda è l'incertezza epistemica, che proviene dalla conoscenza incompleta, come la mancanza di dati di addestramento in certe regioni dello spazio delle caratteristiche. I metodi di UQ cercano di separare o stimare queste componenti per determinare la fiducia che si deve avere in una previsione specifica.
Flusso base di quantificazione dell'incertezza
Processo generale per stimare l'incertezza in un modello predittivo.
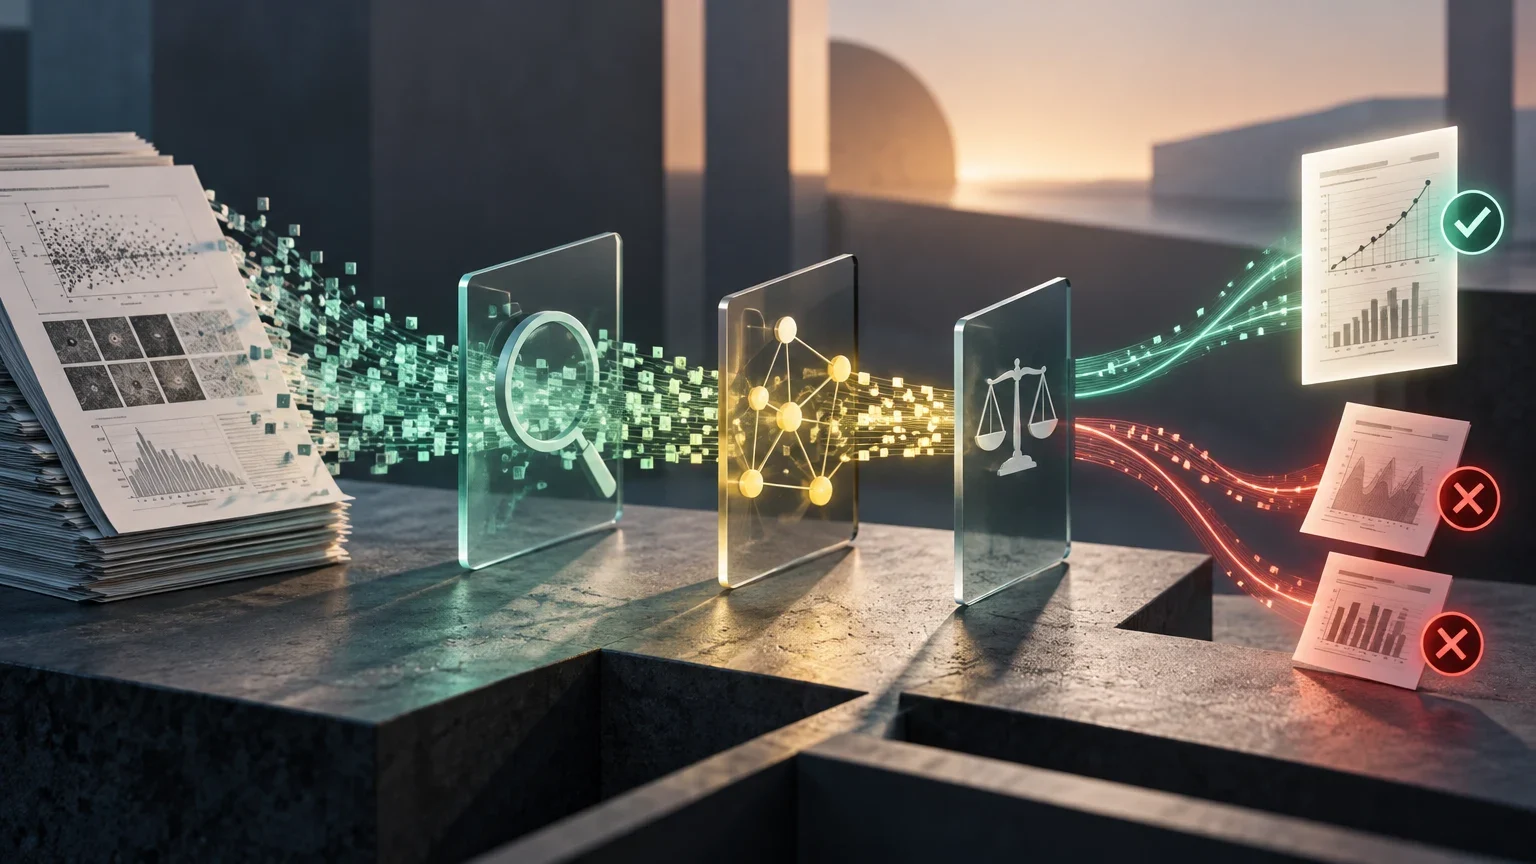
- 01Definire il modello base e i dati di addestramento.
- 02Identificare le fonti di variabilità (aleatoria vs. epistemica).
- 03Applicare un metodo di quantificazione (es. campionamento, bayesiano o ensemble).
- 04Generare una distribuzione di previsioni anziché un singolo valore.
- 05Calcolare metriche di dispersione (varianza, intervalli di confidenza) per quantificare l'incertezza.
- 06Valutare la calibrazione del modello confrontando la fiducia prevista con la frequenza osservata di successi.
Tre esempi sviluppati in ambiti rilevanti
In meteorologia, un modello può prevedere una probabilità di pioggia del 70%. La quantificazione dell'incertezza aiuta a determinare se quel 70% si basa su dati solidi o se l'incertezza è così alta che la probabilità reale potrebbe oscillare tra il 50% e il 90%. Questo consente agli utenti di prendere decisioni più informate, come se portare l'ombrello o rimandare eventi all'aperto, basandosi sull'intervallo di risultati possibili anziché su un singolo numero.
In ingegneria, si consideri un modello che predice quante volte si può aprire e chiudere una cerniera prima che si guasti. L'incertezza aleatoria cattura la variabilità materiale intrinseca, mentre quella epistemica riflette la mancanza di test in condizioni estreme. Un sistema di visione artificiale che classifica solo mele rosse o verdi ha molta meno incertezza intrinseca rispetto a uno che classifica tutti i frutti del mondo, a causa della maggiore complessità e variabilità dei dati nel secondo caso.
Nelle scienze sociali e in economia, l'incertezza influisce sulla validità delle previsioni quantitative. I modelli di machine learning applicati a dati sociali devono considerare l'incertezza epistemica derivante dalla complessità delle interazioni umane e dalla limitazione dei dati storici. Distinguere tra il rumore casuale nei dati e la mancanza di conoscenza sui meccanismi causali è essenziale per evitare il sovrapprendimento e per interpretare correttamente i limiti dei modelli predittivi in contesti dinamici.
Metodi di quantificazione: campionamento, bayesiano ed ensemble
I metodi basati sul campionamento, come la simulazione di Monte Carlo, sono ampiamente utilizzati perché possono gestire qualsiasi complessità del modello. Eseguono migliaia di simulazioni con ingressi variati casualmente per costruire un'immagine statistica dei risultati probabili. Una variante efficiente è il campionamento dell'iper-cubo latino, che copre bene lo spazio di ingresso con meno esecuzioni. Il dropout di Monte Carlo (Monte Carlo Dropout) è un'altra tecnica che mantiene attivo il layer di dropout durante l'inferenza, generando più passaggi in avanti per ottenere una distribuzione di uscite senza bisogno di riaddestrare il modello.
I metodi bayesiani assegnano distribuzioni di probabilità ai parametri del modello anziché valori fissi. Utilizzano il teorema di Bayes per combinare credenze precedenti con dati osservati. Le reti neurali bayesiane (BNN) trattano i pesi della rete come distribuzioni di probabilità, consentendo una quantificazione rigorosa dell'incertezza. I metodi di ensemble si basano sull'idea che se più modelli addestrati indipendentemente non sono d'accordo su una previsione, quel disaccordo indica incertezza. La varianza delle previsioni dell'ensemble viene utilizzata come misura dell'incertezza, anche se questo approccio ha un alto costo computazionale.
Confronto dei metodi di quantificazione dell'incertezza
Riepilogo dei vantaggi e dei limiti dei principali metodi.
| Metodo | Vantaggio principale | Limitazione principale |
|---|---|---|
| Monte Carlo | Flessibile, gestisce qualsiasi complessità. | Costoso computazionalmente (migliaia di esecuzioni). |
| Bayesiano (BNN) | Rigoroso, separa aleatoria ed epistemica. | Complesso da implementare, richiede MCMC o variazionale. |
| Ensemble | Intuitivo, misura il disaccordo tra modelli. | Molto costoso (addestrare N modelli completi). |
| Processi Gaussiani (GPR) | Efficiente, esprime l'incertezza intrinsecamente. | Scalabilità limitata con grandi set di dati. |
Errori comuni e limiti della quantificazione
Un errore frequente è assumere che l'incertezza sia sempre riducibile con più dati. L'incertezza aleatoria è irriducibile; deriva dalla natura stocastica del fenomeno. Tentare di ridurla aggiungendo più dati aumenta solo il costo senza migliorare la precisione fondamentale. Un altro errore è confondere la calibrazione con l'accuratezza. Un modello può essere ben calibrato (la sua fiducia riflette la probabilità reale di successo) ma impreciso nelle sue previsioni puntuali.
I limiti della quantificazione dell'incertezza includono il costo computazionale, specialmente nei modelli di deep learning ad alta dimensionalità. Inoltre, la scelta del metodo di quantificazione dipende dalle caratteristiche del modello e dello scenario. Non esiste un metodo universale; la maggior parte delle applicazioni del mondo reale combina più approcci. È importante ricordare che l'incertezza quantificata è una stima, non una verità assoluta, e deve essere interpretata nel contesto delle assunzioni del modello.
Domande frequenti e fonti primarie
Qual è la differenza principale tra incertezza aleatoria ed epistemica? L'incertezza aleatoria è il rumore intrinseco ai dati, irriducibile. Quella epistemica è la mancanza di conoscenza del modello, riducibile con più dati o un migliore modellamento. Quali metriche vengono utilizzate per valutare l'incertezza? Vengono utilizzate regole di punteggio adeguate (come la log-verosimiglianza negativa, NLL) e metriche di calibrazione (come l'errore di calibrazione atteso, ECE). La NLL misura l'adattamento della distribuzione prevista ai risultati osservati, mentre l'ECE misura la differenza tra la fiducia prevista e la frequenza osservata di successi.
La previsione conforme è utile per i modelli black-box? Sì, la previsione conforme è una tecnica indipendente dal modello che fornisce garanzie di copertura valide con assunzioni minime. È particolarmente utile quando si lavora con modelli pre-addestrati black-box, poiché consente di stabilire intervalli di previsione senza bisogno di conoscere la struttura interna del modello. Le fonti primarie includono il lavoro di Hüllermeier e Waegeman sulla distinzione concettuale e il paper di Chavare e Mourelatos sui metodi di quantificazione in ingegneria.