Definition in einem Satz
Grad der Unsicherheit über eine Vorhersage, eine Antwort, die verfügbare Evidenz oder die Gültigkeit einer Messung.
Definition und Konzepte, die nicht verwechselt werden dürfen
Unsicherheit ist der Grad an Mangel an Gewissheit über eine Vorhersage, eine Antwort, den verfügbaren Beweisen oder die Gültigkeit einer Messung. Im Kontext der Statistik und des maschinellen Lernens handelt es sich nicht um einen punktuellen Fehler, sondern um ein Maß für die potenzielle Variabilität der Ergebnisse. Wie der Statistiker George Box bemerkte: „Alle Modelle sind falsch, aber einige sind nützlich“; die Unsicherheit ermöglicht es, zu quantifizieren, wie stark ein Modell von der Realität abweicht und damit seinen praktischen Nutzen zu bestimmen.
Es ist entscheidend, Unsicherheit von Genauigkeit und Präzision zu unterscheiden. Genauigkeit bezieht sich auf die Annäherung einer Vorhersage an einen bekannten Wert, während Unsicherheit beschreibt, wie stark sich Vorhersagen und Zielwerte verändern können. Ein System kann präzise (wiederholbar), aber ungenau sein, oder umgekehrt. Die Quantifizierung der Unsicherheit (UQ) wandelt die vage Aussage, dass „ein Modell falsch sein könnte“, in spezifische und quantifizierbare Informationen über den Grad und die Natur des möglichen Fehlers um. Dies ist in Bereichen von entscheidender Bedeutung, in denen Zuverlässigkeit im Vordergrund steht, wie in der Medizin oder im Ingenieurwesen.
Wesentliche Unterschiede zwischen verwandten Konzepten
Vergleichstabelle zur Unterscheidung von Konzepten, die bei der Modellbewertung oft verwechselt werden.
| Konzept | Definition | Reduzierbar mit mehr Daten? |
|---|---|---|
| Aleatorische Unsicherheit | Inhärentes Rauschen im Datenbildungsprozess (stochastisch). | Nein, sie ist irreduzibel. |
| Epistemische Unsicherheit | Mangel an Wissen über das optimale Modell oder unzureichende Daten. | Ja, theoretisch reduzierbar. |
| Genauigkeit | Nähe der Vorhersage zum wahren Wert. | Hängt von der Qualität des Modells und der Daten ab. |
| Präzision | Konsistenz der Vorhersagen untereinander (Wiederholbarkeit). | Ja, mit besserer Kalibrierung. |
Funktionsweise Schritt für Schritt: Von der Vorhersage zur Verteilung
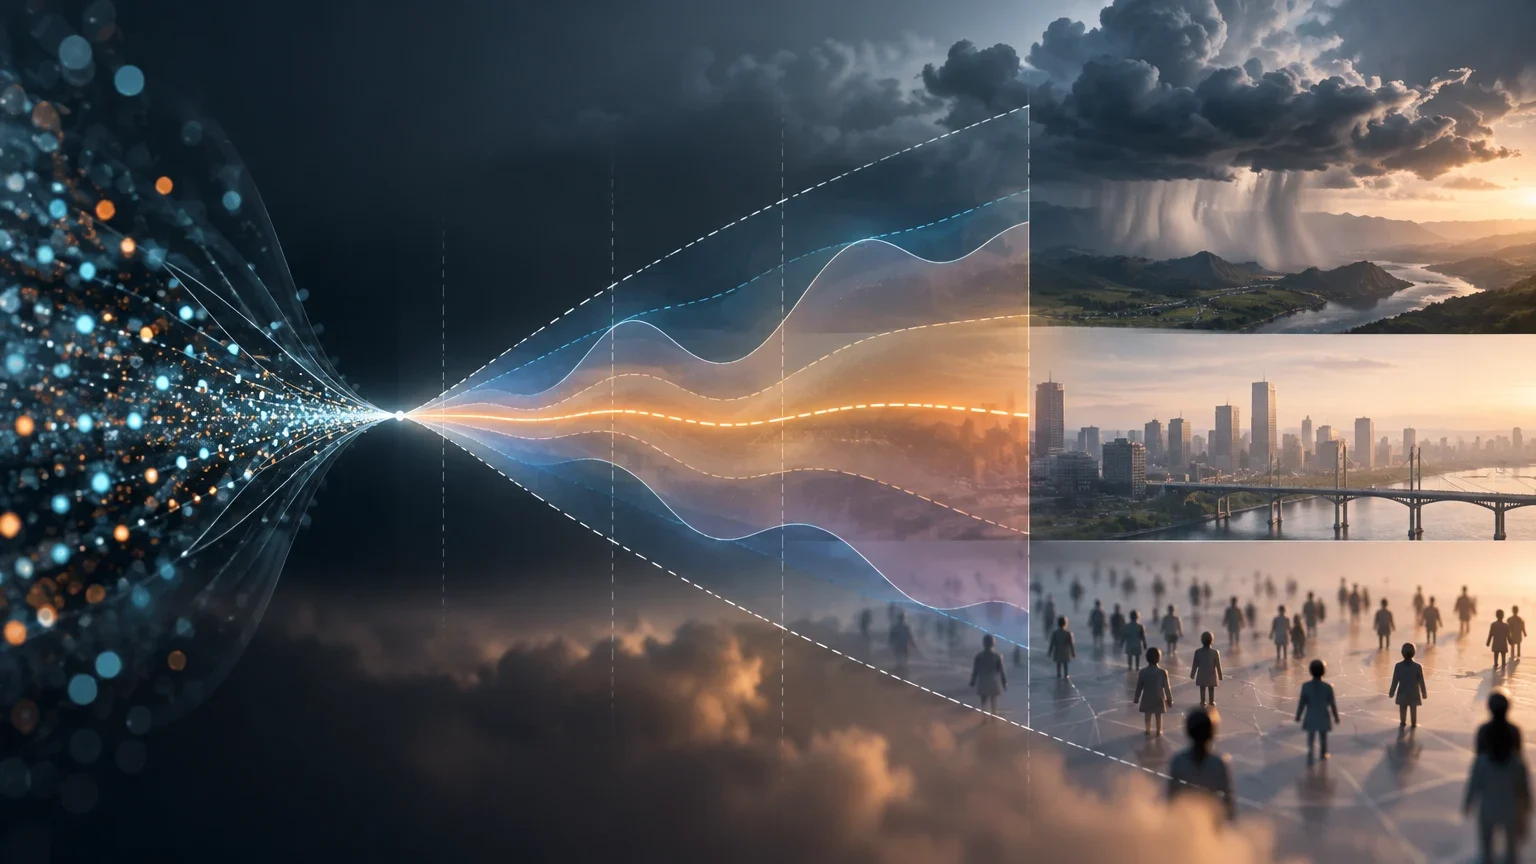
Die Funktionsweise der Unsicherheitsquantifizierung basiert darauf, die Ausgaben eines Modells nicht als feste Werte, sondern als Zufallsvariablen zu behandeln. Anstatt eine einzelne Punktschätzung zu erzeugen, produziert das Modell eine Wahrscheinlichkeitsverteilung. Die Breite dieser Verteilung ist das direkte Maß für die Unsicherheit: Je breiter die Verteilung, desto größer die mit dem Ergebnis verbundene Unsicherheit.
Es gibt zwei Hauptquellen für diese Variabilität. Die erste ist die aleatorische Unsicherheit, die aus stochastischen Prozessen oder zufälligen Merkmalen im System entsteht. Ein Beispiel ist die natürliche Variabilität in der Reaktion eines Materials auf eine Kraft. Die zweite ist die epistemische Unsicherheit, die vom unvollständigen Wissen stammt, wie z. B. der Mangel an Trainingsdaten in bestimmten Regionen des Merkmalsraums. Die UQ-Methoden zielen darauf ab, diese Komponenten zu trennen oder zu schätzen, um das Vertrauen in eine konkrete Vorhersage zu bestimmen.
Grundlegender Ablauf der Unsicherheitsquantifizierung
Allgemeiner Prozess zur Schätzung der Unsicherheit in einem prädiktiven Modell.
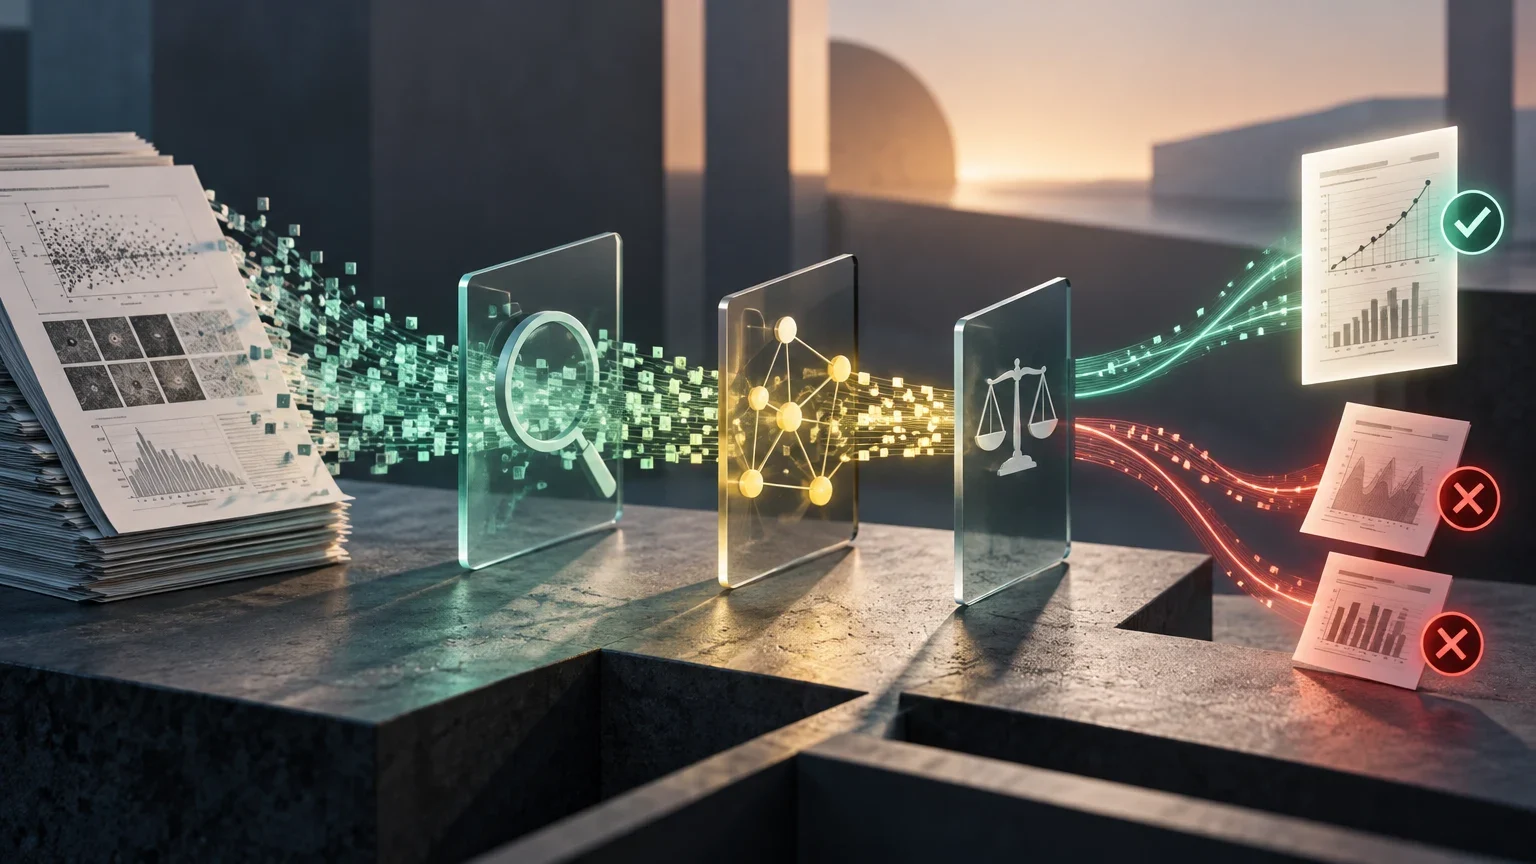
- 01Basismodell und Trainingsdaten definieren.
- 02Quellen der Variabilität identifizieren (aleatorisch vs. epistemisch).
- 03Eine Quantifizierungsmethode anwenden (z. B. Sampling, bayessche Methode oder Ensemble).
- 04Eine Verteilung von Vorhersagen statt eines einzelnen Werts generieren.
- 05Dispersionsmetriken (Varianz, Konfidenzintervalle) berechnen, um die Unsicherheit zu quantifizieren.
- 06Die Kalibrierung des Modells bewerten, indem die vorhergesagte Konfidenz mit der beobachteten Trefferquote verglichen wird.
Drei ausgearbeitete Beispiele in relevanten Bereichen
In der Meteorologie kann ein Modell eine 70-prozentige Wahrscheinlichkeit für Regen vorhersagen. Die Quantifizierung der Unsicherheit hilft dabei zu bestimmen, ob diese 70 % auf soliden Daten basieren oder ob die Unsicherheit so hoch ist, dass die tatsächliche Wahrscheinlichkeit zwischen 50 % und 90 % schwanken könnte. Dies ermöglicht es den Nutzern, informiertere Entscheidungen zu treffen, wie z. B. einen Regenschirm mitzunehmen oder Outdoor-Events zu verschieben, basierend auf dem Spektrum möglicher Ergebnisse anstelle einer einzelnen Zahl.
Im Ingenieurwesen betrachten wir ein Modell, das vorhersagt, wie oft ein Scharnier geöffnet und geschlossen werden kann, bevor es versagt. Die aleatorische Unsicherheit erfasst die inhärente Materialvariabilität, während die epistemische Unsicherheit den Mangel an Tests unter Extrembedingungen widerspiegelt. Ein Computer-Vision-System, das nur rote oder grüne Äpfel klassifiziert, hat eine viel geringere inhärente Unsicherheit als eines, das alle Früchte der Welt klassifiziert, aufgrund der höheren Komplexität und Variabilität der Daten im zweiten Fall.
In den Sozial- und Wirtschaftswissenschaften beeinflusst die Unsicherheit die Gültigkeit quantitativer Vorhersagen. Machine-Learning-Modelle, die auf sozialen Daten angewendet werden, müssen die epistemische Unsicherheit berücksichtigen, die aus der Komplexität menschlicher Interaktionen und der Begrenzung historischer Daten resultiert. Die Unterscheidung zwischen zufälligem Rauschen in den Daten und dem Mangel an Wissen über kausale Mechanismen ist entscheidend, um Überanpassung zu vermeiden und die Grenzen prädiktiver Modelle in dynamischen Kontexten korrekt zu interpretieren.
Quantifizierungsmethoden: Sampling, bayessche Ansätze und Ensembles
Sampling-basierte Methoden wie die Monte-Carlo-Simulation sind weit verbreitet, da sie jede Modellkomplexität bewältigen können. Sie führen Tausende von Simulationen mit zufällig variierten Eingaben durch, um ein statistisches Bild der wahrscheinlichen Ergebnisse zu erstellen. Eine effiziente Variante ist die lateinische Hyperwürfel-Sampling-Methode, die den Eingaberaum mit weniger Ausführungen gut abdeckt. Monte-Carlo-Dropout ist eine weitere Technik, die die Dropout-Schicht während der Inferenz aktiv hält und mehrere Vorwärtspässe durchführt, um eine Verteilung der Ausgaben zu erhalten, ohne das Modell neu trainieren zu müssen.
Bayessche Methoden weisen den Modellparametern Wahrscheinlichkeitsverteilungen statt fester Werte zu. Sie nutzen den Satz von Bayes, um vorherige Überzeugungen mit beobachteten Daten zu kombinieren. Bayessche neuronale Netze (BNN) behandeln die Gewichte des Netzes als Wahrscheinlichkeitsverteilungen, was eine rigorose Quantifizierung der Unsicherheit ermöglicht. Ensemble-Methoden basieren auf der Idee, dass wenn mehrere unabhängig trainierte Modelle nicht übereinstimmen, dieser Mangel an Konsens Unsicherheit anzeigt. Die Varianz der Ensemble-Vorhersagen wird als Maß für die Unsicherheit verwendet, obwohl dieser Ansatz hohe rechnerische Kosten verursacht.
Vergleich der Unsicherheitsquantifizierungsmethoden
Zusammenfassung der Vorteile und Einschränkungen der wichtigsten Methoden.
| Methode | Hauptvorteil | Hauptbeschränkung |
|---|---|---|
| Monte Carlo | Flexibel, handhabt jede Komplexität. | Rechnerisch teuer (Tausende von Ausführungen). |
| Bayessch (BNN) | Rigoros, trennt aleatorisch und epistemisch. | Komplex in der Implementierung, erfordert MCMC oder Variational Inference. |
| Ensembles | Intuitiv, misst die Diskrepanz zwischen Modellen. | Sehr teuer (Training von N vollständigen Modellen). |
| Gauß-Prozesse (GPR) | Effizient, drückt Unsicherheit inhärent aus. | Begrenzte Skalierbarkeit mit großen Datensätzen. |
Häufige Fehler und Grenzen der Quantifizierung
Ein häufiger Fehler ist die Annahme, dass Unsicherheit immer durch mehr Daten reduziert werden kann. Aleatorische Unsicherheit ist irreduzibel; sie stammt aus der stochastischen Natur des Phänomens. Der Versuch, sie durch das Hinzufügen von Daten zu reduzieren, erhöht nur die Kosten, ohne die grundlegende Präzision zu verbessern. Ein weiterer Fehler ist die Verwechslung von Kalibrierung und Präzision. Ein Modell kann gut kalibriert sein (seine Konfidenz spiegelt die tatsächliche Wahrscheinlichkeit eines Treffers wider), aber in seinen Punktvorhersagen ungenau sein.
Die Grenzen der Unsicherheitsquantifizierung umfassen die rechnerischen Kosten, insbesondere bei hochdimensionalen Deep-Learning-Modellen. Außerdem hängt die Wahl der Quantifizierungsmethode von den Merkmalen des Modells und des Szenarios ab. Es gibt keine universelle Methode; die meisten realen Anwendungen kombinieren mehrere Ansätze. Es ist wichtig zu bedenken, dass quantifizierte Unsicherheit eine Schätzung und keine absolute Wahrheit ist und im Kontext der Modellannahmen interpretiert werden muss.
Häufig gestellte Fragen und Primärquellen
Was ist der Hauptunterschied zwischen aleatorischer und epistemischer Unsicherheit? Aleatorische Unsicherheit ist das inhärente Rauschen in den Daten und ist irreduzibel. Epistemische Unsicherheit ist der Wissensmangel des Modells und ist durch mehr Daten oder bessere Modellierung reduzierbar. Welche Metriken werden verwendet, um Unsicherheit zu bewerten? Es werden adäquate Scoring-Regeln (wie die negative Log-Likelihood, NLL) und Kalibrierungsmetriken (wie der erwartete Kalibrierungsfehler, ECE) verwendet. Die NLL misst die Anpassung der vorhergesagten Verteilung an die beobachteten Ergebnisse, während der ECE den Unterschied zwischen der vorhergesagten Konfidenz und der beobachteten Trefferquote misst.
Ist konforme Vorhersage nützlich für Black-Box-Modelle? Ja, konforme Vorhersage ist eine modellunabhängige Technik, die gültige Abdeckungsgarantien mit minimalen Annahmen bietet. Sie ist besonders nützlich bei der Arbeit mit vortrainierten Black-Box-Modellen, da sie Prognoseintervalle festlegen lässt, ohne die interne Struktur des Modells kennen zu müssen. Zu den Primärquellen gehören die Arbeit von Hüllermeier und Waegeman zur konzeptionellen Unterscheidung und der Paper von Chavare und Mourelatos zu Quantifizierungsmethoden im Ingenieurwesen.