Definición en una frase
Grado de falta de certeza sobre una predicción, una respuesta, la evidencia disponible o la validez de una medición.
Definición y conceptos que no deben confundirse
La incertidumbre es el grado de falta de certeza sobre una predicción, una respuesta, la evidencia disponible o la validez de una medición. En el contexto de la estadística y el aprendizaje automático, no se trata de un error puntual, sino de una medida de la variabilidad potencial de los resultados. Como señaló el estadístico George Box, "todos los modelos son incorrectos, pero algunos son útiles"; la incertidumbre permite cuantificar cuánto se desvía un modelo de la realidad y, por tanto, determinar su utilidad práctica.
Es crucial distinguir la incertidumbre de la precisión y la exactitud. La exactitud se refiere a la aproximación de una predicción a un valor conocido, mientras que la incertidumbre describe cuánto pueden variar las predicciones y los valores objetivo. Un sistema puede ser preciso (repetible) pero inexacto, o viceversa. La cuantificación de la incertidumbre (UQ) transforma la afirmación vaga de que "un modelo podría ser erróneo" en información específica y cuantificable sobre el grado y la naturaleza del posible error, lo cual es vital en campos donde la fiabilidad es primordial, como la medicina o la ingeniería.
Diferencias clave entre conceptos relacionados
Tabla comparativa para distinguir conceptos que suelen confundirse en la evaluación de modelos.
| Concepto | Definición | ¿Se puede reducir con más datos? |
|---|---|---|
| Incertidumbre aleatoria | Ruido inherente al proceso de generación de datos (estocástico). | No, es irreducible. |
| Incertidumbre epistémica | Falta de conocimiento sobre el modelo óptimo o datos insuficientes. | Sí, teóricamente reducible. |
| Exactitud | Cercanía de la predicción al valor verdadero. | Depende de la calidad del modelo y datos. |
| Precisión | Consistencia de las predicciones entre sí (repetibilidad). | Sí, con mejor calibración. |
Funcionamiento paso a paso: de la predicción a la distribución
El funcionamiento de la cuantificación de la incertidumbre parte de tratar las salidas de un modelo no como valores fijos, sino como variables aleatorias. En lugar de generar una única estimación puntual, el modelo produce una distribución de probabilidad. La amplitud de esta distribución es la medida directa de la incertidumbre: cuanto más ancha sea la distribución, mayor será la incertidumbre asociada al resultado.
Existen dos fuentes principales de esta variabilidad. La primera es la incertidumbre aleatoria, que surge de procesos estocásticos o características aleatorias en el sistema. Por ejemplo, la variabilidad natural en la respuesta de un material a una fuerza. La segunda es la incertidumbre epistémica, que proviene del conocimiento incompleto, como la falta de datos de entrenamiento en ciertas regiones del espacio de características. Los métodos de UQ buscan separar o estimar estas componentes para determinar la confianza que debe tenerse en una predicción concreta.
Flujo básico de cuantificación de incertidumbre
Proceso general para estimar la incertidumbre en un modelo predictivo.
- 01Definir el modelo base y los datos de entrenamiento.
- 02Identificar las fuentes de variabilidad (aleatoria vs. epistémica).
- 03Aplicar un método de cuantificación (ej. muestreo, bayesiano o conjunto).
- 04Generar una distribución de predicciones en lugar de un valor único.
- 05Calcular métricas de dispersión (varianza, intervalos de confianza) para cuantificar la incertidumbre.
- 06Evaluar la calibración del modelo comparando la confianza prevista con la frecuencia observada de aciertos.
Tres ejemplos desarrollados en ámbitos relevantes
En meteorología, un modelo puede predecir un 70% de probabilidad de lluvia. La cuantificación de la incertidumbre ayuda a determinar si ese 70% se basa en datos sólidos o si la incertidumbre es tan alta que la probabilidad real podría oscilar entre el 50% y el 90%. Esto permite a los usuarios tomar decisiones más informadas, como si llevar paraguas o posponer eventos al aire libre, basándose en el rango de resultados posibles en lugar de una cifra única.
En ingeniería, considere un modelo que predice cuántas veces se puede abrir y cerrar una bisagra antes de que falle. La incertidumbre aleatoria captura la variabilidad material inherente, mientras que la epistémica refleja la falta de pruebas en condiciones extremas. Un sistema de visión artificial que clasifica solo manzanas rojas o verdes tiene mucha menos incertidumbre inherente que uno que clasifica todas las frutas del mundo, debido a la mayor complejidad y variabilidad de los datos en el segundo caso.
En ciencias sociales y economía, la incertidumbre afecta la validez de las predicciones cuantitativas. Modelos de machine learning aplicados a datos sociales deben considerar la incertidumbre epistémica derivada de la complejidad de las interacciones humanas y la limitación de los datos históricos. Distinguir entre el ruido aleatorio en los datos y la falta de conocimiento sobre los mecanismos causales es esencial para evitar sobreajustes y para interpretar correctamente las limitaciones de los modelos predictivos en contextos dinámicos.
Métodos de cuantificación: muestreo, bayesiano y conjuntos
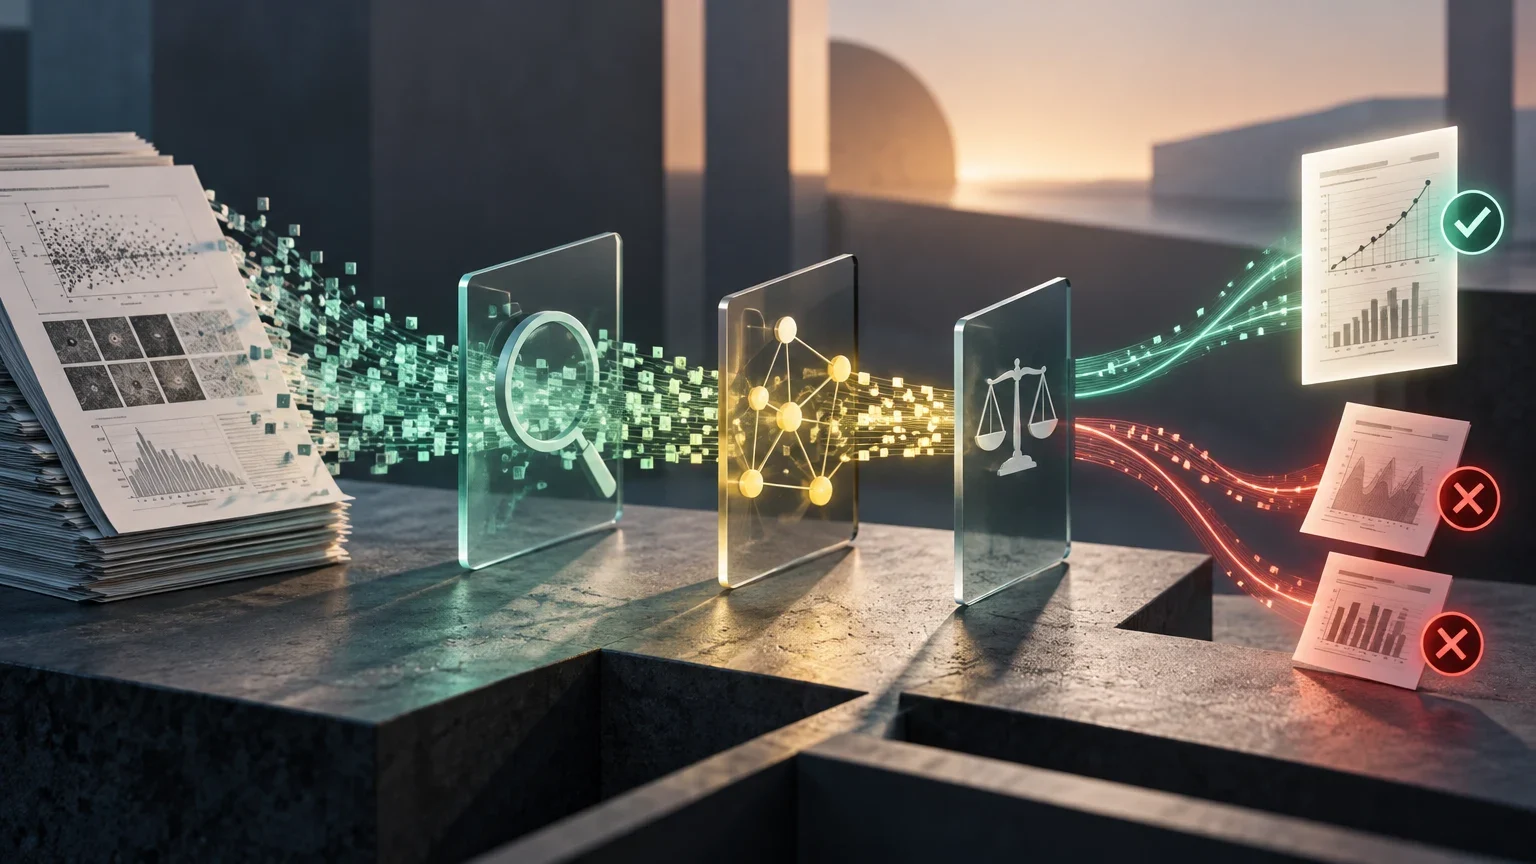
Los métodos basados en el muestreo, como la simulación de Monte Carlo, son ampliamente utilizados porque pueden manejar cualquier complejidad del modelo. Ejecutan miles de simulaciones con entradas variadas aleatoriamente para construir una imagen estadística de los resultados probables. Una variante eficiente es el muestreo de hipercubo latino, que cubre bien el espacio de entrada con menos ejecuciones. El abandono de Monte Carlo (Monte Carlo Dropout) es otra técnica que mantiene la capa de abandono activa durante la inferencia, generando múltiples pasadas hacia adelante para obtener una distribución de salidas sin necesidad de reentrenar el modelo.
Los métodos bayesianos asignan distribuciones de probabilidad a los parámetros del modelo en lugar de valores fijos. Utilizan el teorema de Bayes para combinar creencias previas con datos observados. Las redes neuronales bayesianas (BNN) tratan los pesos de la red como distribuciones de probabilidad, permitiendo una cuantificación rigurosa de la incertidumbre. Los métodos de conjunto (ensembles) se basan en la idea de que si varios modelos entrenados de forma independiente no están de acuerdo, ese desacuerdo indica incertidumbre. La varianza de las predicciones del conjunto se utiliza como medida de la incertidumbre, aunque este enfoque tiene un alto coste computacional.
Comparación de métodos de cuantificación de incertidumbre
Resumen de ventajas y limitaciones de los principales métodos.
| Método | Ventaja principal | Limitación principal |
|---|---|---|
| Monte Carlo | Flexible, maneja cualquier complejidad. | Costoso computacionalmente (miles de ejecuciones). |
| Bayesiano (BNN) | Riguroso, separa aleatoria y epistémica. | Complejo de implementar, requiere MCMC o variacional. |
| Conjuntos (Ensembles) | Intuitivo, mide el desacuerdo entre modelos. | Muy costoso (entrenar N modelos completos). |
| Procesos Gaussianos (GPR) | Eficiente, expresa incertidumbre inherentemente. | Escalabilidad limitada con grandes conjuntos de datos. |
Errores habituales y límites de la cuantificación
Un error frecuente es asumir que la incertidumbre es siempre reducible con más datos. La incertidumbre aleatoria es irreducible; proviene de la naturaleza estocástica del fenómeno. Intentar reducirla añadiendo más datos solo aumenta el coste sin mejorar la precisión fundamental. Otro error es confundir la calibración con la precisión. Un modelo puede estar bien calibrado (su confianza refleja la probabilidad real de acierto) pero ser impreciso en sus predicciones puntuales.
Los límites de la cuantificación de la incertidumbre incluyen el coste computacional, especialmente en modelos de deep learning de alta dimensionalidad. Además, la elección del método de cuantificación depende de las características del modelo y el escenario. No existe un método universal; la mayoría de las aplicaciones del mundo real combinan múltiples enfoques. Es importante recordar que la incertidumbre cuantificada es una estimación, no una verdad absoluta, y debe interpretarse en el contexto de las suposiciones del modelo.
Preguntas frecuentes y fuentes primarias
¿Cuál es la diferencia principal entre incertidumbre aleatoria y epistémica? La incertidumbre aleatoria es el ruido inherente a los datos, irreducible. La epistémica es la falta de conocimiento del modelo, reducible con más datos o mejor modelado. ¿Qué métricas se utilizan para evaluar la incertidumbre? Se utilizan reglas de puntuación adecuadas (como la probabilidad logarítmica negativa, NLL) y métricas de calibración (como el error de calibración esperado, ECE). La NLL mide el ajuste de la distribución prevista a los resultados observados, mientras que el ECE mide la diferencia entre la confianza prevista y la frecuencia observada de aciertos.
¿Es la predicción conforme útil para modelos de caja negra? Sí, la predicción conforme es una técnica independiente del modelo que proporciona garantías de cobertura válidas con suposiciones mínimas. Es especialmente útil cuando se trabaja con modelos preentrenados de caja negra, ya que permite establecer intervalos de predicción sin necesidad de conocer la estructura interna del modelo. Las fuentes primarias incluyen el trabajo de Hüllermeier y Waegeman sobre la distinción conceptual y el paper de Chavare y Mourelatos sobre métodos de cuantificación en ingeniería.