Definición en una frase
Capacidad de repetir una evaluación con versiones, datos, configuración y procedimiento documentados y obtener resultados compatibles.
Definición y conceptos que no deben confundirse
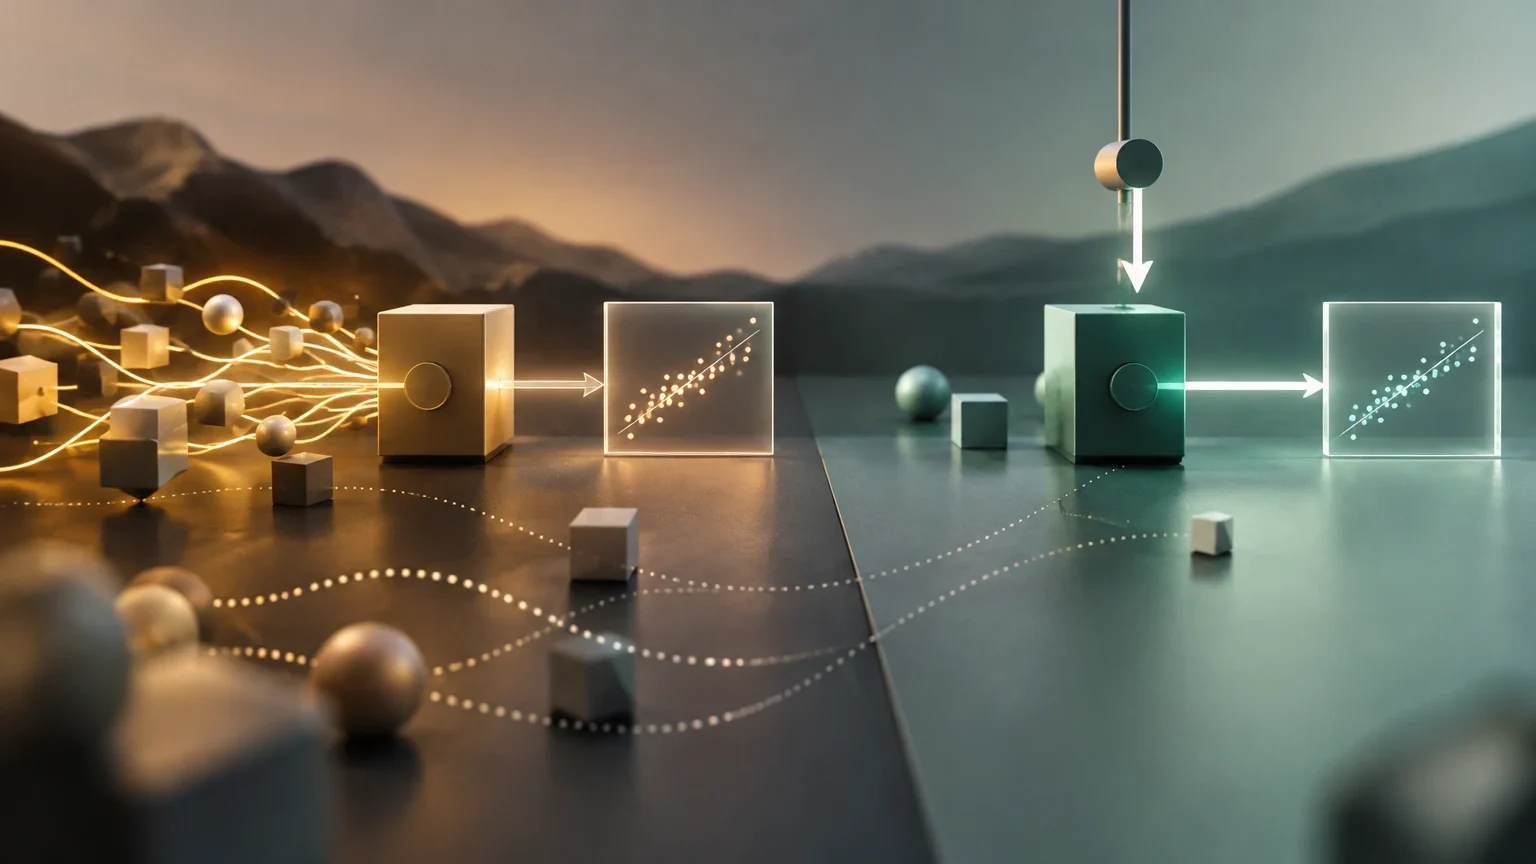
La reproducibilidad se define como la capacidad de un investigador para duplicar los resultados de un estudio previo utilizando los mismos materiales, datos y procedimientos que el investigador original. No se trata simplemente de obtener un resultado similar, sino de poder ejecutar el mismo proceso y verificar que los hallazgos se mantienen bajo las mismas condiciones.
Es fundamental distinguir la reproducibilidad de la replicabilidad. Mientras la reproducibilidad implica repetir el experimento con los mismos datos y código, la replicabilidad se refiere a obtener resultados consistentes en un estudio nuevo e independiente, a menudo con datos diferentes o en un contexto distinto. Confundir ambos términos puede llevar a conclusiones erróneas sobre la solidez de un hallazgo.
La distinción entre reproducibilidad y replicabilidad no es meramente semántica, sino que tiene implicaciones prácticas directas en cómo se diseñan los experimentos y cómo se interpretan sus resultados. Cuando un investigador busca reproducir un estudio, su objetivo es verificar la solidez técnica del proceso original, asegurándose de que no existan errores de implementación o sesgos ocultos en el código. En cambio, la replicabilidad pone a prueba la generalización del hallazgo, evaluando si la relación observada entre variables se mantiene cuando se cambia el contexto, la población o el conjunto de datos. Esta diferencia es crucial para determinar si un modelo es robusto o si simplemente se ha ajustado de forma excesiva a las particularidades de un conjunto de datos específico.
Además, es importante reconocer que la reproducibilidad absoluta es un ideal difícil de alcanzar, especialmente en sistemas complejos donde intervienen múltiples fuentes de variabilidad no controladas. En la práctica, se suele hablar de reproducibilidad estadística, donde se acepta una variación mínima dentro de un rango predefinido. Esto requiere que los autores de los estudios no solo compartan los resultados puntuales, sino también la incertidumbre asociada a ellos, permitiendo a otros investigadores evaluar si sus propias ejecuciones caen dentro de los márgenes esperados. Sin esta transparencia sobre la variabilidad, la comparación entre estudios se vuelve engañosa y puede llevar a conclusiones erróneas sobre la superioridad de un método frente a otro.
Diferencias clave entre reproducibilidad y replicabilidad
Tabla comparativa de los conceptos.
| Concepto | Definición | Requisitos principales |
|---|---|---|
| Reproducibilidad | Repetir el experimento original con los mismos datos y código. | Acceso al código, datos, configuración y entorno. |
| Replicabilidad | Obtener resultados consistentes en un estudio nuevo e independiente. | Datos nuevos o contexto diferente, misma metodología. |
Funcionamiento paso a paso
Lograr la reproducibilidad requiere un enfoque sistemático que abarca desde la documentación inicial hasta la ejecución final del experimento. El primer paso es establecer semillas aleatorias (random seeds) en todas las librerías que utilicen azar, como NumPy o PyTorch, para asegurar que la inicialización de pesos y el orden de los datos sean consistentes.
A continuación, es crucial fijar las versiones de las librerías y el entorno de ejecución. Herramientas como Docker o Conda permiten aislar el entorno, garantizando que el código se comporte igual en cualquier máquina. Además, el control de versiones con Git es indispensable para rastrear el estado exacto del código utilizado en cada experimento.
El control de las semillas aleatorias es el primer pilar de la reproducibilidad, pero su implementación requiere atención a los detalles técnicos de cada librería. No basta con establecer una semilla global; es necesario fijar las semillas en cada componente que introduzca azar, desde la inicialización de pesos en las redes neuronales hasta el orden de los datos en los conjuntos de entrenamiento y validación. En librerías como PyTorch o TensorFlow, existen funciones específicas para este propósito, pero su comportamiento puede variar entre versiones. Por lo tanto, documentar no solo el valor de la semilla, sino también la versión exacta de la librería utilizada, es esencial para que otro investigador pueda replicar la misma secuencia de operaciones aleatorias.
La gestión del entorno de ejecución va más allá de la simple instalación de dependencias. Herramientas como Docker permiten crear imágenes inmutables que encapsulan no solo las librerías de Python, sino también las versiones de los sistemas operativos, las bibliotecas de bajo nivel y las configuraciones de hardware específicas. Esto es particularmente relevante cuando se utilizan aceleradores de hardware como GPUs, donde las versiones de los controladores y las bibliotecas de cálculo (como CUDA o cuDNN) pueden influir significativamente en los resultados numéricos. Al aislar el entorno, se elimina la variabilidad introducida por las diferencias en las configuraciones locales de los investigadores, asegurando que el código se comporte de manera idéntica en cualquier máquina que cumpla con los requisitos de hardware.
Proceso básico para asegurar la reproducibilidad en ML
Pasos esenciales para documentar y ejecutar un experimento reproducible.
- 01Fijar semillas aleatorias en todas las librerías relevantes.
- 02Documentar y fijar versiones de dependencias (requirements.txt o environment.yml).
- 03Utilizar entornos virtuales o contenedores (Docker/Conda) para aislar el sistema.
- 04Registrar hiperparámetros, métricas y configuración con herramientas de seguimiento (MLflow, W&B).
- 05Versionar los datos y el código mediante Git y sistemas de control de datos (DVC).
Tres ejemplos desarrollados en ámbitos relevantes
En el ámbito de la ciencia de datos y el aprendizaje automático, la reproducibilidad es crítica para comparar modelos. Un ejemplo común es el entrenamiento de una red neuronal donde, sin fijar las semillas y las versiones de las librerías, los resultados pueden variar significativamente entre ejecuciones, dificultando la identificación de mejoras reales frente a variaciones aleatorias.
En biología y medicina, la reproducibilidad enfrenta desafíos adicionales debido a la complejidad de los sistemas biológicos. Un estudio que no documenta detalladamente el preprocesamiento de datos o los criterios de inclusión de muestras puede no ser reproducible, incluso si el código está disponible. La falta de transparencia en estos pasos es una de las principales causas de la crisis de reproducibilidad en estas disciplinas.
En el sector deportivo, la reproducibilidad se aplica a la predicción de comportamientos, como el abandono de clientes en centros de fitness. Un estudio que utiliza regresión logística para predecir bajas debe documentar las variables de comportamiento, el período de datos y la metodología de validación para que otros investigadores puedan aplicar el mismo modelo a nuevas muestras y verificar su efectividad.
En el ámbito de la ciencia de datos, la capacidad de comparar modelos de forma justa depende directamente de la reproducibilidad. Cuando se entrena una red neuronal, la variabilidad introducida por la inicialización aleatoria de los pesos y el orden de los datos puede enmascarar las mejoras reales logradas por cambios en la arquitectura o en los hiperparámetros. Si no se fijan estas variables, es imposible determinar si una mejora en la métrica de validación se debe a un ajuste más adecuado del modelo o simplemente a una suerte favorable en la inicialización. Por ello, los estudios rigurosos suelen reportar resultados promediados sobre múltiples ejecuciones con diferentes semillas, proporcionando una estimación más fiable del rendimiento esperado del modelo.
En biología y medicina, la complejidad de los sistemas estudiados añade una capa de dificultad adicional a la reproducibilidad. A diferencia de los datos sintéticos o estructurados, los datos biológicos suelen ser heterogéneos, ruidosos y sujetos a variaciones naturales que no siempre pueden controlarse experimentalmente. La falta de documentación detallada sobre el preprocesamiento de estos datos, como la normalización, la eliminación de outliers o los criterios de inclusión de muestras, puede hacer que un estudio sea irreproducible incluso si el código de análisis está disponible. Esto subraya la necesidad de adoptar estándares de documentación más estrictos en estas disciplinas, donde la transparencia en cada paso del pipeline de datos es tan importante como la calidad del código de análisis.
Cómo evaluar el resultado
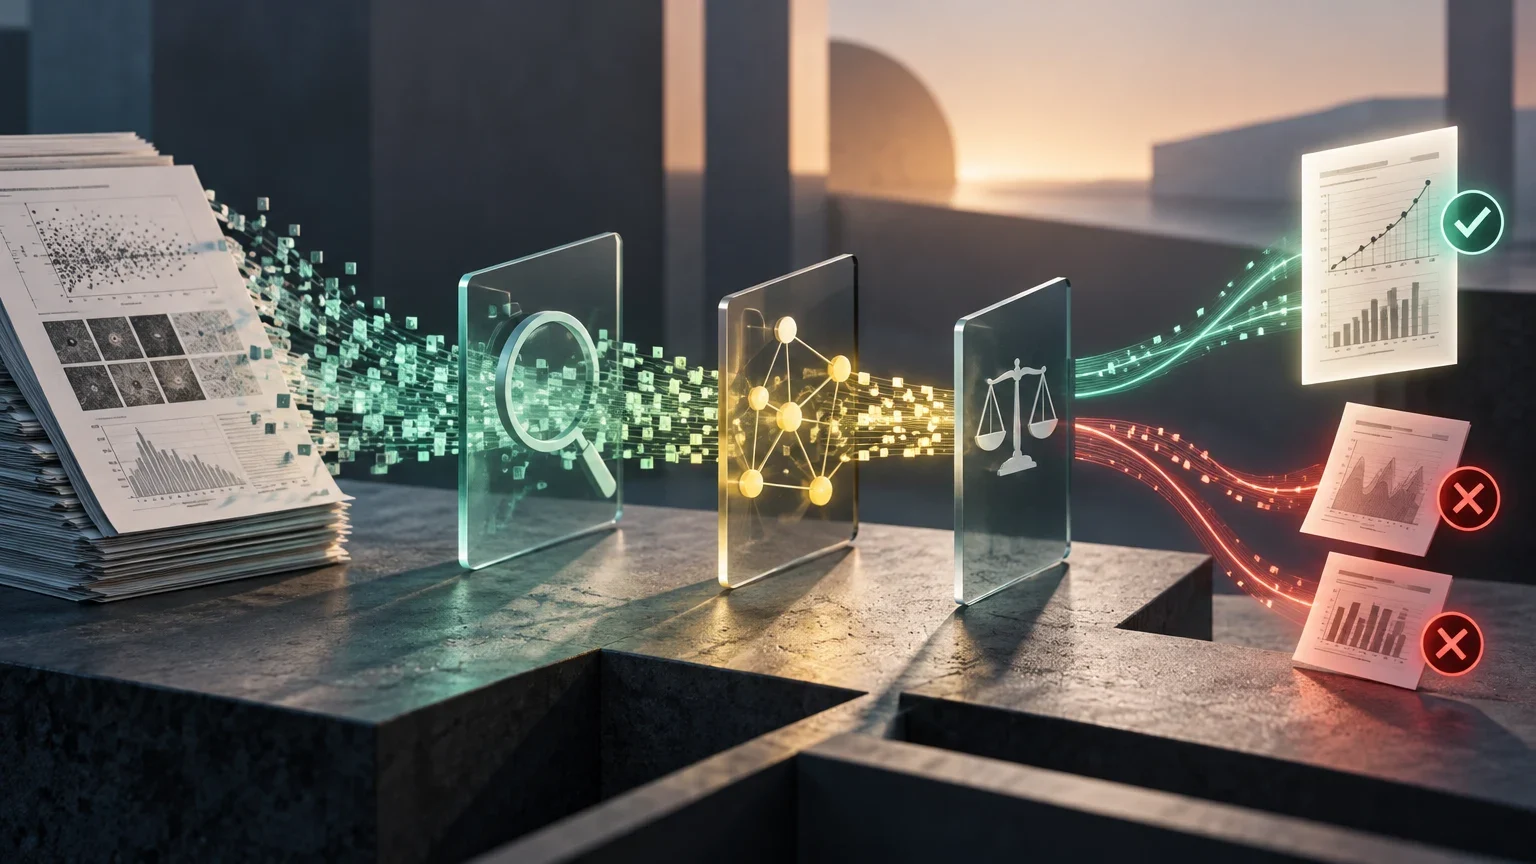
Evaluar la reproducibilidad no se limita a ejecutar el código y comparar los números finales. Es necesario verificar la consistencia de los resultados a través de múltiples ejecuciones y analizar la varianza. Si los resultados varían significativamente entre ejecuciones con la misma configuración, el experimento no es reproducible.
Además, es importante documentar las métricas de evaluación y los criterios de éxito. Un experimento puede ser reproducible en términos de código, pero si las métricas no se definen claramente, la interpretación de los resultados puede ser ambigua. La transparencia en la selección de métricas y la presentación de resultados es clave para una evaluación rigurosa.
La evaluación de la reproducibilidad requiere un enfoque crítico que vaya más allá de la simple ejecución del código. No es suficiente con que el programa termine sin errores; es necesario verificar que los resultados obtenidos sean consistentes con los reportados en el estudio original. Esto implica comparar no solo las métricas finales, sino también los intermedios, como las curvas de aprendizaje, las distribuciones de los datos preprocesados y los valores de las métricas en cada época de entrenamiento. Si existen discrepancias significativas en estos puntos intermedios, puede indicar que hay diferencias en la configuración del entorno o en el preprocesamiento de los datos que no han sido documentadas adecuadamente.
La definición de los criterios de éxito también determina qué comparación puede hacerse. Si dos ejecuciones producen resultados parecidos pero utilizan métricas distintas o criterios de aceptación diferentes, esa semejanza no demuestra que se haya repetido la misma evaluación. Por eso deben quedar claros tanto el procedimiento como la forma de interpretar su resultado. La transparencia no exige elegir siempre una misma métrica, sino justificar la que corresponde a la tarea y conservar su definición. Así se puede examinar una discrepancia sin atribuirla de inmediato al modelo ni esconderla mediante un cambio del criterio de evaluación.
Errores habituales y límites
Uno de los errores más comunes es la falta de documentación detallada. Muchos investigadores comparten el código final, pero omiten detalles cruciales sobre el preprocesamiento de datos, la selección de hiperparámetros o la configuración del hardware. Esta falta de transparencia impide que otros investigadores reproduzcan el experimento con precisión.
Otro error frecuente es la dependencia de entornos no aislados. Si el experimento se ejecuta en un entorno local sin documentar las versiones de las librerías o la configuración del sistema, es probable que no se pueda reproducir en otra máquina. Además, la no determinación en las operaciones de GPU y la inicialización aleatoria de pesos son fuentes de variabilidad que deben controlarse mediante semillas y algoritmos deterministas.
La falta de documentación detallada es uno de los obstáculos más significativos para la reproducibilidad. Muchos investigadores tienden a compartir solo el código final, omitiendo detalles cruciales sobre cómo se prepararon los datos, qué hiperparámetros se probaron y cómo se seleccionó la configuración óptima. Esta opacidad impide que otros investigadores reproduzcan el experimento con precisión, ya que el código por sí solo no captura la totalidad del proceso experimental. Para superar esta limitación, es recomendable adoptar prácticas de documentación exhaustiva, incluyendo la descripción de cada paso del pipeline de datos, la justificación de las decisiones de diseño y el registro de todos los experimentos realizados, incluso aquellos que no produjeron resultados prometedores.
La dependencia de entornos no aislados es otro error frecuente que compromete la reproducibilidad. Cuando un experimento se ejecuta en un entorno local sin documentar las versiones de las librerías o la configuración del sistema, es probable que no se pueda reproducir en otra máquina debido a diferencias en las dependencias o en el hardware. Además, la no determinación en las operaciones de GPU y la inicialización aleatoria de pesos son fuentes de variabilidad que pueden introducirse de forma inadvertida. Para mitigar estos problemas, es esencial utilizar herramientas de aislamiento de entornos y fijar las semillas aleatorias en todas las librerías que utilicen azar. Esto no elimina por completo la variabilidad, pero la reduce a un nivel manejable, permitiendo una comparación más justa entre diferentes configuraciones experimentales.
Errores comunes y cómo evitarlos
Lista de errores frecuentes y soluciones prácticas.
| Error | Consecuencia | Solución |
|---|---|---|
| Falta de documentación de preprocesamiento | Imposibilidad de reproducir el pipeline de datos. | Documentar cada paso de preprocesamiento y versionar los datos. |
| Entorno no aislado | Variaciones en resultados debido a diferencias de librerías o hardware. | Utilizar Docker o Conda para aislar el entorno y fijar versiones. |
| No fijar semillas aleatorias | Resultados inconsistentes entre ejecuciones. | Fijar semillas en todas las librerías que utilicen azar. |
Preguntas frecuentes y fuentes primarias
¿Es suficiente compartir el código para garantizar la reproducibilidad? No. Compartir el código es un paso necesario, pero no suficiente. Es crucial documentar los datos, la configuración del entorno, los hiperparámetros y el proceso de preprocesamiento. Sin esta información, el código puede no ejecutarse correctamente o producir resultados diferentes.
¿Qué papel juega la aleatoriedad en la reproducibilidad? La aleatoriedad es una fuente de variabilidad que debe controlarse. Fijar las semillas aleatorias y utilizar algoritmos deterministas cuando sea posible ayuda a reducir la variabilidad y mejorar la reproducibilidad. Sin embargo, en algunos casos, como en el entrenamiento de redes neuronales profundas, la no determinación en las operaciones de GPU puede limitar la reproducibilidad exacta.
Compartir el código es un paso necesario, pero no suficiente para garantizar la reproducibilidad. El código es solo una parte del experimento; los datos, la configuración del entorno, los hiperparámetros y el proceso de preprocesamiento son igualmente importantes. Sin esta información completa, el código puede no ejecutarse correctamente o puede producir resultados diferentes a los reportados en el estudio original. Por lo tanto, los autores deben proporcionar un paquete completo de recursos que permita a otros investigadores reproducir el experimento de principio a fin. Esto incluye no solo el código, sino también los datos de entrada, las instrucciones de instalación y ejecución, y una documentación clara de todas las decisiones tomadas durante el proceso experimental.
La aleatoriedad es una fuente de variabilidad inherente a muchos experimentos de aprendizaje automático, y su control es esencial para mejorar la reproducibilidad. Fijar las semillas aleatorias y utilizar algoritmos deterministas cuando sea posible ayuda a reducir la variabilidad y a obtener resultados más consistentes entre ejecuciones. Sin embargo, en algunos casos, como en el entrenamiento de redes neuronales profundas, la no determinación en las operaciones de GPU puede limitar la reproducibilidad exacta. En estos casos, es importante reconocer esta limitación y reportar los resultados como un rango de valores en lugar de un punto único. Esto permite a otros investigadores evaluar si sus propias ejecuciones caen dentro del rango esperado, proporcionando una medida más realista de la reproducibilidad del experimento.