Definición en una frase
Parámetro de muestreo que modifica la distribución de probabilidad usada para seleccionar los siguientes tokens.
Definición técnica: el parámetro de muestreo
En el contexto de los modelos de lenguaje de gran escala (LLM), la temperatura es un parámetro de inferencia que ajusta la distribución de probabilidad de los tokens generados. No es una medida de la 'calidad' intrínseca del modelo ni una variable física, sino un control matemático que determina qué tan aleatoria o determinista será la selección del siguiente token.
Los modelos asignan un valor numérico, conocido como logit, a cada token posible del vocabulario. Estos logits se normalizan mediante una función softmax para crear una distribución de probabilidad donde la suma de todas las probabilidades es uno. La temperatura interviene en este proceso dividiendo los logits por un valor T antes de aplicar la función softmax, modificando así la forma de la distribución final.
Es crucial comprender que la temperatura no altera los pesos internos del modelo ni modifica su capacidad de aprendizaje, sino que opera exclusivamente en la fase de inferencia. Esto significa que el conocimiento almacenado en los parámetros del LLM permanece inalterado, pero la forma en que ese conocimiento se expresa varía drásticamente según este ajuste. Un mismo modelo puede producir una respuesta técnica y precisa con una temperatura baja, o una respuesta especulativa y variada con una temperatura alta, sin que haya ocurrido ningún cambio estructural en su arquitectura o en sus datos de entrenamiento.
La distinción entre el parámetro de muestreo y la calidad intrínseca del modelo es fundamental para evitar malentendidos en la evaluación de sistemas de IA. Atribuir errores de coherencia o falta de precisión a la 'debilidad' del modelo cuando en realidad son consecuencia de una configuración de temperatura inadecuada puede llevar a decisiones incorrectas sobre la selección de herramientas o la necesidad de reentrenamiento. Por el contrario, reconocer la temperatura como una variable de control permite a los ingenieros optimizar el rendimiento para tareas específicas sin recurrir a costosos procesos de ajuste fino, aprovechando la versatilidad inherente de la distribución de probabilidad original.
Mecanismo de acción sobre la distribución
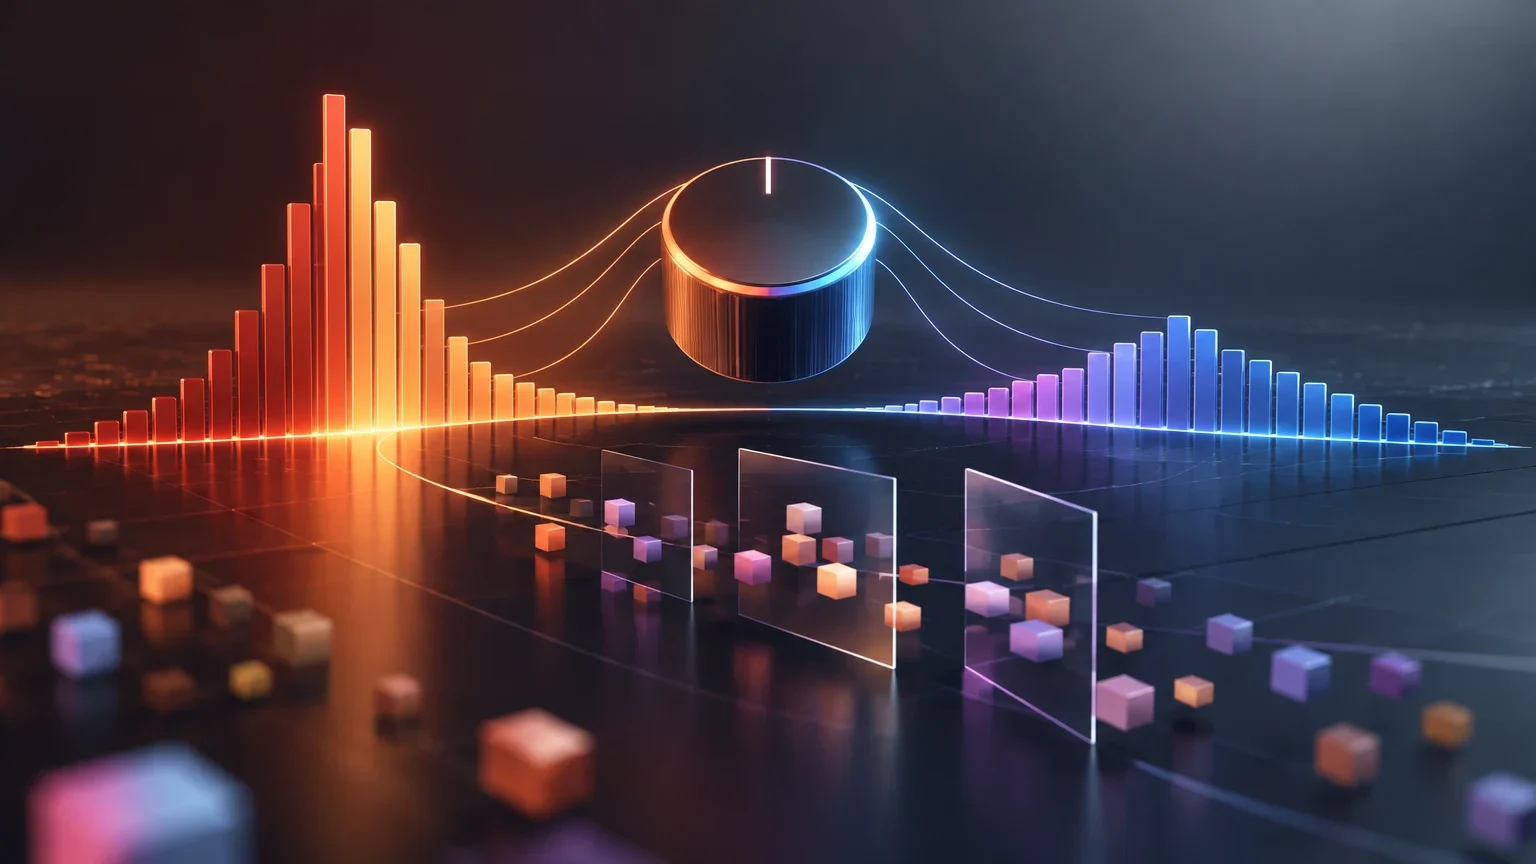
Matemáticamente, la función de softmax con temperatura se expresa como $P(x_i) = \frac{e^{z_i/T}}{\sum_{j} e^{z_j/T}}$, donde $z_i$ es el logit del token $i$ y $T$ es la temperatura. Cuando $T$ tiende a cero, la distribución se vuelve cada vez más picada, favoreciendo casi exclusivamente al token con el logit más alto (decodificación greedy).
A medida que $T$ aumenta, la distribución se aplanan. Esto incrementa la entropía del sistema, permitiendo que tokens con probabilidades iniciales bajas tengan una oportunidad significativa de ser seleccionados. Este mecanismo es fundamental para entender por qué una temperatura alta introduce variabilidad y una temperatura baja promueve la consistencia.
La relación entre la temperatura y la entropía del sistema es inversa en términos de predictibilidad: a mayor temperatura, mayor entropía y, por tanto, mayor incertidumbre en la selección del siguiente token. Este aumento en la entropía no es un defecto, sino una característica explotable para tareas que requieren exploración del espacio de soluciones. Sin embargo, esta misma propiedad implica que la probabilidad de generar tokens incoherentes o gramaticalmente incorrectos aumenta exponencialmente a medida que se aleja el valor de T de la unidad, lo que exige un equilibrio cuidadoso entre la diversidad deseada y la integridad lingüística de la salida.
El comportamiento asintótico de la función softmax cuando la temperatura tiende a cero es un caso límite matemático que, en la práctica, se aproxima a la decodificación greedy. En este escenario, el modelo selecciona siempre el token con el logit máximo, eliminando cualquier componente estocástico. No obstante, esta determinismo absoluto puede resultar en salidas repetitivas o estancadas, especialmente en contextos largos donde el modelo podría entrar en bucles de repetición si no se introducen otros mecanismos de control. Por ello, incluso en tareas que requieren alta precisión, a veces se prefiere una temperatura ligeramente superior a cero para mantener una mínima variabilidad que evite la degeneración del texto.
Efecto de la temperatura en la distribución
Comparación cualitativa del comportamiento de la distribución de probabilidad según el valor de T.
| Valor de T | Comportamiento de la distribución | Resultado esperado |
|---|---|---|
| T ≈ 0 | Distribución muy concentrada (pico agudo) | Salida determinista, repetitiva, alta coherencia local |
| T = 1 | Distribución original del modelo | Equilibrio estándar entre probabilidad y variabilidad |
| T > 1 | Distribución aplanada (alta entropía) | Salida diversa, creativa, mayor riesgo de incoherencia |
Ejemplos aplicados en distintos ámbitos
La elección de la temperatura depende directamente de la tarea. En la generación creativa, como la escritura de guiones o la lluvia de ideas, se suelen emplear valores altos (0.7 a 1.2) para fomentar la novedad y evitar la repetición de patrones predecibles del entrenamiento.
En la extracción de datos estructurados o la generación de código, la precisión es prioritaria. Aquí se utilizan temperaturas muy bajas (0.0 a 0.2) para garantizar que el modelo seleccione siempre la opción más probable, minimizando errores sintácticos o de formato. En la evaluación de benchmarks, se recomienda una temperatura cero o cercana a ella para asegurar la comparabilidad de los resultados entre diferentes modelos o versiones.
La aplicación de temperaturas altas en la generación creativa no garantiza automáticamente una mejora en la calidad artística o narrativa, sino que amplía el espacio de posibilidades desde el cual el modelo puede seleccionar. Esto significa que el usuario o el sistema de post-procesamiento debe asumir un mayor papel en la curaduría de la salida, descartando las opciones menos coherentes o relevantes. La creatividad, en este contexto, no es una propiedad emergente del modelo, sino un resultado de la interacción entre la aleatoriedad controlada por la temperatura y la capacidad del modelo para combinar elementos de forma novedosa dentro de las restricciones gramaticales y semánticas de su entrenamiento.
En el ámbito de la extracción de datos estructurados, la baja temperatura actúa como un mecanismo de validación implícita. Al forzar al modelo a seleccionar siempre la opción más probable, se reduce la probabilidad de alucinaciones o inventos de datos que no están presentes en el texto de entrada. Esto es particularmente crítico en pipelines de automatización donde la salida se consume directamente por otros sistemas sin intervención humana. Un error de formato o una fecha incorrecta, aunque improbable con una temperatura baja, puede tener consecuencias significativas en la integridad de los datos, por lo que la configuración conservativa es una medida de seguridad estándar en estas aplicaciones.
Confusiones frecuentes y conceptos relacionados
Es un error común confundir la temperatura con la 'creatividad' o la 'inteligencia' del modelo. Estudios empíricos, como el de Peeperkorn et al. (2024), indican que la correlación entre temperatura y novedad es débil, mientras que la relación con la incoherencia es moderada. Aumentar la temperatura no hace al modelo más 'inteligente', sino que amplía el rango de tokens considerados.
La temperatura interactúa con otros parámetros de muestreo como top-k y top-p (nucleus sampling). Top-k limita la selección a los k tokens más probables, mientras que top-p selecciona el conjunto más pequeño de tokens cuya probabilidad acumulada supera un umbral (por ejemplo, 0.9). Estos parámetros actúan como filtros que restringen el espacio de búsqueda antes o después de aplicar la transformación de temperatura, permitiendo un control más fino sobre la calidad y la diversidad.
La interacción entre la temperatura y los parámetros de recorte como top-k y top-p es compleja y no es simplemente aditiva. La temperatura modifica la forma de la distribución antes de que se apliquen los filtros de recorte, lo que significa que un cambio en la temperatura puede alterar significativamente el conjunto de tokens que pasan el umbral de top-p. Por ejemplo, una temperatura alta puede 'aplanar' la distribución lo suficiente como para que tokens con probabilidades originalmente muy bajas superen el umbral de top-p, introduciendo una mayor diversidad en la salida. Este efecto combinado permite a los ingenieros ajustar con precisión la frontera entre la coherencia y la novedad, algo que no sería posible utilizando solo uno de los parámetros de forma aislada.
Es importante destacar que la correlación débil entre temperatura y novedad, como se ha señalado en estudios empíricos, sugiere que la creatividad no es un eje lineal controlado por este parámetro. En cambio, la temperatura influye más en la incoherencia y la variabilidad superficial. Esto implica que para tareas que requieren una alta calidad creativa, la temperatura debe ser solo una de las variables a considerar, y debe complementarse con otras técnicas como el muestreo de nucleos o la reescritura por el propio modelo. La idea de que una temperatura alta equivale a una mayor inteligencia o creatividad es un mito que puede llevar a configuraciones subóptimas y a expectativas irreales sobre el rendimiento del modelo.
Límites para la reproducibilidad y evaluación
Aunque una temperatura de cero teóricamente produce una salida determinista (greedy decoding), en la práctica la no determinística puede persistir debido a la paralelización en hardware (GPUs) o a la cuantización de los modelos. Esto significa que incluso con T=0, dos ejecuciones idénticas pueden producir resultados ligeramente diferentes en algunos sistemas de inferencia.
Para equipos de operaciones y científicos de datos, esto implica que la temperatura es una variable crítica en la configuración de inferencia. Cambiar este parámetro altera la métrica de evaluación. No se deben comparar resultados de un modelo con T=0.5 contra otro con T=0.1 sin normalizar este factor, ya que la diferencia en la salida no se debe necesariamente a la capacidad del modelo, sino a la configuración de muestreo.
La no determinística residual en sistemas de inferencia, incluso con una temperatura de cero, es un desafío técnico significativo para la reproducibilidad. Esta variabilidad puede surgir de la forma en que las operaciones de suma y multiplicación se ejecutan en paralelo en las GPUs, donde el orden de las operaciones puede variar entre ejecuciones, o de la cuantización de los pesos del modelo, que introduce errores de redondeo. Estos factores, aunque pequeños, pueden acumularse a lo largo de la generación de un texto largo, resultando en diferencias sutiles pero medibles en la salida final. Para aplicaciones que requieren una consistencia absoluta, como la generación de código o la extracción de datos, es esencial documentar y controlar estos factores de hardware y software.
La implicación práctica de esta no determinística es que la evaluación de modelos debe realizarse con un rigor estadístico adecuado. Comparar dos modelos o dos versiones de un modelo basándose en una única ejecución es metodológicamente inválido, especialmente si la temperatura no está fijada a cero o si el hardware introduce variabilidad. En su lugar, se deben realizar múltiples ejecuciones con la misma configuración y semilla (si está disponible) para obtener una distribución de resultados y comparar las medias o las probabilidades de éxito. Este enfoque permite aislar el efecto real del modelo o de la configuración de muestreo del ruido inherente al proceso de inferencia, proporcionando una base más sólida para la toma de decisiones técnicas.
Proceso para asegurar reproducibilidad
Pasos recomendados para minimizar la variabilidad no deseada en pipelines de producción.
- 01Fijar la temperatura a 0.0 para tareas deterministas.
- 02Verificar si el proveedor de inferencia soporta la fijación de la semilla (seed) para el muestreo.
- 03Documentar la versión exacta del modelo y la configuración de hardware (GPU/CPU) utilizada.
- 04Realizar pruebas A/B con la misma semilla para validar la consistencia de la salida.