Definizione in una frase
Parametro di campionamento che modifica la distribuzione di probabilità usata per selezionare i token successivi.
Definizione tecnica: il parametro di campionamento
Nel contesto dei grandi modelli linguistici (LLM), la temperatura è un parametro di inferenza che regola la distribuzione di probabilità dei token generati. Non è una misura della 'qualità' intrinseca del modello né una variabile fisica, ma un controllo matematico che determina quanto la selezione del prossimo token sarà casuale o deterministica.
I modelli assegnano un valore numerico, noto come logit, a ogni token possibile del vocabolario. Questi logit vengono normalizzati tramite una funzione softmax per creare una distribuzione di probabilità in cui la somma di tutte le probabilità è uno. La temperatura interviene in questo processo dividendo i logit per un valore T prima di applicare la funzione softmax, modificando così la forma della distribuzione finale.
La distinzione tra variabile fisica e controllo matematico è cruciale per comprendere che la temperatura non altera i pesi interni del modello, ma modifica esclusivamente la funzione di attivazione durante la fase di inferenza. Questo significa che la stessa architettura e gli stessi parametri addestrati producono distribuzioni di probabilità diverse a seconda del valore di T, senza che vi sia alcun cambiamento strutturale nella rete neurale sottostante. Tale separazione concettuale evita l'errore di attribuire al modello una capacità intrinseca di variabilità, riconoscendo invece che la diversità dell'output è un artefatto del processo di campionamento applicato ai logit grezzi.
Il ruolo della funzione softmax in questo contesto è quello di garantire che la somma delle probabilità di tutti i token nel vocabolario sia esattamente uno, creando una distribuzione normalizzata. L'intervento della temperatura avviene prima di questa normalizzazione, agendo come un fattore di scala che amplifica o attenua le differenze relative tra i logit. Quando T è diverso da uno, la gerarchia dei token viene ridisegnata: le differenze tra i logit più alti vengono esagerate o ridotte, cambiando così la probabilità relativa di ogni token rispetto agli altri. Questo meccanismo matematico è la base di tutte le variazioni osservabili nel comportamento generativo del modello.
Meccanismo di azione sulla distribuzione
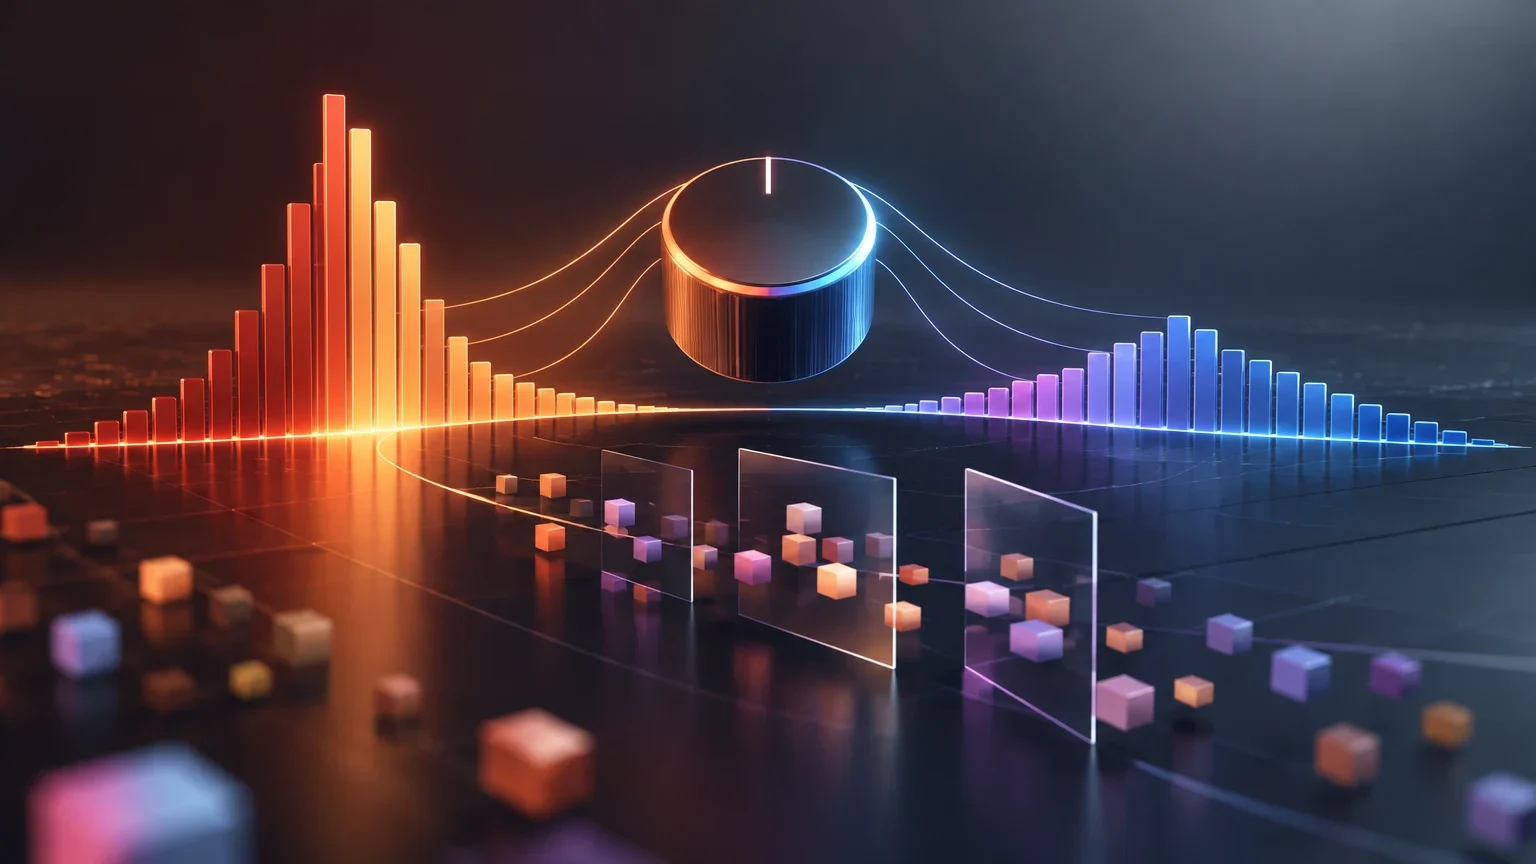
Matematicamente, la funzione softmax con temperatura si esprime come $P(x_i) = \frac{e^{z_i/T}}{\sum_{j} e^{z_j/T}}$, dove $z_i$ è il logit del token $i$ e $T$ è la temperatura. Quando $T$ tende a zero, la distribuzione diventa sempre più appuntita, favorendo quasi esclusivamente il token con il logit più alto (decodifica greedy).
Man mano che $T$ aumenta, la distribuzione si appiattisce. Questo incrementa l'entropia del sistema, permettendo a token con probabilità iniziali basse di avere un'opportunità significativa di essere selezionati. Questo meccanismo è fondamentale per capire perché una temperatura alta introduce variabilità e una temperatura bassa promuove la consistenza.
L'analisi del limite matematico quando T tende a zero rivela che la distribuzione converge verso una funzione delta di Dirac, dove la probabilità si concentra interamente sul token con il logit massimo. In questo scenario, la decodifica diventa deterministica e identica alla selezione greedy, eliminando qualsiasi elemento di casualità. Tuttavia, questo stato ideale è spesso approssimato nella pratica a causa delle limitazioni numeriche dei calcolatori, che non possono rappresentare esattamente lo zero o le esponenziali infinite, portando a una concentrazione estrema ma non assoluta della probabilità sui token principali.
Al contrario, l'aumento di T verso valori superiori a uno provoca un appiattimento progressivo della curva di distribuzione, riducendo la differenza di probabilità tra i token più probabili e quelli meno probabili. Questo incremento dell'entropia del sistema significa che la selezione del token successivo diventa sempre più imprevedibile, poiché anche token con logit bassi iniziano a competere in modo significativo con quelli ad alta probabilità. La transizione da una distribuzione appuntita a una piatta non è lineare, ma esponenziale, il che implica che piccoli aumenti di T in regioni ad alto valore possono avere un impatto sproporzionato sulla diversità dell'output rispetto a variazioni simili in regioni a basso valore.
Effetto della temperatura sulla distribuzione
Confronto qualitativo del comportamento della distribuzione di probabilità in base al valore di T.
| Valore di T | Comportamento della distribuzione | Risultato atteso |
|---|---|---|
| T ≈ 0 | Distribuzione molto concentrata (picco acuto) | Output deterministico, ripetitivo, alta coerenza locale |
| T = 1 | Distribuzione originale del modello | Equilibrio standard tra probabilità e variabilità |
| T > 1 | Distribuzione appiattita (alta entropia) | Output diversificato, creativo, maggiore rischio di incoerenza |
Esempi applicati in diversi ambiti
La scelta della temperatura dipende direttamente dal compito. Nella generazione creativa, come la scrittura di sceneggiature o il brainstorming, si utilizzano spesso valori alti (da 0.7 a 1.2) per favorire la novità ed evitare la ripetizione di pattern prevedibili dell'addestramento.
Nell'estrazione di dati strutturati o nella generazione di codice, la precisione è prioritaria. Qui si utilizzano temperature molto basse (da 0.0 a 0.2) per garantire che il modello selezioni sempre l'opzione più probabile, minimizzando errori sintattici o di formato. Nella valutazione dei benchmark, si raccomanda una temperatura zero o vicina a essa per assicurare la confrontabilità dei risultati tra diversi modelli o versioni.
La selezione della temperatura per la generazione creativa, come la scrittura di sceneggiature, si basa sulla necessità di sfuggire ai pattern statistici dominanti presenti nei dati di addestramento. Valori tra 0.7 e 1.2 servono a rompere la prevedibilità, permettendo al modello di combinare concetti in modi non banali. Tuttavia, questo approccio comporta un rischio intrinseco: la perdita di coerenza logica o fattuale, poiché il modello potrebbe selezionare token che, pur essendo grammaticalmente corretti, non si adattano al contesto semantico globale. La creatività, in questo senso, è un compromesso tra novità e plausibilità, gestito attraverso la regolazione della temperatura.
Nell'estrazione di dati strutturati e nella generazione di codice, la priorità assoluta è la conformità al formato e la correttezza sintattica. Temperature comprese tra 0.0 e 0.2 sono utilizzate per minimizzare la varianza, assicurando che il modello segua rigorosamente le istruzioni di formato, come la struttura JSON o la sintassi di un linguaggio di programmazione. In questi casi, la ripetitività non è un difetto, ma una caratteristica desiderata, poiché garantisce che l'output sia sempre parsabile e utilizzabile da sistemi downstream. La valutazione dei benchmark segue lo stesso principio, richiedendo temperature vicine a zero per isolare la capacità del modello dalla variabilità introdotta dal campionamento, permettendo confronti equi tra diverse versioni o architetture.
Confusioni frequenti e concetti correlati
È un errore comune confondere la temperatura con la 'creatività' o l''intelligenza' del modello. Studi empirici, come quello di Peeperkorn et al. (2024), indicano che la correlazione tra temperatura e novità è debole, mentre la relazione con l'incoerenza è moderata. Aumentare la temperatura non rende il modello più 'intelligente', ma amplia l'intervallo di token considerati.
La temperatura interagisce con altri parametri di campionamento come top-k e top-p (nucleus sampling). Top-k limita la selezione ai k token più probabili, mentre top-p seleziona il sottoinsieme più piccolo di token la cui probabilità cumulativa supera una soglia (ad esempio, 0.9). Questi parametri agiscono come filtri che restringono lo spazio di ricerca prima o dopo l'applicazione della trasformazione della temperatura, consentendo un controllo più fine sulla qualità e sulla diversità.
La confusione tra temperatura e intelligenza o creatività deriva da una semplificazione eccessiva del ruolo di questo parametro. Lo studio di Peeperkorn et al. (2024) chiarisce che aumentare la temperatura non migliora la capacità cognitiva del modello, ma espande semplicemente l'insieme di token considerati per la selezione. La correlazione debole con la novità suggerisce che la creatività non è un prodotto diretto della casualità, ma dipende dalla qualità dei dati di addestramento e dalla struttura del modello. La correlazione moderata con l'incoerenza avverte che temperature elevate possono degradare la qualità logica dell'output, rendendo la temperatura uno strumento di controllo sulla variabilità, non sulla competenza.
L'interazione tra temperatura, top-k e top-p richiede una comprensione sequenziale dei processi di campionamento. Top-k e top-p agiscono come filtri che riducono lo spazio di ricerca prima o dopo la trasformazione della temperatura, limitando la selezione a un sottoinsieme di token. L'ordine di applicazione di questi filtri può influenzare il risultato finale, poiché la temperatura modifica la forma della distribuzione su cui i filtri operano. Un controllo fine sulla qualità e sulla diversità richiede quindi la calibrazione simultanea di questi parametri, riconoscendo che la temperatura da sola non è sufficiente per gestire la complessità del campionamento in scenari applicativi avanzati.
Limiti per la riproducibilità e la valutazione
Sebbene una temperatura di zero produca teoricamente un output deterministico (decodifica greedy), nella pratica la non deterministica può persistere a causa della parallelizzazione sull'hardware (GPU) o della quantizzazione dei modelli. Questo significa che anche con T=0, due esecuzioni identiche possono produrre risultati leggermente diversi in alcuni sistemi di inferenza.
Per i team operativi e i data scientist, questo implica che la temperatura è una variabile critica nella configurazione di inferenza. Cambiare questo parametro altera la metrica di valutazione. Non si devono confrontare i risultati di un modello con T=0.5 contro un altro con T=0.1 senza normalizzare questo fattore, poiché la differenza nell'output non è necessariamente dovuta alla capacità del modello, ma alla configurazione di campionamento.
La persistenza della non deterministica anche con T=0 è un fenomeno legato all'architettura hardware e alle ottimizzazioni software dei sistemi di inferenza. La parallelizzazione delle operazioni matriciali sulle GPU può introdurre variazioni nell'ordine di esecuzione dei calcoli, mentre la quantizzazione dei pesi del modello può amplificare piccoli errori di arrotondamento. Queste fonti di variabilità rendono impossibile garantire un'identità bit-per-bit tra esecuzioni identiche, anche quando la temperatura è impostata a zero. Per i team operativi, questo implica che la riproducibilità assoluta è un obiettivo ideale, ma nella pratica si deve accettare un certo grado di varianza residua, documentando le condizioni hardware e software per garantire la tracciabilità dei risultati.
La temperatura è una variabile critica nella configurazione di inferenza perché altera direttamente la metrica di valutazione. Confrontare risultati ottenuti con temperature diverse senza normalizzare questo fattore porta a conclusioni errate sulle capacità del modello, poiché le differenze nell'output riflettono la configurazione di campionamento piuttosto che la qualità intrinseca del modello. Per garantire la riproducibilità, è essenziale fissare la temperatura a 0.0 per i task deterministici, verificare il supporto per la fissazione del seed, documentare la versione del modello e l'hardware utilizzato, e eseguire test A/B con lo stesso seed per validare la consistenza. Questo processo di validazione è fondamentale per distinguere tra variazioni dovute al modello e quelle dovute al campionamento, assicurando l'affidabilità dei risultati in pipeline di produzione.
Processo per garantire la riproducibilità
Passi raccomandati per minimizzare la variabilità indesiderata nei pipeline di produzione.
- 01Impostare la temperatura a 0.0 per i task deterministici.
- 02Verificare se il provider di inferenza supporta la fissazione del seed per il campionamento.
- 03Documentare la versione esatta del modello e la configurazione hardware (GPU/CPU) utilizzata.
- 04Eseguire test A/B con lo stesso seed per validare la consistenza dell'output.