Definition in einem Satz
Abtastparameter, der die Wahrscheinlichkeitsverteilung modifiziert, die zur Auswahl der nächsten Tokens verwendet wird.
Technische Definition: Der Sampling-Parameter
Im Kontext großer Sprachmodelle (LLMs) ist die Temperatur ein Inferenzparameter, der die Wahrscheinlichkeitsverteilung der generierten Tokens anpasst. Sie ist weder ein Maß für die inhärente 'Qualität' des Modells noch eine physikalische Variable, sondern eine mathematische Steuerung, die bestimmt, wie zufällig oder deterministisch die Auswahl des nächsten Tokens sein wird.
Die Modelle weisen jedem möglichen Token des Vokabulars einen numerischen Wert zu, der als Logit bekannt ist. Diese Logits werden durch eine Softmax-Funktion normalisiert, um eine Wahrscheinlichkeitsverteilung zu erstellen, in der die Summe aller Wahrscheinlichkeiten eins beträgt. Die Temperatur greift in diesen Prozess ein, indem die Logits vor der Anwendung der Softmax-Funktion durch einen Wert T geteilt werden, wodurch die Form der endgültigen Verteilung verändert wird.
Die mathematische Natur dieses Parameters lässt sich als eine Art Skalierungsfaktor für die internen Konfidenzwerte des Modells verstehen. Indem die Logits durch die Temperatur geteilt werden, wird die relative Differenz zwischen den Wahrscheinlichkeiten der einzelnen Tokens entweder vergrößert oder verkleinert. Bei einer Temperatur kleiner als eins werden die Unterschiede zwischen den Logits überproportional vergrößert, was dazu führt, dass das Token mit der höchsten Wahrscheinlichkeit eine nahezu dominante Position in der Verteilung einnimmt. Dieser Effekt ist besonders relevant, wenn das Modell in Situationen mit hoher Ambiguität operiert, da er die Wahrscheinlichkeit minimiert, dass ein weniger wahrscheinliches, aber möglicherweise kontextuell passendes Token ausgewählt wird. Umgekehrt führt eine Temperatur größer als eins dazu, dass die Unterschiede zwischen den Logits relativiert werden, was die Wahrscheinlichkeitsmasse auf eine breitere Palette von Tokens verteilt und so die Entropie des Systems erhöht.
Wirkungsmechanismus auf die Verteilung
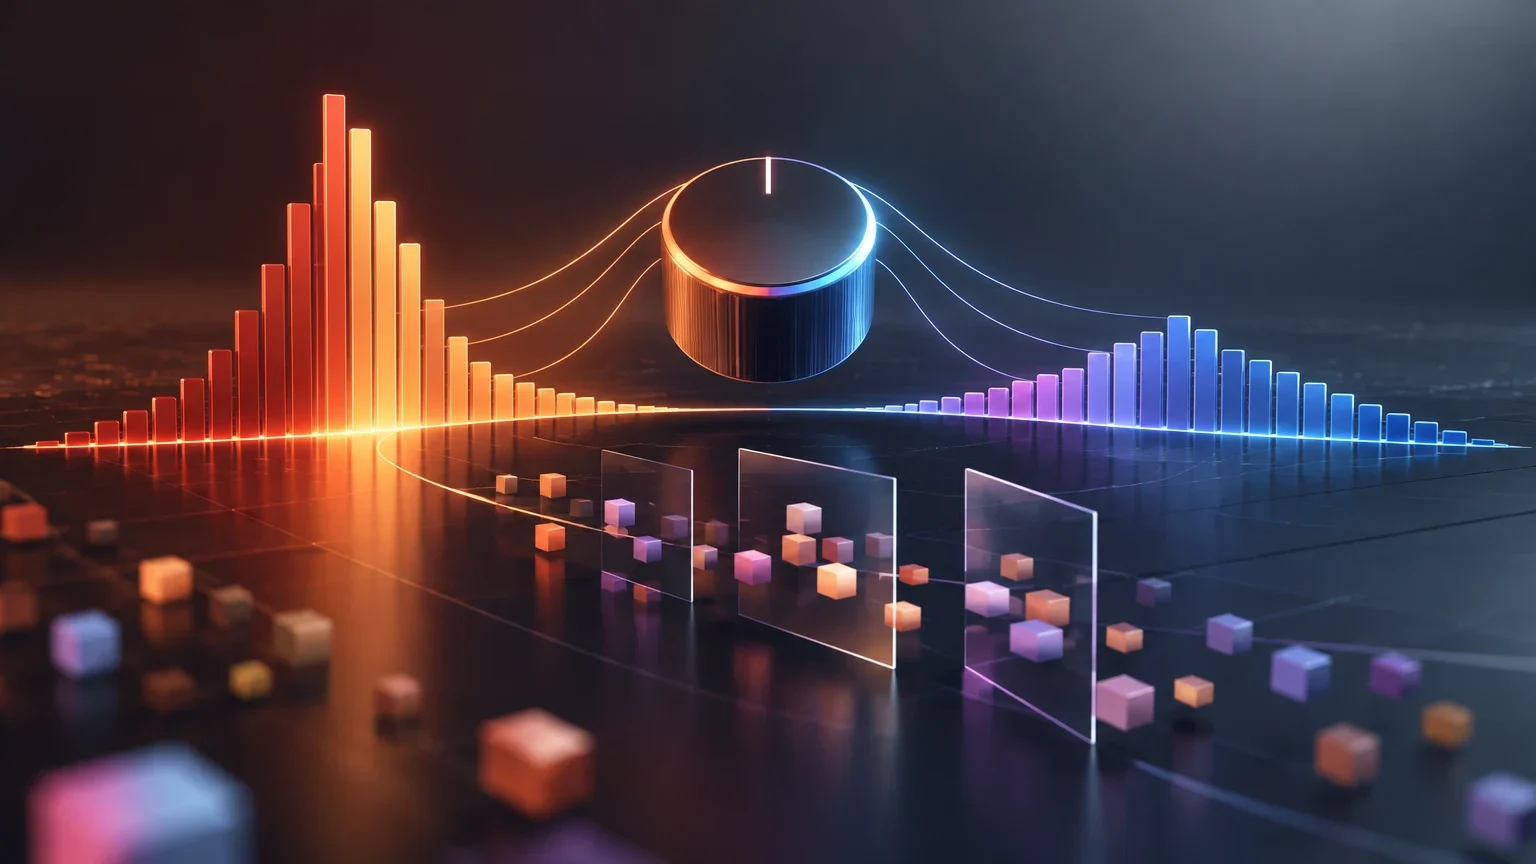
Mathematisch lässt sich die Softmax-Funktion mit Temperatur als $P(x_i) = \frac{e^{z_i/T}}{\sum_{j} e^{z_j/T}}$ ausdrücken, wobei $z_i$ das Logit des Tokens $i$ und $T$ die Temperatur ist. Wenn $T$ gegen null geht, wird die Verteilung immer spitzer und begünstigt fast ausschließlich das Token mit dem höchsten Logit (Greedy-Decoding).
Mit steigendem $T$ wird die Verteilung flacher. Dies erhöht die Entropie des Systems und ermöglicht es Tokens mit anfänglich niedriger Wahrscheinlichkeit, eine signifikante Chance auf Auswahl zu haben. Dieser Mechanismus ist fundamental, um zu verstehen, warum eine hohe Temperatur Variabilität einführt und eine niedrige Temperatur Konsistenz fördert.
Das Verständnis der Entropie in diesem Zusammenhang ist entscheidend, da sie ein Maß für die Unsicherheit oder die Unvorhersehbarkeit der Token-Auswahl darstellt. Eine niedrige Entropie, die durch niedrige Temperaturen erzeugt wird, korreliert stark mit einer hohen lokalen Kohärenz, da das Modell tendenziell die statistisch wahrscheinlichsten Fortsetzungen wählt, die im Trainingsdatensatz am häufigsten vorkommen. Dies kann jedoch zu einer gewissen Stagnation in der Generierung führen, da das Modell in lokalen Optima gefangen bleibt und selten von den etablierten Mustern abweicht. Eine hohe Entropie, die durch hohe Temperaturen gefördert wird, bricht diese lokalen Optima auf, indem sie dem Modell erlaubt, seltener vorkommende, aber potenziell kreativer oder überraschender Token-Sequenzen zu erkunden. Dieser Mechanismus ist der Grund, warum hohe Temperaturen in kreativen Aufgaben bevorzugt werden, da sie die Wahrscheinlichkeit erhöhen, dass das Modell über die oberflächlichen statistischen Korrelationen des Trainingsdatensatzes hinausgeht und neuartige Kombinationen von Konzepten erzeugt.
Auswirkung der Temperatur auf die Verteilung
Qualitativer Vergleich des Verhaltens der Wahrscheinlichkeitsverteilung je nach Wert von T.
| Wert von T | Verhalten der Verteilung | Erwartetes Ergebnis |
|---|---|---|
| T ≈ 0 | Sehr konzentrierte Verteilung (scharfer Peak) | Deterministische, repetitive Ausgabe, hohe lokale Kohärenz |
| T = 1 | Originalverteilung des Modells | Standardgleichgewicht zwischen Wahrscheinlichkeit und Variabilität |
| T > 1 | Abgeflachte Verteilung (hohe Entropie) | Vielfältige, kreative Ausgabe, höheres Risiko für Inkohärenz |
Angewandte Beispiele in verschiedenen Bereichen
Die Wahl der Temperatur hängt direkt von der Aufgabe ab. Bei der kreativen Generierung, wie dem Schreiben von Drehbüchern oder Brainstorming, werden oft hohe Werte (0,7 bis 1,2) verwendet, um Neuheit zu fördern und die Wiederholung vorhersehbarer Trainingsmuster zu vermeiden.
Bei der Extraktion strukturierter Daten oder der Codegenerierung hat die Präzision Vorrang. Hier werden sehr niedrige Temperaturen (0,0 bis 0,2) verwendet, um sicherzustellen, dass das Modell immer die wahrscheinlichste Option auswählt und syntaktische oder Formatierungsfehler minimiert. Bei der Bewertung von Benchmarks wird eine Temperatur von null oder nahe null empfohlen, um die Vergleichbarkeit der Ergebnisse zwischen verschiedenen Modellen oder Versionen sicherzustellen.
Die Anwendung der Temperatur in der kreativen Generierung erfordert ein feines Abwägen zwischen Neuheit und Kohärenz. Während hohe Werte wie 1,2 die Wahrscheinlichkeit erhöhen, dass das Modell ungewöhnliche Wortkombinationen oder narrative Wendungen vorschlägt, steigt gleichzeitig das Risiko, dass die generierten Texte semantisch inkohärent oder logisch widersprüchlich werden. Dies liegt daran, dass das Modell bei hoher Temperatur auch Tokens mit sehr niedriger Wahrscheinlichkeit in Betracht zieht, die im Kontext der vorherigen Tokens möglicherweise nicht sinnvoll sind. Daher ist es in kreativen Aufgaben oft notwendig, die Temperatur iterativ anzupassen, um einen Sweet Spot zu finden, in dem die Generierung ausreichend vielfältig ist, um interessant zu wirken, aber dennoch innerhalb der Grenzen der sprachlichen und thematischen Kohärenz bleibt. Dieser Prozess der Feinabstimmung ist besonders wichtig, wenn die generierten Inhalte für menschliche Leser bestimmt sind, da diese eine gewisse Erwartung an die logische Struktur und die sprachliche Qualität haben.
Häufige Verwechslungen und verwandte Konzepte
Es ist ein häufiger Fehler, die Temperatur mit der 'Kreativität' oder der 'Intelligenz' des Modells zu verwechseln. Empirische Studien, wie die von Peeperkorn et al. (2024), zeigen, dass die Korrelation zwischen Temperatur und Neuheit schwach ist, während der Zusammenhang mit Inkohärenz moderat ist. Eine Erhöhung der Temperatur macht das Modell nicht 'intelligenter', sondern erweitert lediglich den Bereich der berücksichtigten Tokens.
Die Temperatur interagiert mit anderen Sampling-Parametern wie Top-k und Top-p (Nucleus Sampling). Top-k beschränkt die Auswahl auf die k wahrscheinlichsten Tokens, während Top-p die kleinste Menge von Tokens auswählt, deren kumulative Wahrscheinlichkeit einen Schwellenwert (z. B. 0,9) überschreitet. Diese Parameter wirken als Filter, die den Suchraum vor oder nach der Anwendung der Temperaturtransformation einschränken und so eine feinere Kontrolle über Qualität und Vielfalt ermöglichen.
Die Interaktion zwischen Temperatur und Top-p (Nucleus Sampling) ist besonders komplex, da beide Parameter auf unterschiedlichen Ebenen der Wahrscheinlichkeitsverteilung wirken. Während die Temperatur die Form der gesamten Verteilung verändert, indem sie die Logits skaliert, schneidet Top-p die Verteilung ab, indem es nur die Tokens berücksichtigt, deren kumulative Wahrscheinlichkeit einen bestimmten Schwellenwert überschreitet. Dies bedeutet, dass eine hohe Temperatur in Kombination mit einem niedrigen Top-p-Wert zu einem paradoxen Effekt führen kann: Die Temperatur erhöht die Wahrscheinlichkeit seltener Tokens, aber Top-p schneidet diese Tokens ab, wenn ihre kumulative Wahrscheinlichkeit unter dem Schwellenwert liegt. Umgekehrt kann eine niedrige Temperatur in Kombination mit einem hohen Top-p-Wert dazu führen, dass die Verteilung so konzentriert ist, dass nur sehr wenige Tokens den Schwellenwert überschreiten, was die Variabilität der Ausgabe stark einschränkt. Daher ist es wichtig, diese Parameter gemeinsam zu optimieren, um die gewünschte Balance zwischen Qualität und Vielfalt zu erreichen.
Grenzen für Reproduzierbarkeit und Evaluation
Obwohl eine Temperatur von null theoretisch eine deterministische Ausgabe (Greedy-Decoding) erzeugt, kann die Nicht-Determinismus in der Praxis aufgrund der Parallelisierung auf der Hardware (GPUs) oder der Quantisierung der Modelle bestehen bleiben. Das bedeutet, dass selbst bei T=0 zwei identische Ausführungen in einigen Inferenzsystemen leicht unterschiedliche Ergebnisse produzieren können.
Für Betriebsteams und Data Scientists bedeutet dies, dass die Temperatur eine kritische Variable in der Inferenzkonfiguration ist. Die Änderung dieses Parameters verändert die Bewertungsmetrik. Ergebnisse eines Modells mit T=0,5 dürfen nicht mit denen eines anderen Modells mit T=0,1 verglichen werden, ohne diesen Faktor zu normalisieren, da der Unterschied in der Ausgabe nicht unbedingt auf die Fähigkeit des Modells zurückzuführen ist, sondern auf die Sampling-Konfiguration.
Die Herausforderung der Reproduzierbarkeit bei T=0 wird durch die Art und Weise, wie moderne Inferenzsysteme die Berechnungen parallelisieren, noch verschärft. GPUs führen Berechnungen in Batches durch, und die Reihenfolge, in der diese Batches verarbeitet werden, kann aufgrund von Floating-Point-Arithmetik zu minimalen Unterschieden in den Ergebnissen führen. Diese Unterschiede sind zwar oft vernachlässigbar, können aber in sensiblen Anwendungen, wie der automatisierten Entscheidungsfindung oder der wissenschaftlichen Analyse, zu signifikanten Abweichungen führen. Daher ist es für Teams, die auf Reproduzierbarkeit angewiesen sind, entscheidend, nicht nur die Temperatur, sondern auch die Hardware-Konfiguration und die Software-Version des Inferenzproviders zu dokumentieren. Zusätzlich kann die Verwendung von deterministischen Algorithmen, wo verfügbar, helfen, diese Nicht-Determinismen zu minimieren, obwohl dies oft mit einem Leistungseinbußen verbunden ist. Die Dokumentation dieser Faktoren ist ein wesentlicher Bestandteil der guten Praxis in der Entwicklung und Bewertung von LLM-Anwendungen.
Prozess zur Sicherstellung der Reproduzierbarkeit
Empfohlene Schritte zur Minimierung unerwünschter Variabilität in Produktions-Pipelines.
- 01Die Temperatur für deterministische Aufgaben auf 0,0 festlegen.
- 02Prüfen, ob der Inferenzanbieter das Festlegen eines Seeds für das Sampling unterstützt.
- 03Die exakte Modellversion und die verwendete Hardware-Konfiguration (GPU/CPU) dokumentieren.
- 04A/B-Tests mit demselben Seed durchführen, um die Konsistenz der Ausgabe zu validieren.