Definição numa frase
Parâmetro de amostragem que modifica a distribuição de probabilidade usada para selecionar os seguintes tokens.
Definição técnica: o parâmetro de amostragem
No contexto dos grandes modelos de linguagem (LLMs), a temperatura é um parâmetro de inferência que ajusta a distribuição de probabilidade dos tokens gerados. Não é uma medida da 'qualidade' intrínseca do modelo nem uma variável física, mas um controle matemático que determina o quão aleatória ou determinística será a seleção do próximo token.
Os modelos atribuem um valor numérico, conhecido como logit, a cada token possível do vocabulário. Esses logits são normalizados por meio de uma função softmax para criar uma distribuição de probabilidade onde a soma de todas as probabilidades é um. A temperatura intervém neste processo dividindo os logits por um valor T antes de aplicar a função softmax, modificando assim a forma da distribuição final.
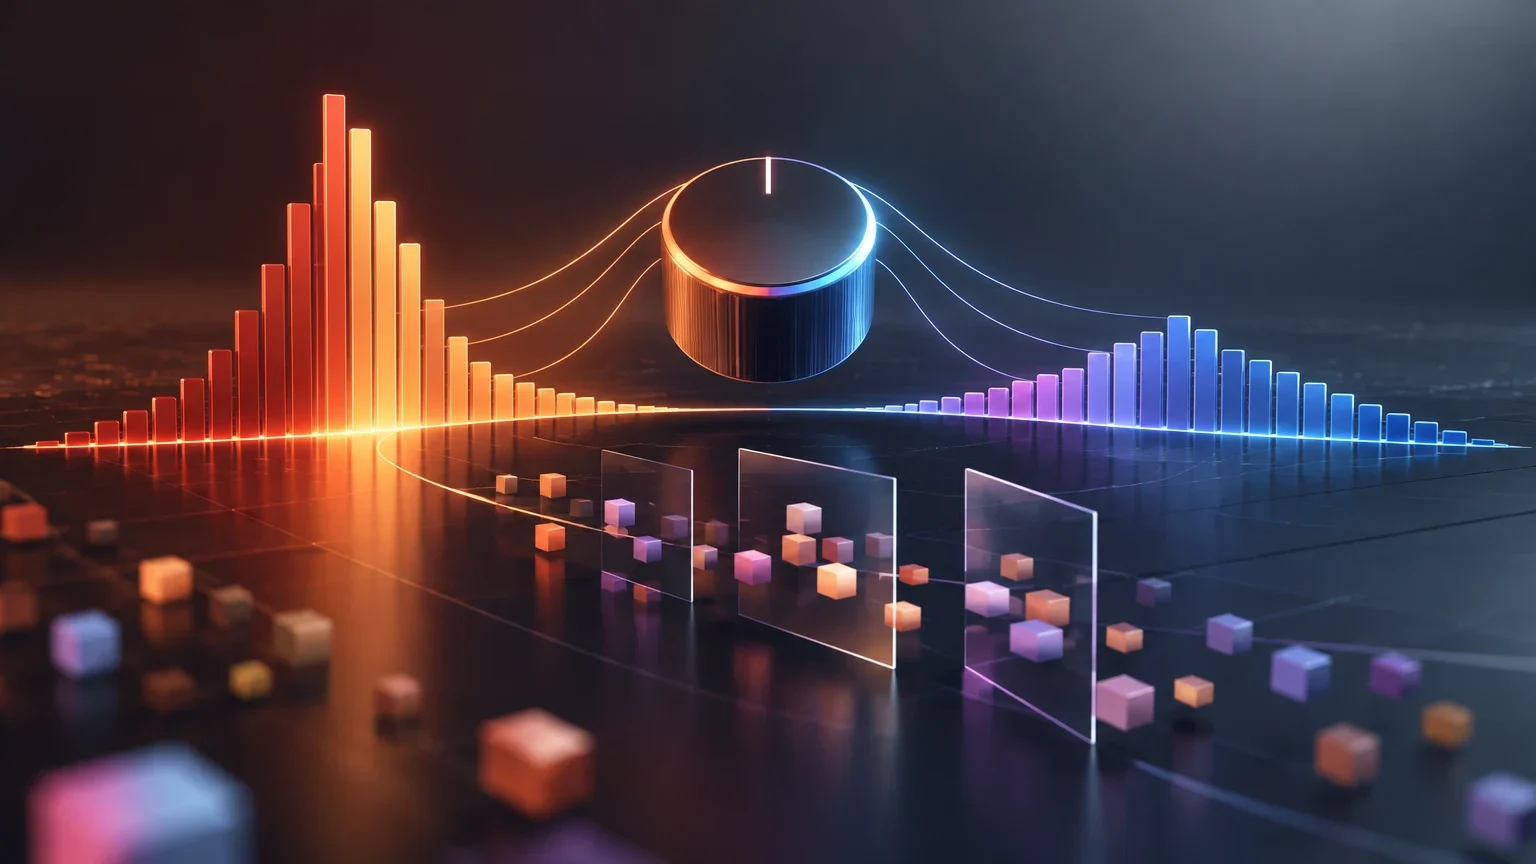
A natureza matemática desse controle reside no fato de que a temperatura não altera a ordem de probabilidade dos tokens, mas sim a magnitude das diferenças entre eles. Quando o valor de T é inferior a um, as diferenças entre os logits são amplificadas, tornando a distribuição mais 'ponta' e reduzindo drasticamente a chance de seleção de tokens menos prováveis. Por outro lado, valores superiores a um atenuam essas diferenças, suavizando a curva de probabilidade e permitindo que a incerteza inerente ao modelo se manifeste de forma mais ampla na saída final.
É crucial compreender que este parâmetro opera exclusivamente no momento da inferência, não afetando os pesos do modelo treinado. Isso significa que a mesma arquitetura de rede neural pode produzir saídas radicalmente diferentes dependendo apenas da configuração de temperatura escolhida pelo usuário ou pelo sistema de orquestração. Essa separação entre o conhecimento armazenado nos pesos e a estratégia de amostragem permite uma flexibilidade operacional significativa, onde o mesmo modelo pode ser ajustado para comportamentos distintos sem a necessidade de retreinamento ou fine-tuning adicional.
Mecanismo de ação sobre a distribuição
Matematicamente, a função de softmax com temperatura é expressa como $P(x_i) = \frac{e^{z_i/T}}{\sum_{j} e^{z_j/T}}$, onde $z_i$ é o logit do token $i$ e $T$ é a temperatura. Quando $T$ tende a zero, a distribuição torna-se cada vez mais aguda, favorecendo quase exclusivamente o token com o logit mais alto (decodificação greedy).
À medida que $T$ aumenta, a distribuição se aplaina. Isso incrementa a entropia do sistema, permitindo que tokens com probabilidades iniciais baixas tenham uma oportunidade significativa de serem selecionados. Este mecanismo é fundamental para entender por que uma temperatura alta introduz variabilidade e uma temperatura baixa promove a consistência.
A relação entre a temperatura e a entropia do sistema é direta e fundamental para a compreensão do comportamento do modelo. A entropia, medida em bits ou nats, quantifica a incerteza ou a aleatoriedade da distribuição de probabilidade. Ao aumentar a temperatura, o denominador da função softmax se torna mais sensível a todos os logits, resultando em uma distribuição mais plana e, consequentemente, em uma entropia maior. Isso implica que o modelo está 'apostando' em um leque mais amplo de possibilidades, o que é desejável em tarefas que valorizam a diversidade, mas problemático em contextos que exigem precisão factual.
O limite teórico quando a temperatura se aproxima de zero é particularmente interessante do ponto de vista computacional. Nesse cenário, a função softmax converge para uma função 'one-hot', onde apenas o token com o logit máximo recebe probabilidade um, e todos os outros recebem zero. Embora isso elimine a aleatoriedade na seleção, a implementação prática em hardware de ponto flutuante pode introduzir erros de arredondamento mínimos que, em casos extremos, podem levar a pequenas variações na saída, mesmo quando a intenção é uma decodificação estritamente determinística.
Efeito da temperatura na distribuição
Comparação qualitativa do comportamento da distribuição de probabilidade segundo o valor de T.
| Valor de T | Comportamento da distribuição | Resultado esperado |
|---|---|---|
| T ≈ 0 | Distribuição muito concentrada (pico agudo) | Saída determinística, repetitiva, alta coerência local |
| T = 1 | Distribuição original do modelo | Equilíbrio padrão entre probabilidade e variabilidade |
| T > 1 | Distribuição aplainada (alta entropia) | Saída diversa, criativa, maior risco de incoerência |
Exemplos aplicados em diferentes domínios
A escolha da temperatura depende diretamente da tarefa. Na geração criativa, como a escrita de roteiros ou a tempestade de ideias, costumam-se empregar valores altos (0.7 a 1.2) para fomentar a novidade e evitar a repetição de padrões previsíveis do treinamento.
Na extração de dados estruturados ou na geração de código, a precisão é prioritária. Aqui utilizam-se temperaturas muito baixas (0.0 a 0.2) para garantir que o modelo selecione sempre a opção mais provável, minimizando erros sintáticos ou de formato. Na avaliação de benchmarks, recomenda-se uma temperatura zero ou próxima dela para assegurar a comparabilidade dos resultados entre diferentes modelos ou versões.
A aplicação da temperatura em tarefas de extração de dados estruturados exige uma atenção especial à robustez do formato de saída. Em cenários onde o modelo deve gerar JSON ou XML, uma temperatura baixa não apenas garante a seleção dos tokens mais prováveis, mas também reduz a probabilidade de que o modelo 'alucine' chaves inexistentes ou quebre a sintaxe necessária para a validação posterior. A consistência do formato é tão crítica quanto a precisão dos dados extraídos, pois um erro de sintaxe pode invalidar toda a resposta, independentemente da correção semântica do conteúdo.
Por outro lado, na geração criativa, a temperatura atua como um mecanismo de exploração do espaço latente do modelo. Valores moderadamente altos permitem que o modelo escape de padrões linguísticos frequentes nos dados de treinamento, que tendem a ser genéricos ou clichês. Ao aumentar a aleatoriedade, o modelo é forçado a combinar tokens de maneiras menos comuns, o que pode resultar em metáforas mais originais ou estruturas narrativas inesperadas. No entanto, esse benefício vem acompanhado de um risco proporcional de perda de coerência lógica ou factual, exigindo um equilíbrio cuidadoso entre novidade e plausibilidade.
Confusões frequentes e conceitos relacionados
É um erro comum confundir a temperatura com a 'criatividade' ou a 'inteligência' do modelo. Estudos empíricos, como o de Peeperkorn et al. (2024), indicam que a correlação entre temperatura e novidade é fraca, enquanto a relação com a incoerência é moderada. Aumentar a temperatura não torna o modelo mais 'inteligente', mas amplia o intervalo de tokens considerados.
A temperatura interage com outros parâmetros de amostragem como top-k e top-p (nucleus sampling). Top-k limita a seleção aos k tokens mais prováveis, enquanto top-p seleciona o conjunto mais pequeno de tokens cuja probabilidade acumulada supera um limiar (por exemplo, 0.9). Esses parâmetros atuam como filtros que restringem o espaço de busca antes ou depois de aplicar a transformação de temperatura, permitindo um controle mais fino sobre a qualidade e a diversidade.
A interação entre a temperatura e os parâmetros de filtragem como top-k e top-p é sinérgica e não redundante. Enquanto a temperatura modifica a forma global da distribuição, os filtros de núcleo (top-p) ou de ranking (top-k) restringem o conjunto de candidatos elegíveis para a amostragem. A ordem de aplicação desses parâmetros pode influenciar sutilmente o resultado final, embora a prática padrão seja aplicar a transformação de temperatura primeiro, seguida pela filtragem. Essa sequência garante que a distribuição seja suavizada ou aguçada antes de que os tokens de baixa probabilidade sejam descartados, otimizando o controle sobre a diversidade da saída.
É importante destacar que a combinação desses parâmetros permite um controle granular que a temperatura sozinha não oferece. Por exemplo, uma temperatura alta com um top-p baixo pode resultar em uma saída diversa, mas restrita a um subconjunto de tokens de alta probabilidade, evitando a inclusão de tokens absurdos ou fora de contexto. Essa abordagem híbrida é frequentemente utilizada em sistemas de produção para equilibrar a criatividade com a segurança e a relevância, garantindo que a saída permaneça dentro de limites aceitáveis de qualidade e coerência.
Limites para a reprodutibilidade e avaliação
Embora uma temperatura de zero teoricamente produza uma saída determinística (decodificação greedy), na prática a não determinística pode persistir devido à paralelização em hardware (GPUs) ou à quantização dos modelos. Isso significa que mesmo com T=0, duas execuções idênticas podem produzir resultados ligeiramente diferentes em alguns sistemas de inferência.
Para equipes de operações e cientistas de dados, isso implica que a temperatura é uma variável crítica na configuração de inferência. Alterar este parâmetro altera a métrica de avaliação. Não se devem comparar resultados de um modelo com T=0.5 contra outro com T=0.1 sem normalizar este fator, pois a diferença na saída não se deve necessariamente à capacidade do modelo, mas à configuração de amostragem.
A não determinística residual em sistemas de inferência é um desafio significativo para a reprodutibilidade científica e a consistência operacional. Mesmo com a temperatura fixada em zero, a paralelização das operações matriciais em GPUs pode levar a pequenas diferenças na ordem de soma dos valores, resultando em variações mínimas nos logits finais. Essas variações, embora imperceptíveis em muitos casos, podem ser amplificadas em sequências longas de geração, levando a desvios significativos na saída final. Portanto, a suposição de que T=0 garante uma saída idêntica em todas as execuções é uma simplificação que pode ser perigosa em contextos de alta precisão.
Para mitigar esses efeitos, é recomendável a implementação de testes de consistência rigorosos, incluindo a execução de múltiplas iterações com a mesma semente e a comparação das saídas geradas. Além disso, a documentação detalhada da configuração de hardware e software é essencial para permitir a replicação exata dos resultados em outros ambientes. A falta de padronização nos provedores de inferência em relação ao suporte a sementes e à determinística exige que as equipes de dados desenvolvam protocolos internos de validação para garantir que as variações observadas sejam atribuídas corretamente à configuração de amostragem e não a artefatos de hardware ou software.
Processo para assegurar reprodutibilidade
Passos recomendados para minimizar a variabilidade indesejada em pipelines de produção.
- 01Fixar a temperatura em 0.0 para tarefas determinísticas.
- 02Verificar se o provedor de inferência suporta a fixação da semente (seed) para a amostragem.
- 03Documentar a versão exata do modelo e a configuração de hardware (GPU/CPU) utilizada.
- 04Realizar testes A/B com a mesma semente para validar a consistência da saída.