Définition en une phrase
Paramètre d'échantillonnage qui modifie la distribution de probabilité utilisée pour sélectionner les jetons suivants.
Définition technique : le paramètre d'échantillonnage
Dans le contexte des grands modèles de langage (LLM), la température est un paramètre d'inférence qui ajuste la distribution de probabilité des tokens générés. Ce n'est ni une mesure de la « qualité » intrinsèque du modèle ni une variable physique, mais un contrôle mathématique qui détermine le degré d'aléatoire ou de déterminisme de la sélection du prochain token.
Les modèles attribuent une valeur numérique, appelée logit, à chaque token possible du vocabulaire. Ces logits sont normalisés par une fonction softmax pour créer une distribution de probabilité où la somme de toutes les probabilités est égale à un. La température intervient dans ce processus en divisant les logits par une valeur T avant l'application de la fonction softmax, modifiant ainsi la forme de la distribution finale.
Ce paramètre ne modifie pas les poids internes du modèle ni sa capacité de représentation, mais agit uniquement sur la couche de décodage lors de l'inférence. Il s'agit d'un levier opérationnel qui permet d'adapter le comportement du système à des exigences spécifiques sans nécessiter de réentraînement coûteux. Cette distinction est cruciale pour comprendre que la température est une variable de configuration dynamique, distincte des hyperparamètres d'entraînement qui définissent la structure et la connaissance du modèle.
La nature mathématique de cette opération implique que la température agit comme un facteur d'échelle sur les logits bruts. En divisant chaque logit par T, on amplifie ou atténue les différences relatives entre les scores des tokens candidats. Cette manipulation pré-softmax est ce qui permet de transformer une distribution potentiellement très plate ou très pointue en une forme qui correspond aux besoins de la tâche, offrant ainsi un contrôle précis sur la probabilité attribuée à chaque élément du vocabulaire.
Mécanisme d'action sur la distribution
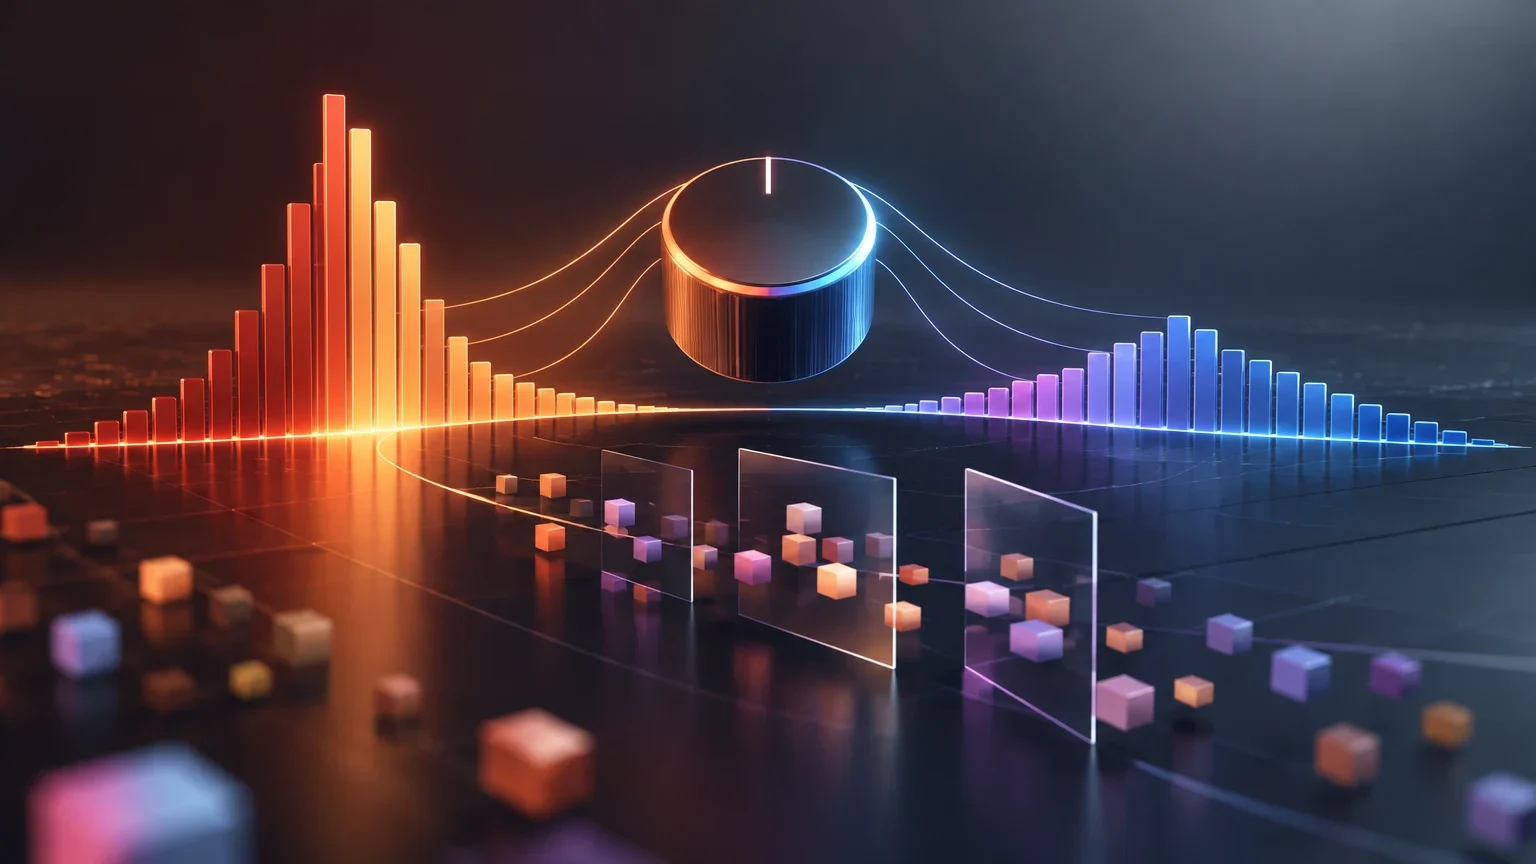
Mathématiquement, la fonction softmax avec température s'exprime comme $P(x_i) = \frac{e^{z_i/T}}{\sum_{j} e^{z_j/T}}$, où $z_i$ est le logit du token $i$ et $T$ est la température. Lorsque $T$ tend vers zéro, la distribution devient de plus en plus pointue, favorisant quasi exclusivement le token ayant le logit le plus élevé (décodage glouton).
À mesure que $T$ augmente, la distribution s'aplatit. Cela augmente l'entropie du système, permettant aux tokens ayant des probabilités initiales faibles d'avoir une chance significative d'être sélectionnés. Ce mécanisme est fondamental pour comprendre pourquoi une température élevée introduit de la variabilité et une température basse favorise la cohérence.
L'impact de la température sur l'entropie du système peut être visualisé comme un lissage progressif de la courbe de probabilité. Lorsque la valeur de T est inférieure à un, les écarts entre les logits sont exagérés, ce qui renforce la dominance du token le plus probable et réduit drastiquement la diversité des sorties possibles. Ce régime est particulièrement adapté aux contextes où la précision syntaxique ou la conformité à un format strict est une exigence non négociable.
Contrairement, une température supérieure à un comprime les différences entre les logits, rendant la distribution plus uniforme et augmentant la probabilité de sélection pour des tokens initialement peu favorisés. Ce mécanisme favorise l'exploration de l'espace des solutions, ce qui est bénéfique pour la créativité mais augmente le risque de produire des incohérences factuelles ou des déviations par rapport au contexte initial. L'équilibre optimal dépend donc directement de la tolérance au risque d'erreur inhérent à la tâche spécifique.
Effet de la température sur la distribution
Comparaison qualitative du comportement de la distribution de probabilité selon la valeur de T.
| Valeur de T | Comportement de la distribution | Résultat attendu |
|---|---|---|
| T ≈ 0 | Distribution très concentrée (pic aigu) | Sortie déterministe, répétitive, forte cohérence locale |
| T = 1 | Distribution originale du modèle | Équilibre standard entre probabilité et variabilité |
| T > 1 | Distribution aplatie (haute entropie) | Sortie diverse, créative, risque accru d'incohérence |
Exemples appliqués dans différents domaines
Le choix de la température dépend directement de la tâche. Dans la génération créative, comme l'écriture de scénarios ou le brainstorming, on utilise généralement des valeurs élevées (0,7 à 1,2) pour favoriser la nouveauté et éviter la répétition de motifs prévisibles issus de l'entraînement.
Dans l'extraction de données structurées ou la génération de code, la précision est prioritaire. On y utilise des températures très basses (0,0 à 0,2) pour garantir que le modèle sélectionne toujours l'option la plus probable, minimisant ainsi les erreurs syntaxiques ou de format. Pour l'évaluation de benchmarks, il est recommandé d'utiliser une température nulle ou proche de zéro pour assurer la comparabilité des résultats entre différents modèles ou versions.
Dans le domaine de la génération de code, la faible température est essentielle pour garantir la validité syntaxique et la logique algorithmique. Les structures de code sont rigides et ne tolèrent pas les variations arbitraires ; une température élevée pourrait introduire des erreurs de syntaxe, des variables non définies ou des structures de contrôle incohérentes. La sélection déterministe du token le plus probable assure ainsi la robustesse du code généré et facilite son intégration dans des pipelines de développement existants.
Pour les tâches d'extraction de données, la stabilité du format de sortie est primordiale. Une température élevée pourrait amener le modèle à reformuler des dates, à changer la casse des clés JSON ou à introduire des espaces inattendus, ce qui briserait la compatibilité avec les systèmes aval. En maintenant une température proche de zéro, on s'assure que le modèle respecte strictement le schéma de données attendu, minimisant ainsi les coûts de post-traitement et les erreurs de parsing dans les applications de production.
Confusions fréquentes et concepts liés
Il est courant de confondre la température avec la « créativité » ou l'« intelligence » du modèle. Des études empiriques, comme celle de Peeperkorn et al. (2024), indiquent que la corrélation entre température et nouveauté est faible, tandis que la relation avec l'incohérence est modérée. Augmenter la température ne rend pas le modèle plus « intelligent », mais élargit la plage de tokens considérés.
La température interagit avec d'autres paramètres d'échantillonnage tels que top-k et top-p (échantillonnage noyau). Top-k limite la sélection aux k tokens les plus probables, tandis que top-p sélectionne l'ensemble le plus petit de tokens dont la probabilité cumulée dépasse un seuil (par exemple, 0,9). Ces paramètres agissent comme des filtres qui restreignent l'espace de recherche avant ou après l'application de la transformation de température, permettant un contrôle plus fin sur la qualité et la diversité.
L'interaction entre la température et les paramètres de filtrage comme top-k et top-p crée un espace de configuration multidimensionnel. La température modifie la forme globale de la distribution, tandis que top-k et top-p définissent les frontières de l'espace de recherche effectif. Cette synergie permet de contrôler finement le compromis entre la diversité des sorties et la cohérence contextuelle, en éliminant les tokens improbables avant ou après l'application de la transformation de température.
Il est important de noter que l'application de ces filtres peut rendre la température moins pertinente dans certains cas extrêmes. Si top-k est fixé à une valeur très faible, la distribution est déjà restreinte à un petit ensemble de tokens, et l'effet de la température sur la forme de la distribution devient marginal. La compréhension de ces interactions est essentielle pour éviter les configurations redondantes ou contradictoires qui pourraient dégrader la qualité des générations sans apporter de bénéfice significatif.
Limites pour la reproductibilité et l'évaluation
Bien qu'une température nulle produise théoriquement une sortie déterministe (décodage glouton), en pratique, l'indéterminisme peut persister en raison de la parallélisation sur le matériel (GPU) ou de la quantification des modèles. Cela signifie qu'avec T=0, deux exécutions identiques peuvent produire des résultats légèrement différents sur certains systèmes d'inférence.
Pour les équipes d'exploitation et les scientifiques des données, cela implique que la température est une variable critique dans la configuration d'inférence. Modifier ce paramètre altère la métrique d'évaluation. Il ne faut pas comparer les résultats d'un modèle avec T=0,5 à ceux d'un autre avec T=0,1 sans normaliser ce facteur, car la différence de sortie ne s'explique pas nécessairement par la capacité du modèle, mais par la configuration d'échantillonnage.
La variabilité résiduelle observée même avec une température nulle souligne la complexité des systèmes d'inférence modernes. La parallélisation des opérations sur les GPU et les optimisations matérielles peuvent introduire des différences minimes dans les calculs d'arithmétique en virgule flottante, conduisant à des résultats légèrement différents d'une exécution à l'autre. Cette non-déterminisme matériel est un facteur critique à considérer lors de la conception de tests de régression et de la validation des pipelines de production.
Pour les équipes de données, la documentation rigoureuse de la configuration d'inférence est indispensable pour garantir la reproductibilité des résultats. Cela inclut non seulement la valeur de la température, mais aussi la version exacte du modèle, la configuration du matériel et les paramètres de filtrage utilisés. Sans cette traçabilité, il est impossible d'attribuer correctement les variations de performance aux capacités du modèle plutôt qu'aux artefacts de la configuration d'échantillonnage, ce qui compromet la fiabilité des évaluations comparatives.
Processus pour assurer la reproductibilité
Étapes recommandées pour minimiser la variabilité indésirable dans les pipelines de production.
- 01Fixer la température à 0,0 pour les tâches déterministes.
- 02Vérifier si le fournisseur d'inférence prend en charge la fixation de la graine (seed) pour l'échantillonnage.
- 03Documenter la version exacte du modèle et la configuration du matériel (GPU/CPU) utilisée.
- 04Réaliser des tests A/B avec la même graine pour valider la cohérence de la sortie.