Definição numa frase
Grau de falta de certeza sobre uma previsão, uma resposta, a evidência disponível ou a validade de uma medição.
Definição e conceitos que não devem ser confundidos
A incerteza é o grau de falta de certeza sobre uma previsão, uma resposta, a evidência disponível ou a validade de uma medição. No contexto da estatística e do aprendizado de máquina, não se trata de um erro pontual, mas de uma medida da variabilidade potencial dos resultados. Como apontou o estatístico George Box, "todos os modelos estão errados, mas alguns são úteis"; a incerteza permite quantificar quanto um modelo se desvia da realidade e, portanto, determinar sua utilidade prática.
É crucial distinguir a incerteza da precisão e da exatidão. A exatidão refere-se à aproximação de uma previsão a um valor conhecido, enquanto a incerteza descreve quanto as previsões e os valores-alvo podem variar. Um sistema pode ser preciso (repetível) mas inexato, ou vice-versa. A quantificação da incerteza (UQ) transforma a afirmação vaga de que "um modelo pode estar errado" em informação específica e quantificável sobre o grau e a natureza do possível erro, o que é vital em campos onde a confiabilidade é primordial, como a medicina ou a engenharia.
Diferenças-chave entre conceitos relacionados
Tabela comparativa para distinguir conceitos que costumam ser confundidos na avaliação de modelos.
| Conceito | Definição | Pode ser reduzida com mais dados? |
|---|---|---|
| Incerteza aleatória | Ruído inerente ao processo de geração de dados (estocástico). | Não, é irredutível. |
| Incerteza epistêmica | Falta de conhecimento sobre o modelo ótimo ou dados insuficientes. | Sim, teoricamente redutível. |
| Exatidão | Proximidade da previsão ao valor verdadeiro. | Depende da qualidade do modelo e dos dados. |
| Precisão | Consistência das previsões entre si (repetibilidade). | Sim, com melhor calibração. |
Funcionamento passo a passo: da previsão à distribuição
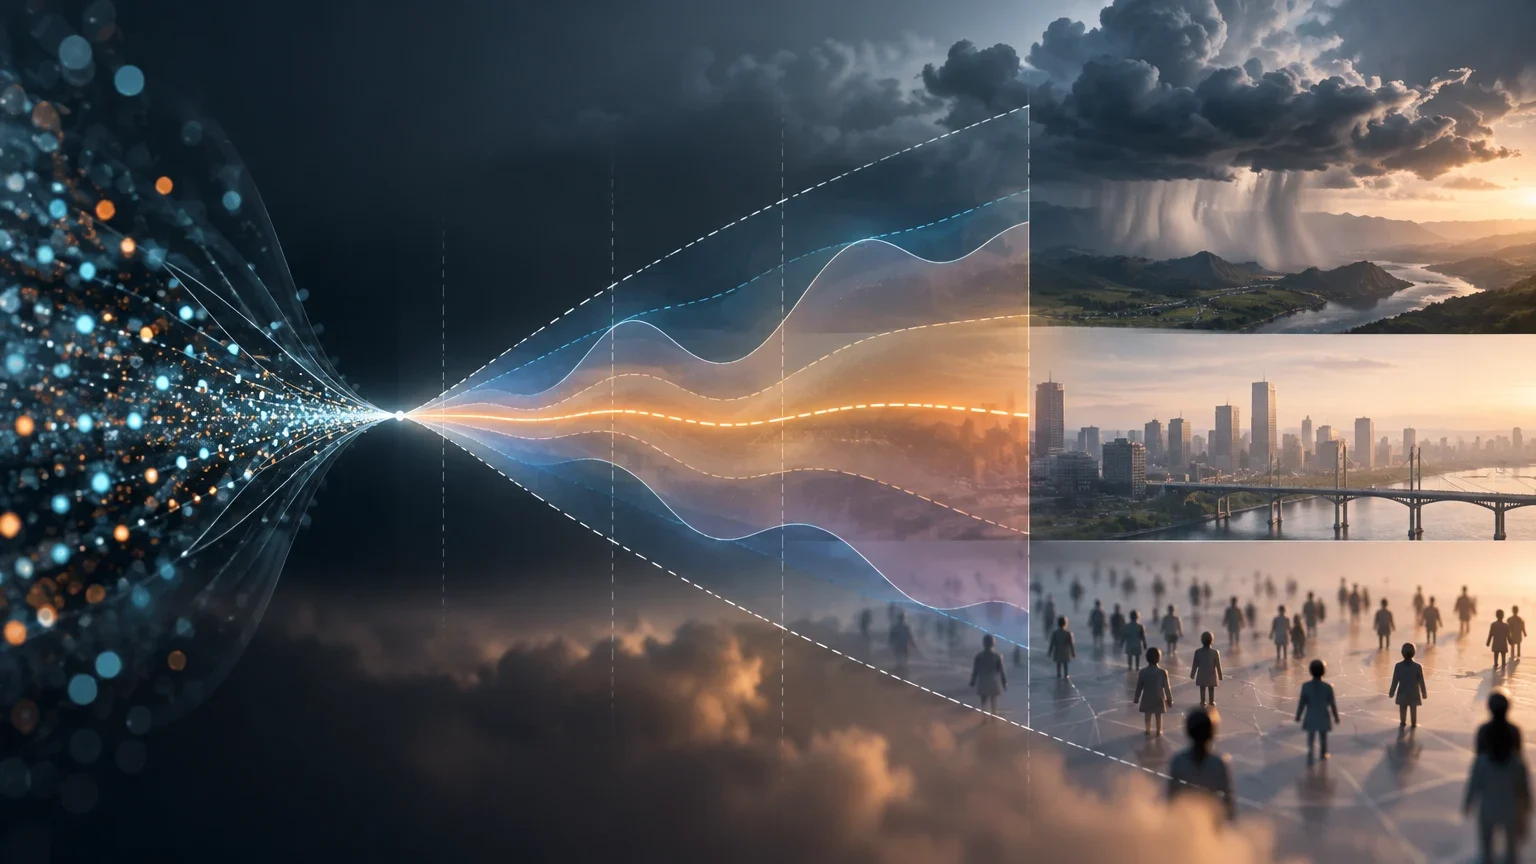
O funcionamento da quantificação da incerteza parte de tratar as saídas de um modelo não como valores fixos, mas como variáveis aleatórias. Em vez de gerar uma única estimativa pontual, o modelo produz uma distribuição de probabilidade. A amplitude desta distribuição é a medida direta da incerteza: quanto mais larga for a distribuição, maior será a incerteza associada ao resultado.
Existem duas fontes principais desta variabilidade. A primeira é a incerteza aleatória, que surge de processos estocásticos ou características aleatórias no sistema. Por exemplo, a variabilidade natural na resposta de um material a uma força. A segunda é a incerteza epistêmica, que provém do conhecimento incompleto, como a falta de dados de treinamento em certas regiões do espaço de características. Os métodos de UQ buscam separar ou estimar estas componentes para determinar a confiança que deve ser depositada em uma previsão concreta.
Fluxo básico de quantificação de incerteza
Processo geral para estimar a incerteza em um modelo preditivo.
- 01Definir o modelo base e os dados de treinamento.
- 02Identificar as fontes de variabilidade (aleatória vs. epistêmica).
- 03Aplicar um método de quantificação (ex.: amostragem, bayesiano ou ensemble).
- 04Gerar uma distribuição de previsões em vez de um valor único.
- 05Calcular métricas de dispersão (variância, intervalos de confiança) para quantificar a incerteza.
- 06Avaliar a calibração do modelo comparando a confiança prevista com a frequência observada de acertos.
Três exemplos desenvolvidos em áreas relevantes
Na meteorologia, um modelo pode prever uma probabilidade de chuva de 70%. A quantificação da incerteza ajuda a determinar se esse 70% se baseia em dados sólidos ou se a incerteza é tão alta que a probabilidade real pode oscilar entre 50% e 90%. Isso permite que os usuários tomem decisões mais informadas, como levar um guarda-chuva ou adiar eventos ao ar livre, com base na faixa de resultados possíveis em vez de um único número.
Na engenharia, considere um modelo que prevê quantas vezes uma dobradiça pode ser aberta e fechada antes de falhar. A incerteza aleatória captura a variabilidade material inerente, enquanto a epistêmica reflete a falta de testes em condições extremas. Um sistema de visão artificial que classifica apenas maçãs vermelhas ou verdes tem muito menos incerteza inerente do que um que classifica todas as frutas do mundo, devido à maior complexidade e variabilidade dos dados no segundo caso.
Em ciências sociais e economia, a incerteza afeta a validade das previsões quantitativas. Modelos de machine learning aplicados a dados sociais devem considerar a incerteza epistêmica derivada da complexidade das interações humanas e da limitação dos dados históricos. Distinguir entre o ruído aleatório nos dados e a falta de conhecimento sobre os mecanismos causais é essencial para evitar sobreajustes e para interpretar corretamente as limitações dos modelos preditivos em contextos dinâmicos.
Métodos de quantificação: amostragem, bayesiano e conjuntos
Os métodos baseados em amostragem, como a simulação de Monte Carlo, são amplamente utilizados porque podem lidar com qualquer complexidade do modelo. Executam milhares de simulações com entradas variadas aleatoriamente para construir uma imagem estatística dos resultados prováveis. Uma variante eficiente é a amostragem de hipercubo latino, que cobre bem o espaço de entrada com menos execuções. O abandono de Monte Carlo (Monte Carlo Dropout) é outra técnica que mantém a camada de abandono ativa durante a inferência, gerando múltiplas passadas para frente para obter uma distribuição de saídas sem necessidade de re-treinar o modelo.
Os métodos bayesianos atribuem distribuições de probabilidade aos parâmetros do modelo em vez de valores fixos. Utilizam o teorema de Bayes para combinar crenças prévias com dados observados. As redes neurais bayesianas (BNN) tratam os pesos da rede como distribuições de probabilidade, permitindo uma quantificação rigorosa da incerteza. Os métodos de conjunto (ensembles) baseiam-se na ideia de que, se vários modelos treinados de forma independente não concordam em uma previsão, esse desacordo indica incerteza. A variância das previsões do conjunto é utilizada como medida da incerteza, embora essa abordagem tenha um alto custo computacional.
Comparação de métodos de quantificação de incerteza
Resumo das vantagens e limitações dos principais métodos.
| Método | Vantagem principal | Limitação principal |
|---|---|---|
| Monte Carlo | Flexível, lida com qualquer complexidade. | Custoso computacionalmente (milhares de execuções). |
| Bayesiano (BNN) | Rigoroso, separa aleatória e epistêmica. | Complexo de implementar, requer MCMC ou variacional. |
| Conjuntos (Ensembles) | Intuitivo, mede o desacordo entre modelos. | Muito custoso (treinar N modelos completos). |
| Processos Gaussianos (GPR) | Eficiente, expressa incerteza inerentemente. | Escalabilidade limitada com grandes conjuntos de dados. |
Erros comuns e limites da quantificação
Um erro frequente é assumir que a incerteza é sempre redutível com mais dados. A incerteza aleatória é irredutível; provém da natureza estocástica do fenômeno. Tentá-la reduzir adicionando mais dados apenas aumenta o custo sem melhorar a precisão fundamental. Outro erro é confundir a calibração com a precisão. Um modelo pode estar bem calibrado (sua confiança reflete a probabilidade real de acerto) mas ser impreciso em suas previsões pontuais.
Os limites da quantificação da incerteza incluem o custo computacional, especialmente em modelos de deep learning de alta dimensionalidade. Além disso, a escolha do método de quantificação depende das características do modelo e do cenário. Não existe um método universal; a maioria das aplicações do mundo real combina múltiplas abordagens. É importante lembrar que a incerteza quantificada é uma estimativa, não uma verdade absoluta, e deve ser interpretada no contexto das suposições do modelo.
Perguntas frequentes e fontes primárias
Qual é a diferença principal entre incerteza aleatória e epistêmica? A incerteza aleatória é o ruído inerente aos dados, irredutível. A epistêmica é a falta de conhecimento do modelo, redutível com mais dados ou melhor modelagem. Quais métricas são utilizadas para avaliar a incerteza? São utilizadas regras de pontuação adequadas (como a probabilidade logarítmica negativa, NLL) e métricas de calibração (como o erro de calibração esperado, ECE). A NLL mede o ajuste da distribuição prevista aos resultados observados, enquanto o ECE mede a diferença entre a confiança prevista e a frequência observada de acertos.
A previsão conforme é útil para modelos de caixa preta? Sim, a previsão conforme é uma técnica independente do modelo que fornece garantias de cobertura válidas com suposições mínimas. É especialmente útil ao trabalhar com modelos pré-treinados de caixa preta, pois permite estabelecer intervalos de previsão sem necessidade de conhecer a estrutura interna do modelo. As fontes primárias incluem o trabalho de Hüllermeier e Waegeman sobre a distinção conceitual e o paper de Chavare e Mourelatos sobre métodos de quantificação em engenharia.