Identità e scopo del modello
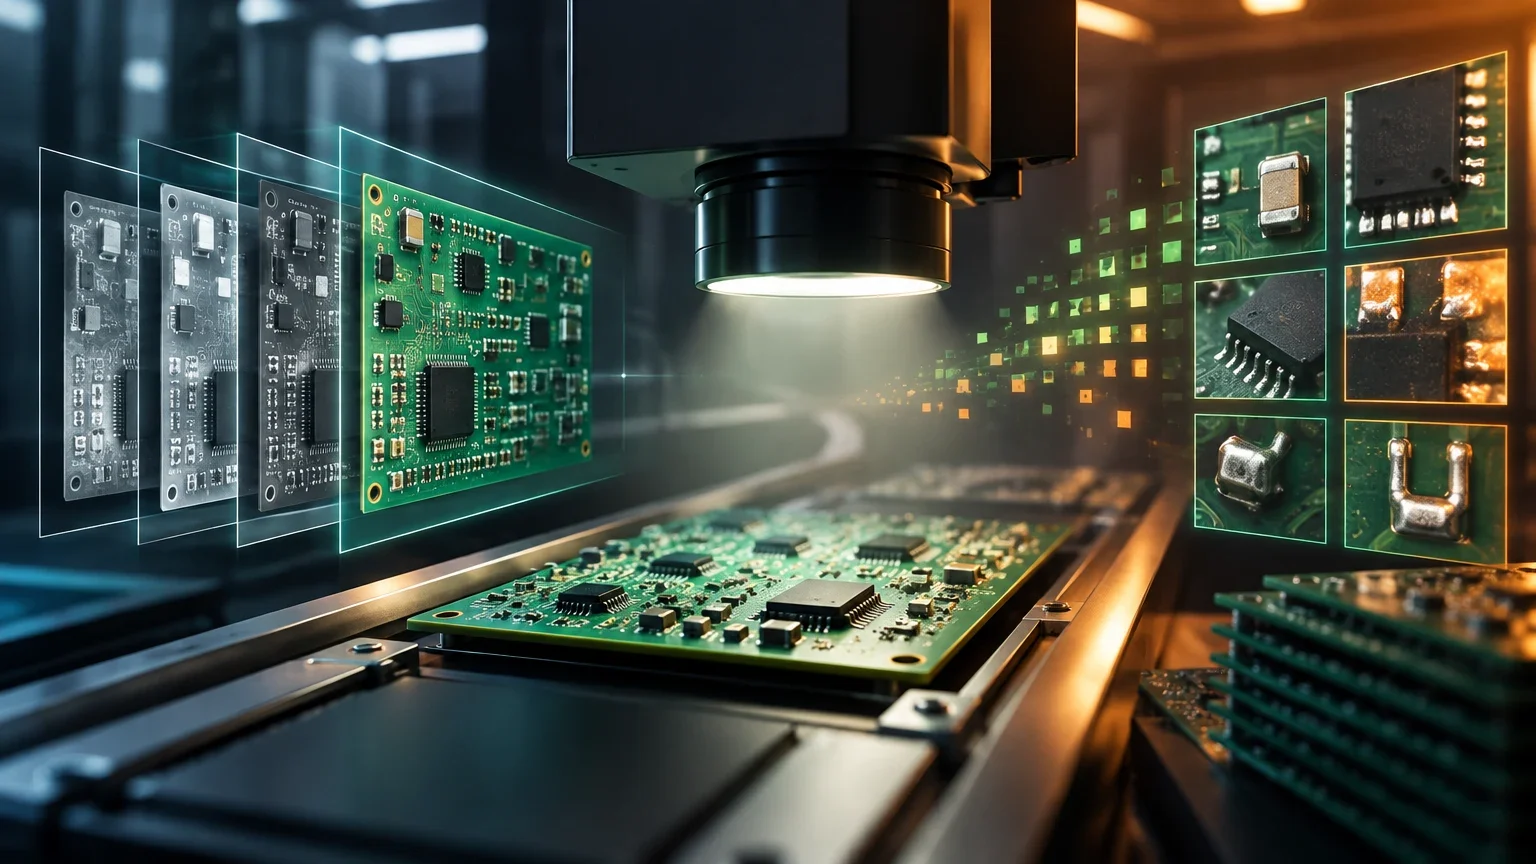
NVIDIA ha pubblicato la versione 1.0.0 di CDF Sim2Real SMT Solderlight, un modello di editing di immagini progettato specificamente per il pipeline di aumento dei dati per l'ispezione dei circuiti stampati (PCB). La sua funzione principale è trasformare ritagli sintetici di componenti elettronici, generati tramite rendering in Omniverse, in uno stile di illuminazione che simula le condizioni di un'ispezione ottica automatica (AOI).
A differenza dei modelli generici di generazione di immagini da testo, questo modello opera con un'istruzione fissa in inglese che descrive la trasformazione di stile e luce. L'utente non controlla il contenuto semantico dell'immagine tramite prompt liberi, ma il modello si concentra sul trasferimento di dominio visivo (sim-to-real) per migliorare la robustezza dei classificatori di difetti successivi.
La distinzione tra generazione libera e editing vincolato è fondamentale per comprendere l'architettura del flusso di lavoro. Poiché l'istruzione è fissa e non modificabile dall'utente, il modello non può essere utilizzato per creare variazioni creative o alterare la semantica dei componenti presenti nell'immagine di input. Questo vincolo progettuale garantisce che la trasformazione si concentri esclusivamente sulla modifica delle proprietà fotometriche, come l'intensità, la direzione e la temperatura del colore della luce, mantenendo inalterata la struttura geometrica e l'identità dei componenti elettronici. Tale approccio riduce il rischio di allucinazioni visive che potrebbero introdurre elementi non presenti nel rendering originale, un aspetto critico quando si tratta di dati destinati all'addestramento di sistemi di controllo qualità industriali dove la fedeltà al dettaglio è prioritaria rispetto alla creatività generativa.
Architettura e specifiche tecniche
Il modello deriva da Qwen-Image-Edit, ma il pacchetto distribuito non è un adattatore LoRA indipendente, bensì un pipeline completo con i pesi fusi. Secondo la scheda ufficiale, l'architettura stima circa 20 miliardi di parametri in totale, dei quali circa 170 milioni corrispondono ai pesi LoRA addestrati e fusi per questo compito specifico.
L'input consiste in un'immagine RGB di un componente PCB e nell'istruzione fissa. L'output è un'immagine PNG RGB. È cruciale notare che l'addestramento è stato effettuato con un'area target di 262.144 pixel, che equivale a ritagli quadrati di 512 × 512 pixel (0,262 megapixel). L'utilizzo di risoluzioni significativamente diverse da questa può degradare la qualità dello stile applicato.
La fusione dei pesi LoRA nel modello base implica che l'utente non ha la possibilità di regolare dinamicamente l'intensità dell'adattamento o di disattivare selettivamente parti della trasformazione. A differenza di un adattatore separato, che potrebbe essere caricato o scaricato a seconda delle esigenze operative, qui la modifica è permanente e integrata nell'architettura del modello distribuito. Questo design semplifica il deployment eliminando la necessità di gestire più componenti di memoria durante l'inferenza, ma riduce la flessibilità operativa. Inoltre, la stima di circa 20 miliardi di parametri suggerisce che la maggior parte della capacità computazionale è dedicata alla comprensione e alla manipolazione delle strutture visive complesse dei circuiti stampati, mentre i 170 milioni di parametri aggiuntivi guidano specificamente la mappatura dello stile di illuminazione richiesto per simulare le condizioni AOI.
Specifiche chiave del modello
Riepilogo dei parametri tecnici.
| Parametro | Valore / Descrizione |
|---|---|
| Versione | 1.0.0 |
| Data di pubblicazione | 20 ottobre 2026 |
| Base | Qwen-Image-Edit (pesi fusi) |
| Parametri totali | ~20B (stima) |
| Parametri LoRA | ~170M (fusi) |
| Area di addestramento | 262.144 pixel (512x512) |
| Modalità | Input: Immagine + Testo fisso; Output: Immagine |
Metodologia di addestramento e valutazione
NVIDIA dichiara che l’addestramento è stato effettuato con 364 coppie di dati. La valutazione pubblicata è qualitativa e visiva; la scheda pubblica non documenta una partizione indipendente per la validazione o il test. Il repository non include fotografie di riferimento di persone reali. Senza accesso a dati propri, questo limita il confronto diretto tra i risultati e le immagini reali di fabbrica.
Non vengono pubblicate punteggi numerici di qualità industriale (come F1-score o precisione di rilevamento dei difetti) per questo modello specifico. Pertanto, non è possibile ereditare i benchmark del modello base Qwen-Image-Edit, poiché l'adattamento LoRA modifica significativamente il comportamento del modello per il compito specifico di illuminazione dei PCB.
L'assenza di una partizione di test indipendente documentata nella scheda pubblica solleva considerazioni importanti sulla generalizzazione del modello. Sebbene l'addestramento con 364 coppie di dati possa sembrare un numero ridotto per standard di apprendimento profondo, nel contesto della simulazione di dominio specifico, la qualità e la diversità delle coppie di rendering sintetici sono fattori determinanti. La valutazione qualitativa suggerisce che i risultati sono stati verificati visivamente da esperti, ma la mancanza di metriche quantitative standardizzate impedisce un confronto oggettivo con altri metodi di aumento dei dati. Gli utenti devono quindi considerare questo modello come uno strumento promettente ma non ancora completamente validato su larga scala, richiedendo una fase di validazione interna rigorosa prima di integrarlo in pipeline di produzione critiche.
Licenza, costi e deployment
I pesi del modello sono disponibili pubblicamente sotto la licenza OpenMDW 1.1. È importante distinguere che i componenti originali di Qwen-Image-Edit mantengono la licenza Apache 2.0, ma il pacchetto specifico di NVIDIA è soggetto ai termini di OpenMDW 1.1, che devono essere rivisti per usi commerciali specifici.
Non esiste una tariffa API ufficiale pubblicata da NVIDIA per questo modello. Il costo di deployment è assunto come infrastruttura propria: è necessario budgetare GPU, memoria video, archiviazione e operazioni. Dato che il modello ha ~20B parametri, è richiesto hardware ad alte prestazioni per l'inferenza, il che implica costi di capitale e operativi significativi per i team che non dispongono di cluster GPU.
La distinzione tra la licenza Apache 2.0 dei componenti originali e la licenza OpenMDW 1.1 del pacchetto NVIDIA richiede un'analisi legale accurata prima di qualsiasi utilizzo commerciale. Mentre Apache 2.0 è una licenza permissiva ampiamente accettata nel settore open source, i termini di OpenMDW 1.1 possono includere restrizioni specifiche relative all'uso in prodotti commerciali o alla rivendita dei servizi derivanti. È essenziale che i team giuridici e di conformità esaminino attentamente questi termini per garantire che l'uso del modello non violi le condizioni di licenza, specialmente in contesti in cui le immagini generate vengono incorporate in prodotti finali venduti a clienti terzi. La trasparenza su questi aspetti legali è cruciale per evitare rischi di conformità e per pianificare correttamente i costi associati all'eventuale necessità di licenze aggiuntive o di supporto tecnico.
Considerazioni su costi e deployment
Fattori da considerare quando si integra il modello nell'infrastruttura propria.
| Elemento | Dettaglio |
|---|---|
| Licenza | OpenMDW 1.1 (verificare i termini commerciali) |
| API ufficiale | Non pubblicata; deployment proprio |
| Hardware | GPU ad alte prestazioni (consigliato per 20B parametri) |
| Costo diretto | Infrastruttura propria (GPU, RAM, Archiviazione) |
| Costo indiretto | Sviluppo del pipeline, integrazione e manutenzione |
Limiti, sicurezza e bias
Il documento BIAS.md ufficiale conferma che il modello opera esclusivamente su rendering sintetici e immagini generate da macchina di componenti PCB inanimati. Non ci sono soggetti umani nei dati di addestramento o valutazione e non vengono utilizzate etichette di attributi umani come segnale di supervisione. Questo elimina i rischi di bias demografici, ma non garantisce l'assenza di bias tecnici legati alla variabilità dell'illuminazione reale non coperta dalle 364 coppie di addestramento.
La sicurezza e la privacy sono affrontate in documenti specifici (SAFETY.md, PRIVACY.md) inclusi nel repository. Dato che il modello elabora immagini di componenti elettronici, i rischi di privacy sono minimi, ma i rischi di sicurezza sono legati all'integrità del pipeline di ispezione: se il modello introduce artefatti che imitano difetti, potrebbe generare falsi positivi nel sistema di controllo qualità.
I rischi di sicurezza legati all'integrità del pipeline di ispezione vanno oltre la semplice generazione di falsi positivi. Se il modello introduce artefatti sistematici che imitano specifici tipi di difetti, come ponti di saldatura o componenti mancanti, il classificatore di difetti addestrato su questi dati potrebbe sviluppare una sensibilità eccessiva a tali pattern, portando a un tasso di scarto elevato di prodotti sani. Questo fenomeno, noto come overfitting su artefatti di dominio, può compromettere l'efficienza della linea di produzione e aumentare i costi operativi. Pertanto, è fondamentale monitorare attentamente la distribuzione dei difetti rilevati dopo l'implementazione del modello e confrontarla con i dati storici di produzione per identificare eventuali anomalie che possano indicare l'influenza negativa della trasformazione di stile.
Criteri pratici di scelta
Questo modello è adatto per i team di visione computerizzata industriale che necessitano di aumentare la diversità dell'illuminazione nei propri dataset di addestramento per l'ispezione dei PCB. Non è adatto per i team che cercano una soluzione di rilevamento dei difetti 'out-of-the-box', poiché il modello genera solo immagini modificate, non classifica i difetti.
La decisione di adottare questo modello deve basarsi sulla disponibilità di hardware GPU sufficiente, sulla capacità di integrare il pipeline di inferenza nel flusso di lavoro esistente e sulla disponibilità a effettuare una valutazione rigorosa della qualità delle immagini generate prima di usarle per addestrare classificatori.
La decisione di adottare questo modello deve essere vista come un investimento a lungo termine nella robustezza del sistema di visione computerizzata, piuttosto che come una soluzione immediata. I team devono essere preparati a investire tempo e risorse nella fase di calibrazione e validazione, che può richiedere diverse iterazioni per ottimizzare i parametri di inferenza e garantire che le immagini generate siano coerenti con le aspettative del classificatore di difetti. Inoltre, la capacità di integrare il pipeline di inferenza nel flusso di lavoro esistente richiede competenze tecniche specifiche in ambito di machine learning e ingegneria del software. La disponibilità a effettuare una valutazione rigorosa della qualità delle immagini generate è un prerequisito fondamentale per massimizzare il valore del modello e minimizzare i rischi associati all'uso di dati sintetici in ambienti industriali reali.
Processo di integrazione consigliato
Passi per integrare il modello in un pipeline di ispezione.
- 011. Verificare la licenza OpenMDW 1.1 per l'uso commerciale previsto.
- 022. Preparare l'hardware GPU con memoria sufficiente per i 20B parametri.
- 033. Implementare il pipeline di inferenza con l'istruzione fissa.
- 044. Generare un set di immagini di test a partire da rendering sintetici.
- 055. Valutare visivamente la qualità della trasformazione di stile.
- 066. Addestrare un classificatore di difetti con le immagini aumentate.
- 077. Validare le prestazioni del classificatore con revisione umana.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione