Identidad y propósito del modelo
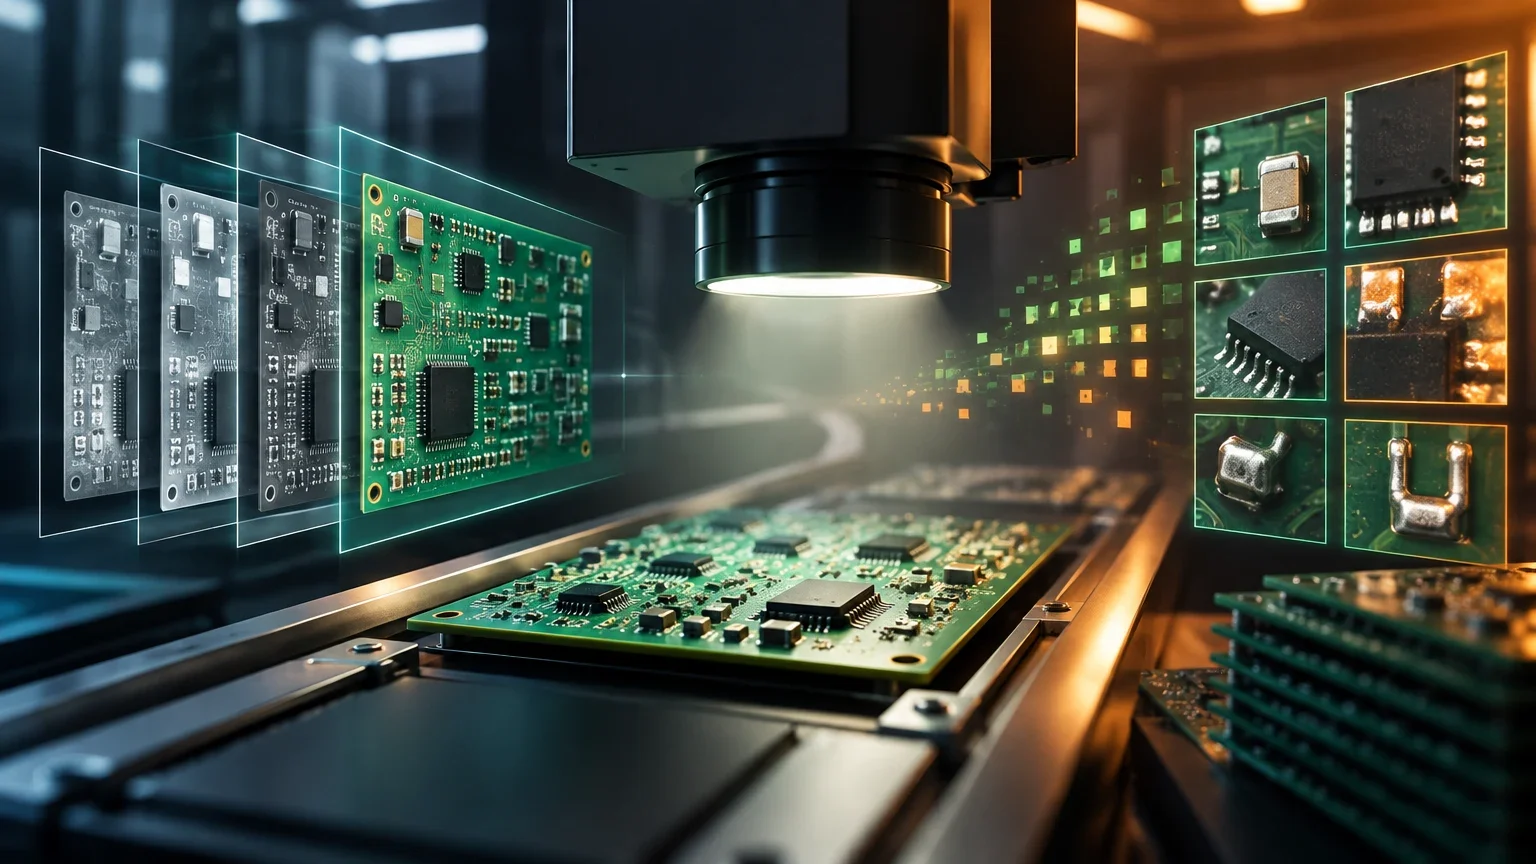
NVIDIA ha publicado la versión 1.0.0 de CDF Sim2Real SMT Solderlight, un modelo de edición de imágenes diseñado específicamente para el pipeline de aumento de datos de inspección de circuitos impresos (PCB). Su función principal es transformar recortes sintéticos de componentes electrónicos, generados mediante renderizaciones en Omniverse, hacia un estilo de iluminación que simula las condiciones de una inspección óptica automática (AOI).
A diferencia de los modelos de generación de texto a imagen genéricos, este modelo opera con una instrucción fija en inglés que describe la transformación de estilo y luz. El usuario no controla el contenido semántico de la imagen mediante prompts libres, sino que el modelo se centra en la transferencia de dominio visual (sim-to-real) para mejorar la robustez de los clasificadores de defectos posteriores.
La especificidad de este modelo radica en su alineación estricta con el flujo de trabajo de Omniverse, donde los recortes sintéticos de componentes electrónicos se generan con una fidelidad geométrica y material elevada, pero carecen de la complejidad fotométrica inherente a las cámaras industriales. Al aplicar la transformación de estilo hacia las condiciones de una inspección óptica automática, el modelo busca cerrar la brecha visual entre el entorno simulado y el entorno físico, permitiendo que los clasificadores de defectos posteriores aprendan a generalizar mejor ante variaciones de luz que no están presentes en los renders originales. Esta aproximación de transferencia de dominio visual es fundamental para mejorar la robustez de los sistemas de visión por computadora en entornos de fabricación, donde la iluminación puede fluctuar debido a factores ambientales o de calibración de la maquinaria.
El uso de una instrucción fija en inglés elimina la variabilidad introducida por la redacción de prompts por parte de los usuarios, lo que garantiza una consistencia operativa en la generación de datos aumentados. Esta decisión de diseño refuerza la idea de que el modelo no es una herramienta de creación artística o de generación libre, sino un componente determinista dentro de una cadena de procesamiento de datos. Al centrarse exclusivamente en la modificación de la apariencia de la luz y el estilo, sin alterar la semántica de los componentes electrónicos, se preserva la integridad de las características estructurales que los clasificadores de defectos necesitan para identificar anomalías. Esta limitación intencional del alcance funcional asegura que el modelo cumpla su propósito de preparar datos de entrenamiento de alta calidad, sin introducir ruido semántico que podría confundir a los algoritmos de detección posteriores.
Arquitectura y especificaciones técnicas
El modelo deriva de Qwen-Image-Edit, pero el paquete distribuido no es un adaptador LoRA independiente: es una pipeline completa con los pesos fusionados. La arquitectura tiene unos 20.000 millones de parámetros en total, de los cuales aproximadamente 170 millones son pesos LoRA entrenados y fusionados para esta tarea específica.
La entrada consiste en una imagen RGB de un componente PCB y la instrucción fija. La salida es una imagen PNG RGB. Es crucial notar que el entrenamiento se realizó con un área objetivo de 262.144 píxeles, lo que equivale a recortes cuadrados de 512 × 512 píxeles (0,262 megapíxeles). Utilizar resoluciones significativamente diferentes a esta puede degradar la calidad del estilo aplicado.
La decisión de distribuir el modelo como una pipeline completa con los pesos LoRA fusionados, en lugar de como un adaptador independiente, simplifica el proceso de inferencia para los equipos de ingeniería. Al integrar los pesos específicos de la tarea en la arquitectura base de Qwen-Image-Edit, se reduce la complejidad de la configuración del entorno de ejecución, ya que no es necesario cargar y gestionar múltiples capas de adaptadores durante la inferencia. Esta arquitectura unificada facilita la integración en sistemas de producción que requieren estabilidad y reproducibilidad, minimizando los puntos de fallo asociados a la gestión de pesos dinámicos. Sin embargo, esta fusión también implica que el modelo está optimizado específicamente para la tarea de iluminación de PCBs, lo que limita su reutilización para otras tareas de edición de imágenes sin un nuevo proceso de entrenamiento o ajuste fino.
La restricción del área de entrenamiento a 262.144 píxeles, equivalente a recortes de 512 × 512 píxeles, establece un estándar operativo claro para la preprocesación de las imágenes de entrada. Este tamaño de recorte es coherente con la escala a la que suelen observarse los componentes electrónicos en las cámaras de inspección óptica automática, donde el detalle fino de las soldaduras y las pistas de cobre es crítico para la detección de defectos. Al mantener la resolución de entrada dentro de este rango, se asegura que el modelo aplique la transformación de estilo de manera uniforme y sin degradación de la calidad. Las desviaciones significativas de esta resolución pueden provocar artefactos o una aplicación inconsistente del estilo de iluminación, lo que comprometería la utilidad de las imágenes generadas para el entrenamiento de clasificadores de defectos. Por lo tanto, la normalización de las imágenes de entrada a este tamaño específico es un paso crucial en el pipeline de aumento de datos.
Especificaciones clave del modelo
Parámetros técnicos del modelo.
| Parámetro | Valor / Descripción |
|---|---|
| Versión | 1.0.0 |
| Fecha de publicación | 20 de octubre de 2026 |
| Base | Qwen-Image-Edit (pesos fusionados) |
| Parámetros totales | ~20B (estimado) |
| Parámetros LoRA | ~170M (fusionados) |
| Área de entrenamiento | 262.144 píxeles (512x512) |
| Modalidades | Entrada: Imagen + Texto fijo; Salida: Imagen |
Metodología de entrenamiento y evaluación
NVIDIA indica que el entrenamiento utilizó 364 pares de datos. La evaluación publicada es cualitativa y visual; la ficha no documenta una partición independiente de validación o prueba. El repositorio no incluye fotografías humanas de referencia, lo que limita la comparación directa con imágenes reales de fábrica si no se dispone de datos propios.
No se publican puntuaciones numéricas de calidad industrial (como F1-score o precisión de detección de defectos) para este modelo específico. Por lo tanto, no se pueden heredar los benchmarks del modelo base Qwen-Image-Edit, ya que el ajuste LoRA modifica significativamente el comportamiento del modelo para la tarea específica de iluminación de PCBs.
El uso de un conjunto de datos de entrenamiento compuesto por 364 pares de datos refleja una estrategia de aprendizaje por pares que prioriza la calidad y la relevancia de las muestras sobre la cantidad masiva de datos. Esta metodología permite al modelo aprender las correspondencias específicas entre los renders sintéticos y las condiciones de iluminación de la inspección óptica automática, sin la necesidad de millones de ejemplos que podrían diluir la especificidad de la tarea. La evaluación cualitativa y visual, aunque limitada en su capacidad para proporcionar métricas numéricas precisas, ofrece una visión directa de la eficacia del modelo en la transformación de estilo. La ausencia de una partición independiente de validación o prueba documentada en la ficha pública subraya la importancia de que los usuarios realicen sus propias evaluaciones internas, adaptadas a sus propios datos de fábrica y requisitos de calidad.
La falta de puntuaciones numéricas de calidad industrial, como el F1-score o la precisión de detección de defectos, para este modelo específico es una consecuencia directa de su naturaleza como herramienta de aumento de datos, no como un clasificador de defectos. Los benchmarks del modelo base Qwen-Image-Edit no son transferibles a este caso, ya que el ajuste LoRA modifica significativamente el comportamiento del modelo para adaptarlo a la tarea específica de iluminación de PCBs. Esta distinción es crucial para evitar malentendidos sobre el rendimiento del modelo en aplicaciones de control de calidad. La evaluación recomendada, que incluye la separación de placas de entrenamiento y prueba y la medición de la preservación geométrica, proporciona un marco práctico para validar la utilidad del modelo en contextos reales, asegurando que las imágenes generadas no introduzcan defectos artificiales que puedan comprometer la integridad del sistema de inspección.
Licencia, costes y despliegue
Los pesos del modelo están disponibles públicamente bajo la licencia OpenMDW 1.1. Es importante distinguir que los componentes originales de Qwen-Image-Edit conservan la licencia Apache 2.0, pero el paquete específico de NVIDIA está sujeto a los términos de OpenMDW 1.1, que debe ser revisado para usos comerciales específicos.
No existe una tarifa API oficial publicada por NVIDIA para este modelo. El coste de despliegue se asume como infraestructura propia: se requiere presupuestar GPU, memoria de vídeo, almacenamiento y operación. Dado que el modelo tiene ~20B parámetros, se requiere hardware de alto rendimiento para la inferencia, lo que implica costes de capital y operativos significativos para equipos que no dispongan de clústeres GPU.
La distinción entre la licencia OpenMDW 1.1 aplicada al paquete específico de NVIDIA y la licencia Apache 2.0 de los componentes originales de Qwen-Image-Edit es un aspecto legal y operativo que requiere una revisión cuidadosa por parte de los equipos que planean usar el modelo en entornos comerciales. La licencia OpenMDW 1.1 puede contener restricciones o condiciones específicas que no están presentes en la licencia Apache 2.0, lo que podría afectar a la capacidad de modificar, redistribuir o usar el modelo en ciertos contextos. Esta complejidad licencial subraya la necesidad de involucrar a los departamentos legales en las etapas iniciales de la adopción del modelo, para asegurar el cumplimiento de todos los términos y condiciones aplicables. La disponibilidad pública de los pesos bajo esta licencia facilita el acceso y la experimentación, pero no elimina la responsabilidad de verificar la compatibilidad con los usos comerciales previstos.
La ausencia de una tarifa API oficial publicada por NVIDIA implica que el coste de despliegue está directamente ligado a la infraestructura propia de cada organización. Para un modelo con aproximadamente 20.000 millones de parámetros, la inferencia requiere hardware de alto rendimiento, lo que puede representar una inversión significativa en capital y costes operativos para equipos que no dispongan de clústeres GPU dedicados. La necesidad de presupuestar GPU, memoria de vídeo, almacenamiento y operación debe ser considerada en el análisis de viabilidad económica del proyecto. Además, los costes indirectos, como el desarrollo de la pipeline de inferencia, la integración en el flujo de trabajo existente y el mantenimiento continuo, deben ser incluidos en la estimación total de costes. Esta estructura de costes descentralizada ofrece flexibilidad en la configuración del hardware, pero también transfiere la responsabilidad de la optimización y la gestión de la infraestructura a los usuarios finales.
Consideraciones de coste y despliegue
Factores a considerar al integrar el modelo en la infraestructura propia.
| Elemento | Detalle |
|---|---|
| Licencia | OpenMDW 1.1 (verificar términos comerciales) |
| API oficial | No publicada; despliegue propio |
| Hardware | GPU de alto rendimiento (recomendado para 20B parámetros) |
| Coste directo | Infraestructura propia (GPU, RAM, Almacenamiento) |
| Coste indirecto | Desarrollo de pipeline, integración y mantenimiento |
Limitaciones, seguridad y sesgo
El modelo opera sobre renders sintéticos e imágenes generadas por máquina de componentes PCB inanimados. Los datos de entrenamiento y evaluación no incluyen sujetos humanos ni emplean etiquetas de atributos humanos como señal de supervisión. Esto reduce los riesgos de sesgo demográfico asociados al uso de datos humanos, pero no demuestra que el modelo esté libre de sesgos técnicos, por ejemplo, ante variaciones de iluminación real que los 364 pares de entrenamiento quizá no representen.
El modelo procesa imágenes de componentes electrónicos, por lo que los riesgos de privacidad pueden ser limitados, aunque dependen del contenido de las imágenes y de cómo se gestionen. En una inspección de calidad, los artefactos que imiten defectos podrían producir falsos positivos. El modelo, por sí solo, no garantiza la integridad del pipeline de inspección.
El uso de renders sintéticos e imágenes generadas por máquina de componentes PCB inanimados evita depender de datos de sujetos humanos, pero no elimina los posibles sesgos técnicos relacionados con la iluminación real. Los 364 pares de entrenamiento quizá no cubran todas las condiciones de iluminación de una línea de producción, lo que podría limitar la generalización a escenarios no representados. Las pruebas con datos propios de fábrica permiten evaluar discrepancias entre las salidas del modelo y las condiciones reales de inspección. La ausencia de sujetos humanos en los datos de entrenamiento puede simplificar algunas consideraciones de privacidad, pero no elimina la necesidad de proteger el pipeline de inspección.
Los riesgos de seguridad relacionados con la integridad del pipeline de inspección son un aspecto crítico que debe ser abordado mediante la implementación de etapas de validación humana o de segundo nivel. Si el modelo introduce artefactos que imitan defectos, podría generar falsos positivos en el sistema de control de calidad, lo que podría llevar a la rechazo de productos válidos o a la necesidad de re-inspección manual, aumentando los costes operativos y los tiempos de ciclo. La advertencia de que el modelo no ha sido validado para uso en tiempo real en líneas de producción sin pruebas exhaustivas resalta la necesidad de un enfoque cauteloso en la integración del modelo en flujos de trabajo críticos. La transformación de estilo, aunque diseñada para mejorar la robustez de los clasificadores, puede introducir variaciones no deseadas que interfieran con la detección de defectos reales, por lo que la validación continua es esencial para garantizar la fiabilidad del sistema de inspección.
Criterios prácticos de elección
Este modelo es adecuado para equipos de visión por computadora industrial que necesitan aumentar la diversidad de iluminación en sus datasets de entrenamiento para inspección de PCBs. No es adecuado para equipos que busquen una solución de detección de defectos 'out-of-the-box', ya que el modelo solo genera imágenes modificadas, no clasifica defectos.
La decisión de adoptar este modelo debe basarse en la disponibilidad de hardware GPU suficiente, la capacidad de integrar la pipeline de inferencia en el flujo de trabajo existente y la disposición a realizar una evaluación rigurosa de la calidad de las imágenes generadas antes de usarlas para entrenar clasificadores.
La adecuación de este modelo para equipos de visión por computadora industrial que buscan aumentar la diversidad de iluminación en sus datasets de entrenamiento se basa en su capacidad para generar imágenes modificadas que simulan las condiciones de una inspección óptica automática. Sin embargo, no es una solución de detección de defectos 'out-of-the-box', ya que su función se limita a la preparación de datos, no a la clasificación de anomalías. Esta distinción es fundamental para alinear las expectativas de los usuarios y evitar la adopción del modelo en contextos donde se espera una funcionalidad de detección directa. La decisión de adoptar este modelo debe basarse en una evaluación rigurosa de la calidad de las imágenes generadas, considerando la disponibilidad de hardware GPU suficiente y la capacidad de integrar la pipeline de inferencia en el flujo de trabajo existente.
El proceso de integración recomendado, que incluye la verificación de la licencia, la preparación del hardware, la implementación de la pipeline de inferencia y la evaluación visual de la calidad de la transformación, proporciona un marco estructurado para la adopción del modelo. La generación de un conjunto de imágenes de prueba a partir de renders sintéticos y la validación del rendimiento del clasificador con revisión humana son pasos cruciales para asegurar que el modelo cumpla con los requisitos de calidad del sistema de inspección. Este enfoque iterativo permite identificar y corregir cualquier problema en las etapas iniciales, antes de que el modelo se integre completamente en el flujo de producción. La disposición a realizar una evaluación rigurosa y a mantener una etapa de validación humana o de segundo nivel es esencial para garantizar la fiabilidad y la seguridad del sistema de control de calidad.
Proceso de integración recomendado
Pasos para integrar el modelo en un pipeline de inspección.
- 011. Verificar la licencia OpenMDW 1.1 para el uso comercial previsto.
- 022. Preparar el hardware GPU con suficiente memoria para los 20B parámetros.
- 033. Implementar la pipeline de inferencia con la instrucción fija.
- 044. Generar un conjunto de imágenes de prueba a partir de renders sintéticos.
- 055. Evaluar visualmente la calidad de la transformación de estilo.
- 066. Entrenar un clasificador de defectos con las imágenes aumentadas.
- 077. Validar el rendimiento del clasificador con revisión humana.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección