Identidade e propósito do modelo
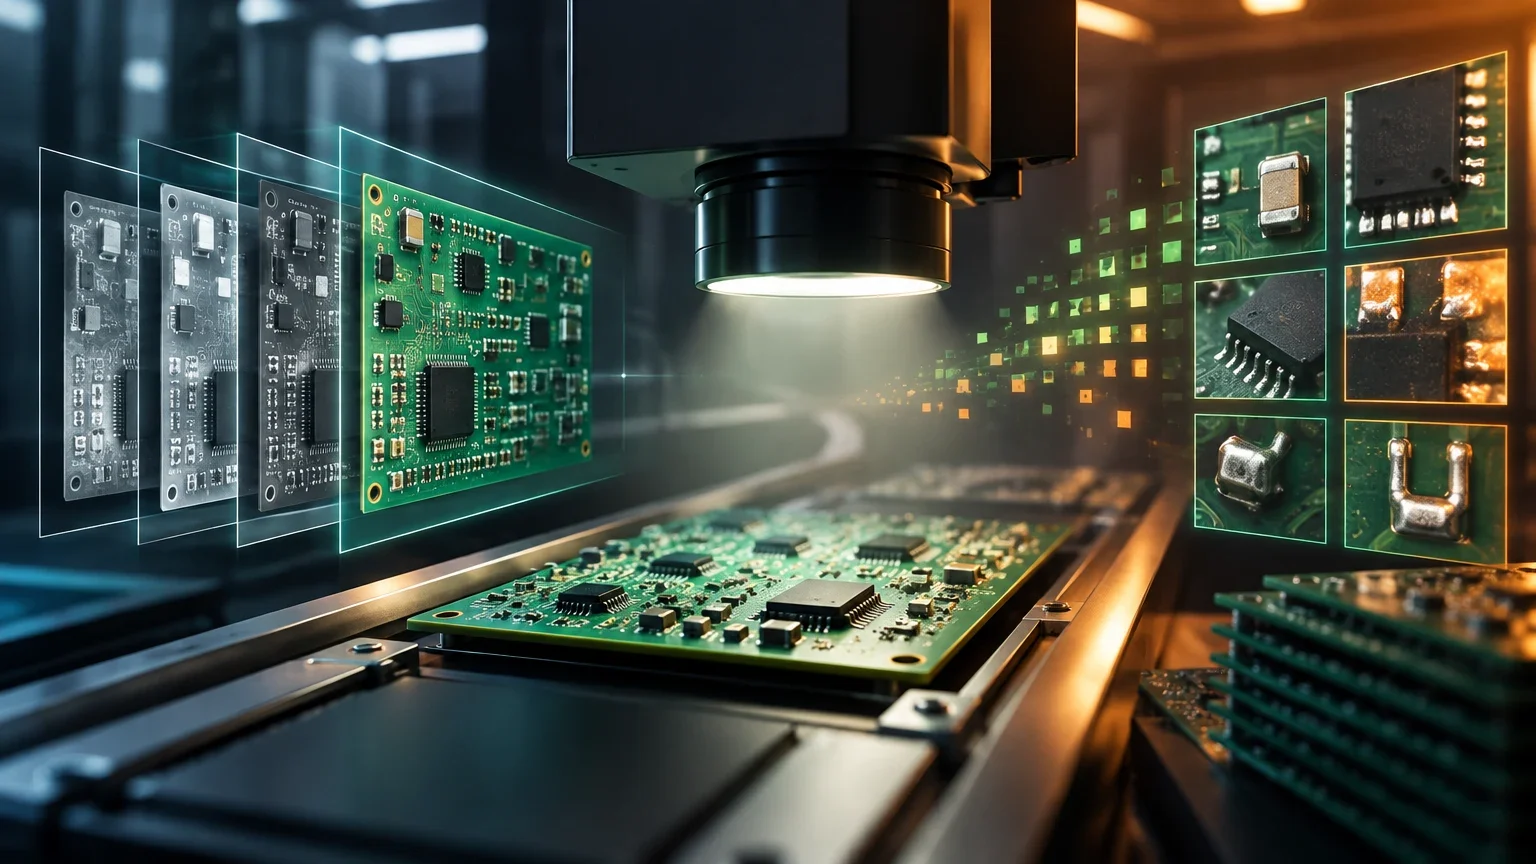
A NVIDIA publicou a versão 1.0.0 do CDF Sim2Real SMT Solderlight, um modelo de edição de imagens projetado especificamente para o pipeline de aumento de dados de inspeção de placas de circuito impresso (PCB). Sua função principal é transformar recortes sintéticos de componentes eletrônicos, gerados por renderizações no Omniverse, para um estilo de iluminação que simula as condições de uma inspeção óptica automática (AOI).
Diferentemente dos modelos genéricos de geração de imagem a partir de texto, este modelo opera com uma instrução fixa em inglês que descreve a transformação de estilo e luz. O usuário não controla o conteúdo semântico da imagem por meio de prompts livres; em vez disso, o modelo se concentra na transferência de domínio visual (sim-to-real) para melhorar a robustez dos classificadores de defeitos posteriores.
A utilização de uma instrução fixa em inglês serve para restringir o espaço de possibilidades do modelo, direcionando-o exclusivamente para a tarefa de transferência de domínio visual. Este mecanismo não elimina a natureza estocástica inerente aos processos de geração baseados em difusão; portanto, a saída pode apresentar variações sutis entre execuções, mesmo com a mesma entrada e o mesmo prompt. A consistência percebida depende da estabilidade do processo de inferência e não constitui uma garantia determinística de reprodutibilidade exata, uma vez que a documentação não especifica o controle de sementes aleatórias como parte do fluxo padrão.
O foco na iluminação simula as condições de uma inspeção óptica automática, mas a transformação é aplicada sobre recortes sintéticos gerados no Omniverse. Isso significa que o modelo aprende a mapear características visuais de renders 3D para um estilo fotográfico realista, sem alterar a geometria ou a semântica dos componentes eletrônicos. A ausência de controle semântico por parte do usuário reforça que o objetivo é a padronização estética para fins de treinamento, e não a criação de novas variações de defeitos ou componentes que não existam na imagem de entrada original.
Arquitetura e especificações técnicas
O modelo deriva do Qwen-Image-Edit, mas o pacote distribuído não é um adaptador LoRA independente, e sim um pipeline completo com os pesos fundidos. De acordo com a ficha oficial, a arquitetura estima cerca de 20 bilhões de parâmetros no total, dos quais aproximadamente 170 milhões correspondem aos pesos LoRA treinados e fundidos para esta tarefa específica.
A entrada consiste em uma imagem RGB de um componente de PCB e a instrução fixa. A saída é uma imagem PNG RGB. É crucial notar que o treinamento foi realizado com uma área alvo de 262.144 pixels, o que equivale a recortes quadrados de 512 × 512 pixels (0,262 megapixels). O uso de resoluções significativamente diferentes dessa pode degradar a qualidade do estilo aplicado.
A distinção entre os parâmetros totais e os pesos LoRA fundidos é fundamental para compreender a complexidade computacional do modelo. Embora a base Qwen-Image-Edit possua uma arquitetura robusta, a fusão dos pesos específicos para a tarefa de iluminação de PCBs resulta em um modelo monolítico que não requer a carga dinâmica de adaptadores durante a inferência. Essa abordagem simplifica o pipeline de execução, mas exige que todo o conjunto de pesos de aproximadamente 20 bilhões esteja disponível na memória de vídeo da GPU, o que impõe requisitos de hardware significativamente mais elevados do que os necessários para modelos menores ou para a utilização de adaptadores separados.
A restrição de área de treinamento para 262.144 pixels implica que o modelo foi otimizado para processar recortes quadrados de 512 por 512 pixels. A aplicação de imagens com resoluções diferentes pode levar a uma degradação na qualidade da transformação de estilo, pois o modelo pode não generalizar adequadamente para escalas fora da faixa de treinamento. É recomendável que o pré-processamento das imagens de entrada inclua o redimensionamento ou o recorte para as dimensões específicas para as quais o modelo foi calibrado, a fim de mitigar riscos de artefatos ou perda de detalhes na saída.
Especificações-chave do modelo
Resumo dos parâmetros técnicos verificados na documentação oficial.
| Parâmetro | Valor / Descrição |
|---|---|
| Versão | 1.0.0 |
| Data de publicação | 20 de outubro de 2026 |
| Base | Qwen-Image-Edit (pesos fundidos) |
| Parâmetros totais | ~20B (estimado) |
| Parâmetros LoRA | ~170M (fundidos) |
| Área de treinamento | 262.144 pixels (512x512) |
| Modalidades | Entrada: Imagem + Texto fixo; Saída: Imagem |
Metodologia de treinamento e avaliação
A NVIDIA indica que o treinamento foi realizado com 364 pares de dados. A avaliação publicada é qualitativa e visual, sem partição independente de validação ou teste documentada na ficha pública. Não há fotografias humanas de referência empacotadas no repositório, o que limita a capacidade de comparar diretamente a saída com imagens reais de fábrica sem acesso a dados próprios.
Não são publicadas pontuações numéricas de qualidade industrial (como F1-score ou precisão de detecção de defeitos) para este modelo específico. Portanto, não é possível herdar os benchmarks do modelo base Qwen-Image-Edit, pois o ajuste LoRA modifica significativamente o comportamento do modelo para a tarefa específica de iluminação de PCBs.
A limitação do conjunto de treinamento para 364 pares de dados indica uma abordagem de aprendizado por exemplo único ou de baixo volume, focada na qualidade da correspondência entre o render sintético e a imagem real de referência. A ausência de métricas numéricas independentes, como F1-score ou precisão de detecção, significa que a eficácia do modelo em melhorar a robustez dos classificadores de defeitos não pode ser quantificada a partir da documentação pública. A avaliação deve, portanto, ser conduzida internamente pelas equipes de engenharia, utilizando dados próprios de fábrica para validar se a transformação de iluminação realmente contribui para a redução de falsos negativos ou positivos nos sistemas de inspeção subsequentes.
A falta de fotografias humanas de referência no repositório limita a capacidade de comparação direta com a realidade industrial sem o acesso a dados proprietários. Isso reforça a necessidade de um processo de validação rigoroso, onde as imagens geradas pelo modelo são analisadas por especialistas em visão computacional para verificar a preservação geométrica dos componentes e a ausência de artefatos indesejados. A avaliação visual qualitativa, embora necessária, não substitui a medição quantitativa do impacto no desempenho do classificador de defeitos, que deve ser o critério final para a adoção do modelo em produção.
Licença, custos e implantação
Os pesos do modelo estão disponíveis publicamente sob a licença OpenMDW 1.1. É importante distinguir que os componentes originais do Qwen-Image-Edit mantêm a licença Apache 2.0, mas o pacote específico da NVIDIA está sujeito aos termos da OpenMDW 1.1, que devem ser revisados para usos comerciais específicos.
Não existe uma tarifa de API oficial publicada pela NVIDIA para este modelo. O custo de implantação é assumido como infraestrutura própria: é necessário orçar GPU, memória de vídeo, armazenamento e operação. Dado que o modelo tem ~20B parâmetros, é necessário hardware de alto desempenho para a inferência, o que implica custos de capital e operacionais significativos para equipes que não disponham de clusters GPU.
A distinção entre a licença Apache 2.0 dos componentes originais e a OpenMDW 1.1 do pacote específico da NVIDIA exige uma análise jurídica cuidadosa antes da implementação em ambientes comerciais. A OpenMDW 1.1 pode conter cláusulas adicionais que não estão presentes na licença base, o que pode impactar a distribuição, a modificação ou o uso em produtos finais. Equipes de desenvolvimento devem consultar seus departamentos legais para garantir conformidade, especialmente se o modelo for integrado em soluções de software que serão vendidas ou licenciadas a terceiros, evitando assim riscos de violação de propriedade intelectual.
A ausência de uma API oficial publicada pela NVIDIA significa que a responsabilidade pela infraestrutura de inferência recai inteiramente sobre a equipe de implantação. Isso inclui a gestão de filas de processamento, o balanceamento de carga e a monitorização do desempenho da GPU. O custo de capital para adquirir hardware capaz de suportar 20 bilhões de parâmetros é substancial, e os custos operacionais de energia e manutenção devem ser considerados no orçamento de longo prazo. A falta de um serviço gerenciado simplifica a integração, mas aumenta a complexidade técnica e o risco de falhas operacionais se a infraestrutura não for dimensionada corretamente.
Considerações de custo e implantação
Fatores a considerar ao integrar o modelo na infraestrutura própria.
| Elemento | Detalhe |
|---|---|
| Licença | OpenMDW 1.1 (verificar termos comerciais) |
| API oficial | Não publicada; implantação própria |
| Hardware | GPU de alto desempenho (recomendado para 20B parâmetros) |
| Custo direto | Infraestrutura própria (GPU, RAM, Armazenamento) |
| Custo indireto | Desenvolvimento de pipeline, integração e manutenção |
Limitações, segurança e viés
O documento BIAS.md oficial confirma que o modelo opera exclusivamente sobre renders sintéticos e imagens geradas por máquina de componentes de PCB inanimados. Não há sujeitos humanos nos dados de treinamento ou avaliação, e não são utilizadas etiquetas de atributos humanos como sinal de supervisão. Isso elimina riscos de viés demográfico, mas não garante a ausência de vieses técnicos relacionados à variabilidade de iluminação real não coberta pelos 364 pares de treinamento.
A segurança e a privacidade são abordadas em documentos específicos (SAFETY.md, PRIVACY.md) incluídos no repositório. Dado que o modelo processa imagens de componentes eletrônicos, os riscos de privacidade são mínimos, mas os riscos de segurança estão relacionados à integridade do pipeline de inspeção: se o modelo introduzir artefatos que imitam defeitos, pode gerar falsos positivos no sistema de controle de qualidade.
Embora o modelo não apresente riscos de viés demográfico devido à ausência de sujeitos humanos nos dados de treinamento, a variabilidade técnica da iluminação real pode não estar completamente coberta pelos 364 pares de treinamento. Isso significa que o modelo pode falhar em generalizar para condições de iluminação não vistas durante o aprendizado, resultando em transformações inadequadas que podem mascarar defeitos reais ou criar artefatos que imitam falhas. A validação contínua com dados de produção é essencial para identificar essas lacunas e ajustar o pipeline de inspeção conforme necessário.
Os riscos de segurança estão intrinsecamente ligados à integridade do pipeline de controle de qualidade. Se o modelo introduzir artefatos que se assemelhem a defeitos comuns, como pontes de solda ou componentes ausentes, o sistema de inspeção pode gerar falsos positivos, levando a paradas de produção desnecessárias e custos de retrabalho. Por outro lado, se a transformação de estilo suavizar defeitos reais, pode haver falsos negativos, permitindo que produtos defeituosos cheguem ao cliente. A implementação de uma etapa de validação humana ou de um segundo nível de inspeção é, portanto, uma medida de mitigação crítica para garantir a confiabilidade do processo.
Critérios práticos de escolha
Este modelo é adequado para equipes de visão computacional industrial que precisam aumentar a diversidade de iluminação em seus conjuntos de dados de treinamento para inspeção de PCBs. Não é adequado para equipes que busquem uma solução de detecção de defeitos 'pronta para uso', pois o modelo apenas gera imagens modificadas, não classifica defeitos.
A decisão de adotar este modelo deve basear-se na disponibilidade de hardware GPU suficiente, na capacidade de integrar o pipeline de inferência no fluxo de trabalho existente e na disposição de realizar uma avaliação rigorosa da qualidade das imagens geradas antes de usá-las para treinar classificadores.
A decisão de adotar este modelo deve ser fundamentada em uma análise de custo-benefício que considere não apenas o custo de infraestrutura, mas também o tempo e os recursos necessários para a integração e validação. Equipes que já possuem pipelines de visão computacional estabelecidos e hardware GPU disponível podem se beneficiar mais desta solução, pois a curva de aprendizado para a integração é menor. Por outro lado, equipes que buscam uma solução rápida e sem necessidade de infraestrutura própria podem encontrar o modelo inadequado, dado que ele não oferece uma API gerenciada nem uma solução de detecção de defeitos pronta para uso.
A disponibilidade de hardware GPU suficiente é um pré-requisito inegociável para a implantação. A capacidade de integrar o pipeline de inferência no fluxo de trabalho existente depende da compatibilidade dos formatos de entrada e saída com os sistemas de aquisição de imagens atuais. A disposição para realizar uma avaliação rigorosa da qualidade das imagens geradas é igualmente importante, pois a eficácia do modelo em melhorar a robustez dos classificadores de defeitos não é garantida pela documentação pública, mas deve ser comprovada empiricamente em cada contexto de aplicação específico.
Processo de integração recomendado
Etapas para integrar o modelo em um pipeline de inspeção.
- 011. Verificar a licença OpenMDW 1.1 para o uso comercial previsto.
- 022. Preparar o hardware GPU com memória suficiente para os 20B parâmetros.
- 033. Implementar o pipeline de inferência com a instrução fixa.
- 044. Gerar um conjunto de imagens de teste a partir de renders sintéticos.
- 055. Avaliar visualmente a qualidade da transformação de estilo.
- 066. Treinar um classificador de defeitos com as imagens aumentadas.
- 077. Validar o desempenho do classificador com revisão humana.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção