Identität und Zweck des Modells
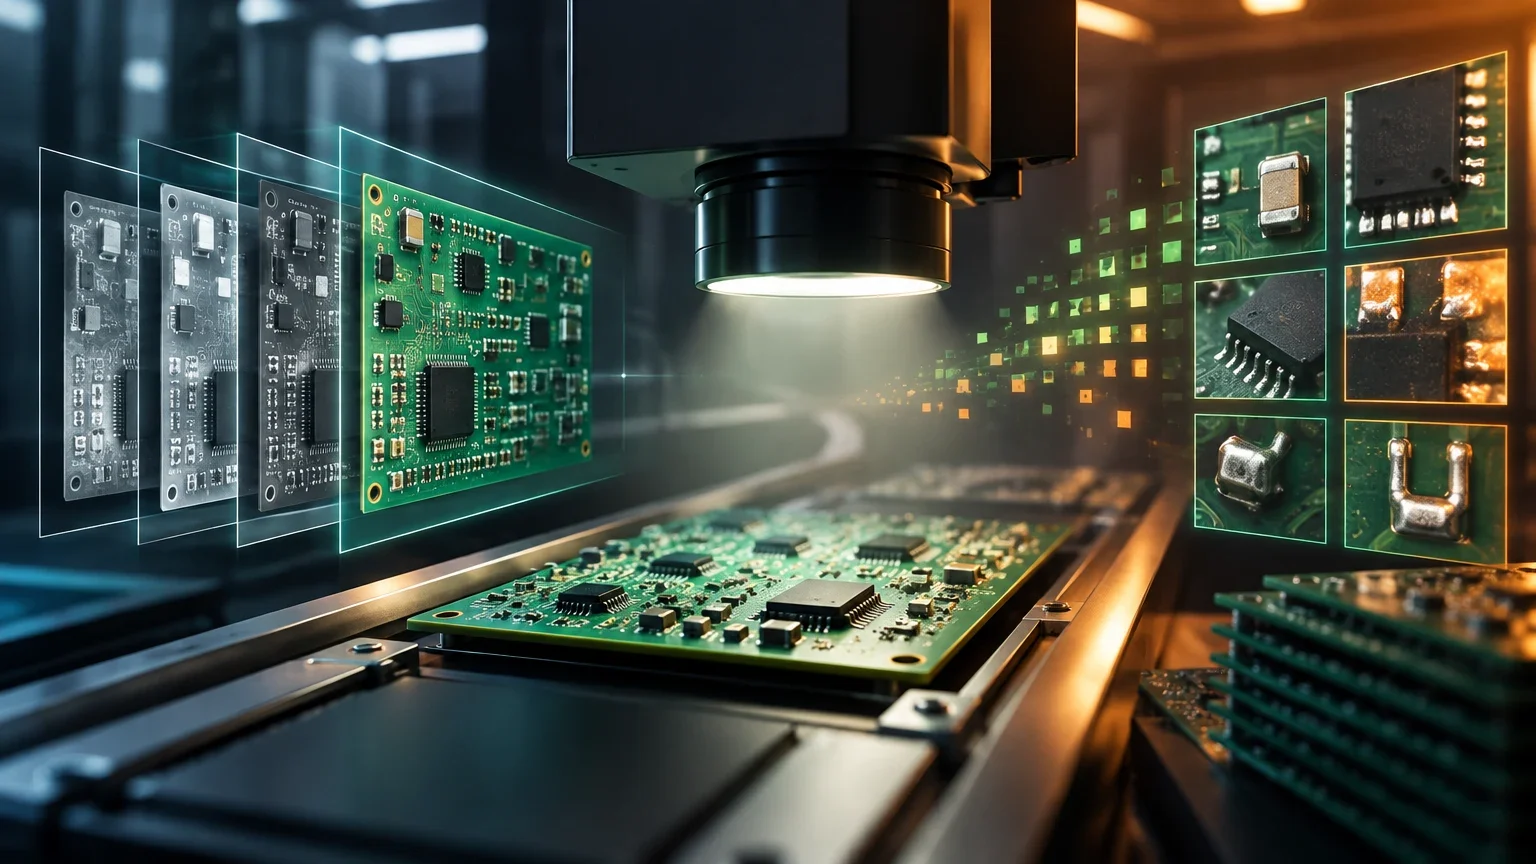
NVIDIA hat die Version 1.0.0 von CDF Sim2Real SMT Solderlight veröffentlicht, ein Bildbearbeitungsmodell, das speziell für die Pipeline zur Datenaugmentation bei der Inspektion von gedruckten Schaltungen (PCB) entwickelt wurde. Seine Hauptfunktion besteht darin, synthetische Ausschnitte elektronischer Komponenten, die durch Renderings in Omniverse erzeugt wurden, in einen Beleuchtungsstil zu transformieren, der die Bedingungen einer automatischen optischen Inspektion (AOI) simuliert.
Im Gegensatz zu generischen Text-zu-Bild-Modellen arbeitet dieses Modell mit einer festen englischen Anweisung, die die Stil- und Lichttransformation beschreibt. Der Benutzer steuert den semantischen Inhalt des Bildes nicht über freie Prompts, sondern das Modell konzentriert sich auf die visuelle Domänenübertragung (Sim-to-Real), um die Robustheit nachgelagerter Defekt-Klassifizierer zu verbessern.
Die spezifische Ausrichtung auf die Simulation von AOI-Beleuchtungsbedingungen bedeutet, dass das Modell darauf optimiert ist, die charakteristischen Lichtreflexionen, Schattenwürfe und Kontrastverhältnisse nachzubilden, die in industriellen Inspektionsumgebungen typisch sind. Diese visuelle Domänenübertragung zielt darauf ab, die Lücke zwischen der perfekten, artefaktfreien Darstellung synthetischer Renderings und der komplexen, oft ungleichmäßigen Beleuchtung realer Fertigungslinien zu schließen, was für die Generalisierungsfähigkeit nachgelagerter Klassifizierer von entscheidender Bedeutung ist.
Da das Modell keine freien Prompts akzeptiert, ist die Kontrolle über den semantischen Inhalt der generierten Bilder vollständig auf die Eingabedaten beschränkt. Dies stellt sicher, dass die geometrische Integrität der abgebildeten PCB-Komponenten erhalten bleibt, während ausschließlich die visuellen Eigenschaften der Beleuchtung und des Stils transformiert werden. Diese Einschränkung ist ein bewusster Designentscheid, um die Zuverlässigkeit der Datenaugmentation zu gewährleisten und unerwünschte semantische Veränderungen zu vermeiden, die die Trainingsdaten für die Defekterkennung verfälschen könnten.
Architektur und technische Spezifikationen
Das Modell leitet sich von Qwen-Image-Edit ab, aber das verteilte Paket ist kein unabhängiger LoRA-Adapter, sondern eine vollständige Pipeline mit fusionierten Gewichten. Laut dem offiziellen Datenblatt schätzt die Architektur insgesamt etwa 20 Milliarden Parameter, von denen ungefähr 170 Millionen auf die für diese spezifische Aufgabe trainierten und fusionierten LoRA-Gewichte entfallen.
Die Eingabe besteht aus einem RGB-Bild eines PCB-Komponenten und der festen Anweisung. Die Ausgabe ist ein RGB-PNG-Bild. Es ist entscheidend zu beachten, dass das Training mit einer Zielfläche von 262.144 Pixeln durchgeführt wurde, was quadratischen Ausschnitten von 512 × 512 Pixeln (0,262 Megapixel) entspricht. Die Verwendung von Auflösungen, die signifikant von dieser abweichen, kann die Qualität des angewendeten Stils beeinträchtigen.
Die Fusion der LoRA-Gewichte in die Basisarchitektur von Qwen-Image-Edit vereinfacht den Deployment-Prozess erheblich, da keine zusätzliche Adapter-Verwaltung oder dynamische Gewichtsladung zur Laufzeit erforderlich ist. Dies führt zu einer konsistenteren Inferenzleistung und reduziert die Komplexität der Software-Stack-Integration, da das Modell als eigenständige Einheit behandelt werden kann, die die spezifischen Merkmale der PCB-Beleuchtung bereits in ihren Kernen parametrisiert.
Die Festlegung der Trainingsfläche auf 262.144 Pixel (512x512) legt den optimalen Betriebsbereich für die Stiltransformation fest. Abweichungen von dieser Auflösung können dazu führen, dass die fein abgestimmten Beleuchtungseffekte nicht korrekt skaliert werden, was zu einer Degradation der visuellen Qualität führt. Daher ist es ratsam, die Eingabebilder vor der Verarbeitung auf die empfohlene Größe zu normalisieren, um die bestmögliche Übereinstimmung mit den Bedingungen zu gewährleisten, unter denen das Modell trainiert wurde.
Wichtige Spezifikationen des Modells
Zusammenfassung der in der offiziellen Dokumentation verifizierten technischen Parameter.
| Parameter | Wert / Beschreibung |
|---|---|
| Version | 1.0.0 |
| Veröffentlichungsdatum | 20. Oktober 2026 |
| Basis | Qwen-Image-Edit (fusionierte Gewichte) |
| Gesamtparameter | ~20 Mrd. (geschätzt) |
| LoRA-Parameter | ~170 Mio. (fusioniert) |
| Trainingsfläche | 262.144 Pixel (512x512) |
| Modalitäten | Eingabe: Bild + fester Text; Ausgabe: Bild |
Trainingsmethodik und Bewertung
NVIDIA gibt an, dass das Training mit 364 Datenpaaren durchgeführt wurde. Die veröffentlichte Bewertung ist qualitativ und visuell, ohne eine in der öffentlichen Dokumentation dokumentierte unabhängige Validierungs- oder Testpartition. Es sind keine menschlichen Referenzfotos im Repository enthalten, was die Fähigkeit einschränkt, die Ausgabe direkt mit echten Fabrikbildern zu vergleichen, ohne auf eigene Daten zuzugreifen.
Es werden keine numerischen Qualitätsbewertungen für industrielle Anwendungen (wie F1-Score oder Defekterkennungsgenauigkeit) für dieses spezifische Modell veröffentlicht. Daher können die Benchmarks des Basismodells Qwen-Image-Edit nicht übernommen werden, da die LoRA-Anpassung das Verhalten des Modells für die spezifische Aufgabe der PCB-Beleuchtung signifikant verändert.
Die begrenzte Größe des Trainingsdatensatzes von 364 Paaren unterstreicht die Notwendigkeit einer sorgfältigen Validierung der Modellleistung in der eigenen Umgebung. Da keine unabhängige Testpartition in der öffentlichen Dokumentation dokumentiert ist, bleibt die tatsächliche Generalisierungsfähigkeit des Modells auf ungesicherte Beleuchtungsbedingungen unklar. Teams sollten daher eigene Validierungsdatensätze erstellen, die eine breite Palette realer AOI-Beleuchtungsszenarien abdecken, um die Robustheit der Transformation zu bewerten.
Das Fehlen numerischer Qualitätsmetriken wie F1-Scores oder Defekterkennungsgenauigkeiten für dieses spezifische Modell bedeutet, dass die Leistungsbewertung primär auf qualitativen visuellen Inspektionen und der Überprüfung der nachgelagerten Klassifizierer basiert. Die Benchmarks des Basismodells Qwen-Image-Edit können nicht direkt übertragen werden, da die LoRA-Anpassung das Verhalten des Modells für die spezifische Aufgabe der PCB-Beleuchtung signifikant verändert hat, was eine eigenständige Bewertung erfordert.
Lizenz, Kosten und Deployment
Die Modellgewichte sind öffentlich unter der Lizenz OpenMDW 1.1 verfügbar. Es ist wichtig zu unterscheiden, dass die ursprünglichen Komponenten von Qwen-Image-Edit die Apache 2.0-Lizenz beibehalten, aber das spezifische NVIDIA-Paket den Bedingungen von OpenMDW 1.1 unterliegt, die für spezifische kommerzielle Anwendungen geprüft werden müssen.
Es gibt keine offiziell von NVIDIA veröffentlichte API-Gebühr für dieses Modell. Die Deployment-Kosten werden als eigene Infrastruktur übernommen: Es müssen GPU, Videomemory, Speicher und Betrieb eingeplant werden. Da das Modell über ~20 Mrd. Parameter verfügt, ist High-Performance-Hardware für die Inferenz erforderlich, was für Teams ohne GPU-Cluster erhebliche Kapital- und Betriebskosten impliziert.
Die Unterscheidung zwischen der Apache 2.0-Lizenz der ursprünglichen Qwen-Image-Edit-Komponenten und der OpenMDW 1.1-Lizenz des spezifischen NVIDIA-Pakets ist für die juristische Compliance von zentraler Bedeutung. Während die Basisarchitektur unter einer permissiven Lizenz steht, unterliegen die spezifischen, für die PCB-Inspektion trainierten und fusionierten Gewichte den Bedingungen von OpenMDW 1.1, die für kommerzielle Anwendungen sorgfältig geprüft werden müssen, um potenzielle Einschränkungen oder Auflagen zu identifizieren.
Da keine offizielle API-Gebühr veröffentlicht wurde, liegt die finanzielle Last des Deployments vollständig auf der eigenen Infrastruktur. Die Notwendigkeit, High-Performance-GPUs für die Inferenz eines Modells mit etwa 20 Milliarden Parametern bereitzustellen, impliziert erhebliche Kapital- und Betriebskosten. Teams ohne bestehende GPU-Cluster müssen diese Kosten in ihre Budgetplanung einbeziehen und die Wirtschaftlichkeit des eigenen Deployments im Vergleich zu potenziellen alternativen Lösungen oder Cloud-Diensten bewerten.
Kosten- und Deployment-Erwägungen
Faktoren, die bei der Integration des Modells in die eigene Infrastruktur zu berücksichtigen sind.
| Element | Detail |
|---|---|
| Lizenz | OpenMDW 1.1 (kommerzielle Bedingungen prüfen) |
| Offizielle API | Nicht veröffentlicht; eigenes Deployment |
| Hardware | High-Performance-GPU (empfohlen für 20 Mrd. Parameter) |
| Direkte Kosten | Eigene Infrastruktur (GPU, RAM, Speicher) |
| Indirekte Kosten | Pipeline-Entwicklung, Integration und Wartung |
Einschränkungen, Sicherheit und Bias
Das offizielle BIAS.md-Dokument bestätigt, dass das Modell ausschließlich auf synthetischen Renderings und maschinengenerierten Bildern unbelebter PCB-Komponenten arbeitet. Es gibt keine menschlichen Subjekte in den Trainings- oder Bewertungsdaten, und es werden keine menschlichen Attribut-Labels als Überwachungssignal verwendet. Dies eliminiert demografische Verzerrungsrisiken, garantiert aber nicht die Abwesenheit technischer Verzerrungen im Zusammenhang mit der Variabilität der realen Beleuchtung, die nicht durch die 364 Trainingspaare abgedeckt ist.
Sicherheit und Privatsphäre werden in spezifischen Dokumenten (SAFETY.md, PRIVACY.md) behandelt, die im Repository enthalten sind. Da das Modell Bilder elektronischer Komponenten verarbeitet, sind die Privatsphärenrisiken minimal, aber die Sicherheitsrisiken sind mit der Integrität der Inspektionspipeline verbunden: Wenn das Modell Artefakte einführt, die Defekte imitieren, könnte dies zu Fehlpositiven im Qualitätskontrollsystem führen.
Obwohl das Modell ausschließlich auf synthetischen Renderings und maschinengenerierten Bildern unbelebter PCB-Komponenten trainiert wurde, was demografische Verzerrungsrisiken eliminiert, bleiben technische Verzerrungen im Zusammenhang mit der Variabilität der realen Beleuchtung bestehen. Die 364 Trainingspaare decken möglicherweise nicht alle möglichen Beleuchtungsbedingungen in einer realen Fabrikumgebung ab, was zu einer ungleichmäßigen Leistung des Modells bei der Simulation bestimmter Lichtszenarien führen kann.
Die Sicherheitsrisiken sind eng mit der Integrität der Inspektionspipeline verbunden. Wenn das Modell Artefakte einführt, die echte Defekte imitieren oder umgekehrt, könnte dies zu Fehlpositiven oder Fehlnegativen im Qualitätskontrollsystem führen. Daher ist es entscheidend, dass die Ausgabe des Modells immer durch eine Stufe der menschlichen Validierung oder eine zweite, unabhängige Ebene in der Pipeline überprüft wird, um die Zuverlässigkeit der finalen Qualitätsentscheidung zu gewährleisten.
Praktische Auswahlkriterien
Dieses Modell ist für Teams der industriellen Bildverarbeitung geeignet, die die Beleuchtungsdiversität in ihren Trainingsdatensätzen für die PCB-Inspektion erhöhen müssen. Es ist nicht für Teams geeignet, die eine 'out-of-the-box'-Lösung für die Defekterkennung suchen, da das Modell nur modifizierte Bilder generiert und keine Defekte klassifiziert.
Die Entscheidung, dieses Modell zu adoptieren, sollte auf der Verfügbarkeit ausreichender GPU-Hardware, der Fähigkeit, die Inferenzpipeline in den bestehenden Workflow zu integrieren, und der Bereitschaft, die Qualität der generierten Bilder vor der Verwendung für das Training von Klassifizierern rigoros zu bewerten, basieren.
Die Eignung des Modells für Teams der industriellen Bildverarbeitung hängt stark von der Fähigkeit ab, die Inferenzpipeline in den bestehenden Workflow zu integrieren und die Qualität der generierten Bilder rigoros zu bewerten. Es ist nicht als 'out-of-the-box'-Lösung für die Defekterkennung konzipiert, sondern dient ausschließlich der Datenaugmentation, um die Beleuchtungsdiversität in den Trainingsdatensätzen zu erhöhen und so die Robustheit der nachgelagerten Klassifizierer zu verbessern.
Die Entscheidung für die Adoption sollte auf einer gründlichen Analyse der verfügbaren GPU-Hardware, der Komplexität der Pipeline-Integration und der Bereitschaft zur Durchführung einer umfassenden Validierung basieren. Teams müssen sicherstellen, dass sie über die technischen Ressourcen und das Fachwissen verfügen, um die OpenMDW 1.1-Lizenz zu prüfen, die Hardware vorzubereiten und die Leistung des Modells in der eigenen Umgebung zu validieren, bevor es für das Training von Klassifizierern eingesetzt wird.
Empfohlener Integrationsprozess
Schritte zur Integration des Modells in eine Inspektionspipeline.
- 011. Die OpenMDW 1.1-Lizenz für die beabsichtigte kommerzielle Nutzung prüfen.
- 022. Die GPU-Hardware mit ausreichend Speicher für die 20 Mrd. Parameter vorbereiten.
- 033. Die Inferenzpipeline mit der festen Anweisung implementieren.
- 044. Einen Testdatensatz aus synthetischen Renderings generieren.
- 055. Die Qualität der Stiltransformation visuell bewerten.
- 066. Einen Defekt-Klassifizierer mit den augmentierten Bildern trainieren.
- 077. Die Leistung des Klassifizierers durch menschliche Prüfung validieren.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen