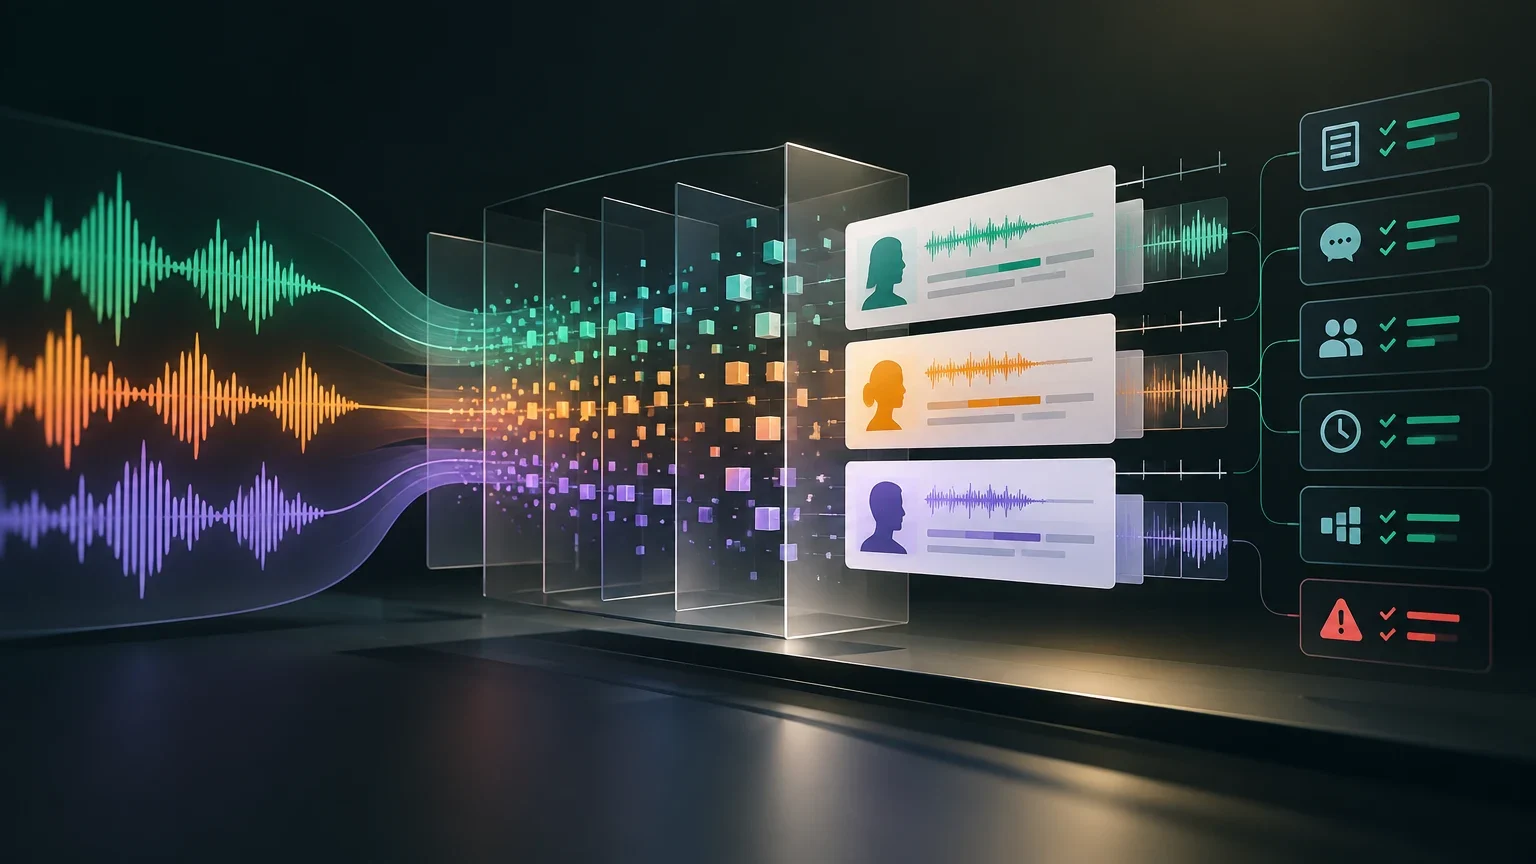
A unidade de avaliação não é apenas o modelo
Uma avaliação ASR do GPT‑Transcribe deve começar definindo o que está sendo testado. O nome comercial ou conhecido do modelo, por si só, não identifica um sistema reproduzível. A saída pode depender do identificador exato ou snapshot do modelo, da data de execução, do endpoint, dos parâmetros da solicitação, do formato solicitado, do pré-processamento do áudio e de qualquer camada posterior que acrescente falantes, segmentos ou campos estruturados.
Essa distinção importa especialmente quando o produto precisa de mais do que texto contínuo. Uma aplicação de suporte pode precisar saber quem disse cada frase; uma ferramenta de revisão pode precisar abrir o áudio no segundo exato de uma declaração; um processo de conformidade pode exigir que um identificador, um valor ou uma negação sejam preservados sem alterações. Nesses casos, uma transcrição aparentemente boa pode ser insuficiente se a falha ocorrer no dado que aciona uma busca, uma citação, uma classificação ou uma decisão humana.
A documentação da OpenAI diferencia um modelo de transcrição com diarização integrada, que associa segmentos a falantes, de uma transcrição sem essa capacidade. Portanto, não convém atribuir diarização a um teste cuja configuração não a solicitou ou que a obtém de uma ferramenta externa. Da mesma forma, a documentação da Microsoft para sua oferta de voz descreve opções de transcrição e diarização próprias desse serviço; ela não é uma especificação intercambiável de outra API ou configuração.
O registro de cada execução deve incluir uma ficha do sistema. No mínimo: identificador exato do modelo, data e região ou ambiente quando aplicável, modalidade de entrada, idioma ou detecção de idioma, parâmetros utilizados, versão do pré-processamento, formato da resposta, lógica de tentativas e versões das ferramentas de pontuação. Também deve declarar se a diarização, os tempos ou a normalização são produzidos dentro do serviço avaliado ou em uma etapa posterior. Sem essa ficha, uma diferença entre dois resultados não pode ser atribuída com segurança ao modelo.
Por que o WER não basta para decidir
A taxa de erro de palavras, ou WER, é uma medida central para comparar hipóteses de texto com uma referência. Ela é calculada a partir de substituições, exclusões e inserções, divididas pelo número de palavras de referência. Seu valor está em forçar o alinhamento sistemático de uma saída com uma verdade de referência e em permitir decompor o erro. Porém, ela não expressa, por si só, o dano operacional de cada erro.
Dois sistemas podem ter o mesmo WER e se comportar de maneiras muito diferentes. Substituir uma hesitação pode ter pouco efeito em uma busca. Omitir o “não” em uma autorização, confundir “quinze” com “cinquenta”, alterar um nome ou apagar parte de um identificador pode mudar o sentido de uma conversa e modificar o resultado de um fluxo posterior. Um WER agregado também pode esconder que o desempenho cai em chamadas com ruído, sotaques pouco representados, conversas sobrepostas ou canais telefônicos.
A definição de palavra é outra fonte frequente de resultados não comparáveis. Pontuação, maiúsculas, números escritos em algarismos ou por extenso, abreviações, datas, moedas e hesitações podem alterar a contagem. A normalização pode ser apropriada para medir a inteligibilidade geral, mas é inadequada se eliminar uma diferença relevante para o produto. Por exemplo, normalizar valores monetários antes da pontuação pode ocultar uma falha que um extrator de dados sofreria.
Convém manter ao menos duas visões. A primeira é uma pontuação textual normalizada, documentada e estável, útil para comparar a qualidade ASR geral. A segunda preserva ou volta a avaliar as formas críticas para o caso de uso: números, nomes, negações, códigos, datas, valores e termos regulados. A segunda visão não substitui o WER; ela responde a outra pergunta: se o sistema preserva os elementos cujo erro tem custo desproporcional.
A taxa de erro de caracteres pode complementar o WER em idiomas, nomes próprios ou identificadores nos quais a fronteira entre palavras não oferece sinal suficiente. Ainda assim, ela também não deve ser apresentada como uma medida universal de utilidade. A seleção das métricas deve decorrer da saída e do risco do fluxo, e não da disponibilidade de uma ferramenta de pontuação.
Matriz mínima de métricas e decisões
| Dimensão | Medida principal | O que pode ocultar | Uso recomendado |
|---|---|---|---|
| Texto geral | WER; CER quando fornecer sinal adicional | Impacto desigual entre palavras | Comparar fidelidade de transcrição sob regras fixas |
| Dados críticos | Taxa de erro ponderada por entidade e severidade | Erros não anotados como críticos | Controlar nomes, valores, datas, negações e identificadores |
| Falantes | DER e, se adotado, JER | Política de sobreposição, collar e regiões excluídas | Validar atribuição em diálogos e reuniões |
| Tempo | Desvio de início e fim; cobertura dentro da tolerância | Segmentos corretos com limites inutilizáveis | Validar citações, clipes e automações temporais |
| Estrutura | Taxa de respostas válidas e de campos completos | Texto correto em uma resposta rejeitada pelo consumidor | Medir a integração com o contrato downstream |
Medir falantes, tempos, segmentos e idioma como saídas independentes
A diarização responde à pergunta “quem falou quando”; ela não equivale ao reconhecimento das palavras. Sua avaliação requer uma referência temporal de falantes e uma política explícita de pontuação. As ferramentas de diarização documentam que o DER integra erro de falante, falsos alarmes de fala e fala omitida. Elas também permitem opções que modificam o resultado, como uma margem temporal de tolerância — collar —, a inclusão ou exclusão de fala sobreposta e as regiões avaliáveis. Um DER sem essas decisões metodológicas não é suficientemente interpretável para comparar sistemas.
A métrica pode penalizar fenômenos distintos. Um sistema pode detectar a fala, mas trocar etiquetas entre interlocutores; outro pode perder intervenções curtas; outro pode atribuir bem turnos limpos e falhar justamente quando duas pessoas falam ao mesmo tempo. O relatório deve separar, quando possível, componentes do erro e resultados de áudio com e sem sobreposição. Além disso, deve declarar como são tratados falantes desconhecidos, mudanças de canal e silêncios.
As marcações de tempo precisam de uma métrica ligada à ação que o produto realizará. Se uma pessoa abre um clipe a partir de uma frase, pode-se medir o desvio absoluto entre os inícios e fins previstos e os de referência. Se o requisito é localizar uma evidência, pode ser mais pertinente a proporção de segmentos que ficam dentro de uma tolerância previamente aprovada. Uma média isolada pode ocultar uma cauda de erros extremos: informe também percentis e o pior trecho relevante por estrato.
A segmentação é diferente do alinhamento palavra a palavra. Um sistema pode localizar palavras aproximadamente bem e, ainda assim, agrupar várias intervenções de maneira pouco útil em um único segmento. Meça segmentos excessivamente longos, cortes no meio de uma frase, duplicações nas fronteiras, omissões e cobertura de fala. Se a interface depende de um segmento por intervenção ou de citações curtas, defina essas condições como testes de aceitação.
O idioma merece uma verificação própria quando a aplicação usa detecção, roteia por idioma ou aplica vocabulários e regras distintos. Não basta observar que uma transcrição parece legível. Devem ser registrados o idioma esperado, o idioma declarado pelo sistema quando disponível, o idioma de saída e os erros de alternância de idioma em conversas multilíngues. A cobertura do corpus deve refletir os idiomas e variedades que o produto pretende aceitar; uma amostra monolíngue não justifica conclusões fora dela.
Construir um corpus que represente o risco, e não apenas o volume
O corpus de avaliação deve ser uma amostra deliberada das condições que o sistema encontrará, e não uma coleção conveniente de áudios limpos. Defina estratos antes de executar o modelo: domínio da conversa, idioma e variedade, canal de captura, ruído, reverberação, qualidade do microfone, número de participantes, sobreposição, duração, velocidade de fala e presença de vocabulário especializado. Acrescente estratos para os eventos de alto impacto definidos pelo negócio, mesmo que sejam pouco frequentes.
A alocação de tamanho não precisa ser uniforme. Os estratos com maior exposição ou custo de erro merecem uma amostra suficiente para revelar diferenças práticas. Um conjunto pequeno de conversas que contenham valores, autorizações ou dados contratuais pode ser mais informativo do que muitas horas adicionais de conversa rotineira. Trata-se de uma decisão de risco e cobertura, não de uma afirmação de que um estrato é mais difícil por definição.
Separe dados de desenvolvimento e de avaliação. Os primeiros servem para decidir regras de normalização, limiares, pré-processamento e tratamento de erros. Os segundos permanecem congelados até a comparação que embasa uma decisão. Se o sistema for ajustado após a análise do conjunto de avaliação, o resultado posterior deve ser apresentado como desenvolvimento ou validado em um novo conjunto. A metodologia de avaliação do NIST enfatiza o uso de protocolos, dados e software de pontuação comuns, além de descrições do sistema, para que os resultados sejam comparáveis.
A referência exige o mesmo cuidado que a hipótese. Para cada amostra, ela pode incluir transcrição literal conforme um guia escrito, falantes com intervalos temporais, segmentos e etiquetas de entidades críticas. O guia deve resolver algarismos versus palavras, hesitações, risadas, fala ininteligível, interrupções, pronúncias duvidosas, empréstimos linguísticos e sobreposição. Se os anotadores aplicarem regras diferentes, a métrica poderá medir inconsistências de anotação em vez de diferenças do ASR.
Use dupla anotação ou revisão independente em uma fração priorizada: áudios complexos, exemplos de alto impacto e divergências previsíveis. Registre os desacordos, resolva-os com uma política definida e preserve a versão da referência. A concordância entre anotadores não torna a referência perfeita, mas revela onde a conclusão é incerta. Não classifique como erro do modelo um caso para o qual a referência também não oferece uma resposta estável.
Processo reproduzível para preparar o corpus
- 01Definir a população-alvo, os riscos e os estratos antes da amostragem.
- 02Atribuir identificadores estáveis aos áudios, às versões de referência e às regras de anotação.
- 03Separar conjuntos de desenvolvimento, validação operacional e avaliação congelada.
- 04Anotar texto, falantes, tempos e entidades críticas de acordo com um guia versionado.
- 05Revisar de forma independente uma amostra orientada ao risco e documentar desacordos.
- 06Publicar uma ficha do corpus com cobertura, exclusões, distribuição por estrato e limitações.
Executar e pontuar sem introduzir vantagens acidentais
A execução comparável fornece o mesmo arquivo ou a mesma representação de áudio a cada alternativa. Se for necessário converter o formato, remover silêncios, separar canais ou reduzir ruído, aplique o mesmo procedimento a todos os sistemas ou avalie explicitamente cada variante como parte de um sistema completo. Preserve os arquivos de entrada, suas verificações de integridade quando a política permitir e os registros técnicos necessários para repetir o teste.
Registre as respostas originais antes de normalizá-las para a pontuação. Diferencie erros técnicos — solicitações com falha, tempos de espera, respostas truncadas, limites de tamanho ou formatos não analisáveis — de erros de reconhecimento. Excluir silenciosamente falhas técnicas melhora artificialmente uma métrica de texto e remove informação que pode bloquear o produto. Informe uma taxa de conclusão, uma taxa de resposta analisável e uma taxa de saída válida para o esquema consumidor.
A taxa de validade estrutural é decisiva quando um componente posterior espera campos, segmentos, identificadores de falante ou tempos com tipos específicos. Defina o que conta como válido: resposta analisável, campos obrigatórios presentes, valores dentro da faixa, ordem temporal coerente e correspondência entre segmentos e texto, caso o contrato a exija. Valide primeiro contra o esquema e depois contra as regras semânticas do fluxo. Um objeto formalmente válido pode conter intervalos invertidos ou etiquetas de falante inutilizáveis.
Para WER e análise de alinhamento, utilize uma ferramenta de pontuação versionada e uma configuração comum. O toolkit SCTK do NIST é usado para pontuação de reconhecimento de voz e oferece mecanismos de comparação; seu uso não substitui a necessidade de declarar regras de normalização e filtros. Para diarização, declare a ferramenta, a versão, as regiões avaliáveis e todas as opções de collar e sobreposição. Mudanças de ferramenta ou de parâmetros podem produzir diferenças que não vêm do modelo.
As repetições só são necessárias se o serviço, o pré-processamento ou o ambiente puderem produzir resultados variáveis. Se uma solicitação for repetida, não calcule simplesmente a média das transcrições: informe a estabilidade da saída, as divergências e a regra adotada. Se não houver repetições, indique isso como limitação. Também convém separar latência e disponibilidade da qualidade ASR: ambas podem importar para o produto, mas respondem a perguntas diferentes.
Registro por execução e tratamento de falhas
| Elemento | Registro mínimo | Regra de relatório |
|---|---|---|
| Sistema | Modelo ou snapshot, parâmetros, pré-processamento e formato | Uma linha ou identificador por configuração completa |
| Entrada | ID do áudio, estrato, duração e versão de referência | A mesma entrada para todas as alternativas |
| Resultado técnico | Sucesso, erro, repetição, truncamento e resposta bruta | Não excluir do denominador sem declarar |
| Pontuação | Ferramenta, versão, normalização e opções | Manter fixo na comparação |
| Saída estruturada | Esquema válido, campos obrigatórios e consistência temporal | Reportar junto com as métricas ASR |
Apresentar resultados que permitam decidir e reverter
O relatório principal deve mostrar resultados agregados, mas não deve terminar aí. Apresente cada métrica por estrato, por severidade da entidade crítica e por fluxo afetado. Inclua denominadores: número de áudios, duração, número de palavras de referência, quantidade de entidades e minutos de fala anotada, conforme o caso. Sem denominadores, uma taxa não permite estimar cobertura nem estabilidade.
Acompanhe as estimativas com incerteza. É possível usar intervalos obtidos por reamostragem em unidades apropriadas, como arquivos ou conversas, desde que o método seja documentado. Evite tratar palavras correlacionadas do mesmo áudio como observações independentes sem avisar. Quando o tamanho de uma categoria crítica for pequeno, comunique a contagem e a incerteza, em vez de formular conclusões fortes a partir de poucas ocorrências.
Casos representativos ajudam a interpretar uma tabela, mas não devem ser escolhidos apenas por serem favoráveis ou chamativos. Selecione exemplos de cada padrão importante: melhoria clara, regressão, falha crítica, resposta estrutural inválida e caso ambíguo de referência. Preserve a possibilidade de auditoria interna com o áudio e as anotações, aplicando os controles de privacidade pertinentes.
Os limiares de decisão devem ser definidos antes de observar o resultado final ou, se forem definidos depois, marcados como exploratórios. Uma política pode promover uma versão quando ela atende simultaneamente aos limites de texto, entidades críticas, diarização, tempos e validade; permitir uma implantação restrita quando falha apenas em estratos excluídos do escopo; exigir revisão humana em casos de alto risco; ou bloquear a promoção quando surgem regressões materiais. Não existe um limiar universal: a tolerância depende do dano possível e dos controles posteriores.
Uma comparação negativa também não implica que o modelo seja inútil em todos os contextos. Ela pode revelar que uma configuração é adequada para notas internas, mas não para citações temporais, atribuição de falantes ou extração de decisões. A conclusão rigorosa delimita o escopo: qual corpus, versão, regras e data sustentam o resultado, e quais usos permanecem sem comprovação.
Porta de decisão antes da implantação
- 01Verificar que todas as execuções têm ficha do sistema, entradas idênticas e resultados técnicos completos.
- 02Confirmar que os mínimos de cobertura por estrato e por entidade crítica foram atendidos.
- 03Comparar cada métrica com seu limiar e revisar intervalos de incerteza, não apenas médias.
- 04Revisar manualmente regressões críticas e respostas estruturais inválidas.
- 05Promover, restringir, manter revisão humana ou bloquear de acordo com uma política documentada.
- 06Preservar a linha de base, os resultados e os critérios para detectar regressões em uma avaliação posterior.
Limites desta avaliação
Este guia avalia a saída ASR e sua adequação a um contrato de dados específico. Ele não demonstra, por si só, a qualidade de um resumo gerado a partir da transcrição, a correção de uma busca, a equidade de uma classificação, a experiência conversacional, a conformidade regulatória nem a segurança de ações automatizadas posteriores. Cada um desses componentes exige avaliação própria, ainda que dependa da transcrição.
Também não demonstra desempenho futuro fora do corpus testado. Mudanças de população, idioma, acústica, conteúdo, modelo, endpoint ou regras de normalização podem invalidar comparações anteriores. Repetir a avaliação após mudanças relevantes e monitorar amostras de produção com controles de privacidade ajuda a detectar essa deriva, mas não elimina a incerteza.
A conclusão operacional mais útil costuma ser condicional: sob um conjunto declarado de áudios, uma referência e uma política de pontuação, uma configuração preserva — ou não preserva — as propriedades necessárias para um fluxo específico. Essa formulação é menos chamativa do que uma única porcentagem de precisão, mas permite discutir riscos, controles e limites sem ocultar os erros que realmente interrompem o trabalho posterior.
Questões em aberto
- A denominação «GPT‑Transcribe» não identifica de forma inequívoca um modelo, snapshot, endpoint ou configuração; o relatório de avaliação deve registrar esses dados exatos.
- A disponibilidade de diarização, segmentos e marcações de tempo depende da configuração e do serviço utilizado; ela não deve ser presumida a partir do nome do produto.
- Os limiares aceitáveis para WER, DER, tempos ou validade de esquema não são universais e exigem uma decisão explícita baseada no caso de uso.
- Uma referência humana pode conter ambiguidades, especialmente em sobreposições, fala ininteligível, nomes e limites temporais; a dupla revisão reduz, mas não elimina, essa incerteza.
- Os resultados de um corpus específico não garantem desempenho em idiomas, sotaques, condições acústicas ou domínios que não estejam representados.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção