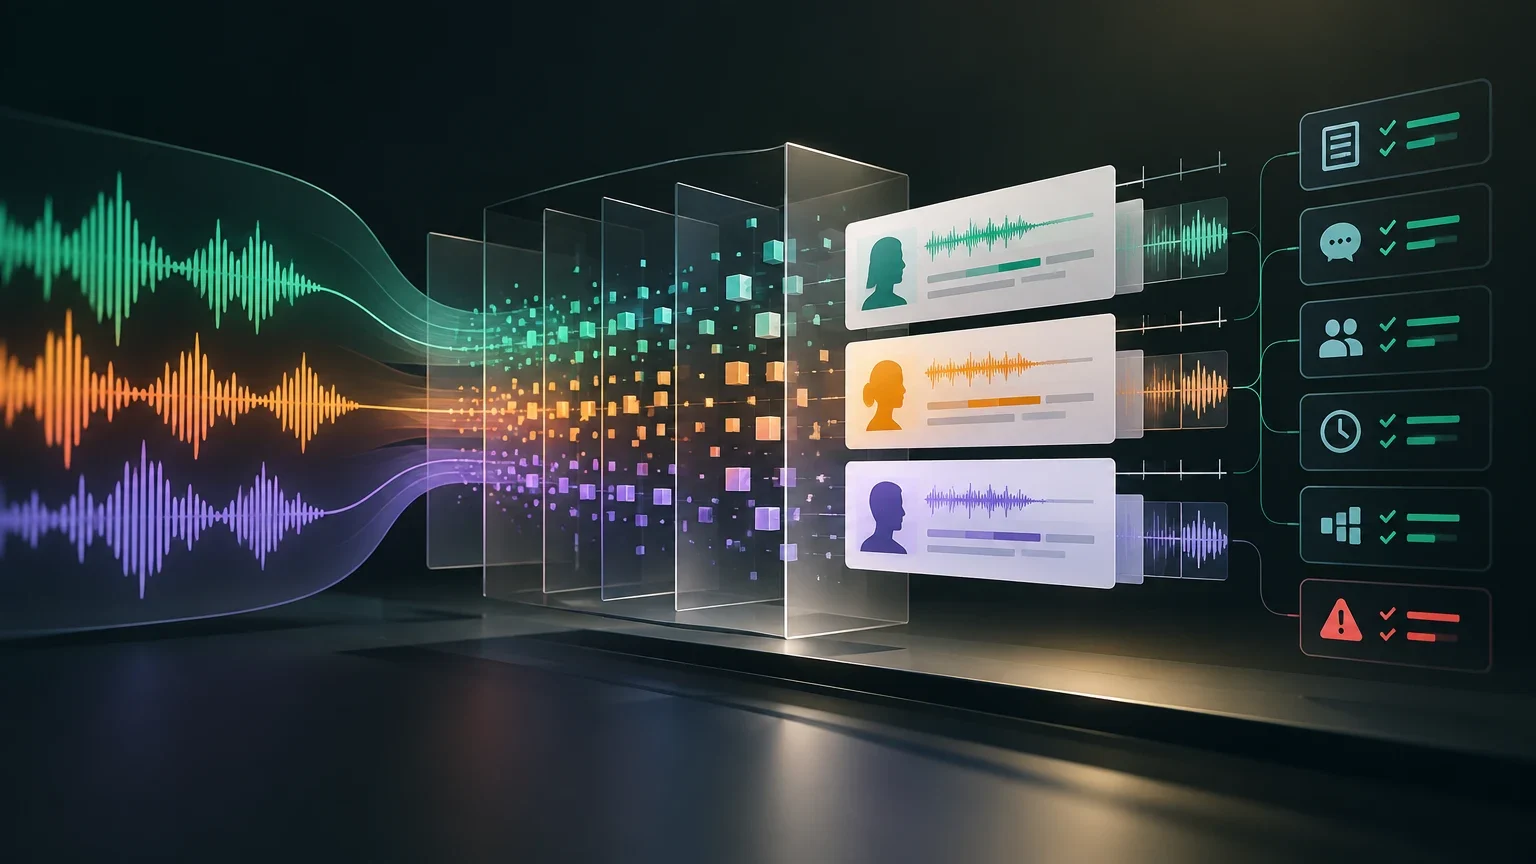
La unidad de evaluación no es solo el modelo
Una evaluación ASR de GPT‑Transcribe debe empezar por fijar qué se está probando. El nombre comercial o familiar del modelo no identifica por sí solo un sistema reproducible. La salida puede depender del identificador exacto o snapshot del modelo, de la fecha de ejecución, del endpoint, de los parámetros de la solicitud, del formato solicitado, del procesamiento previo del audio y de cualquier capa posterior que agregue hablantes, segmentos o campos estructurados.
Esta distinción importa especialmente cuando el producto necesita más que texto continuo. Una aplicación de soporte puede necesitar saber quién dijo cada frase; una herramienta de revisión puede necesitar abrir el audio en el segundo preciso de una declaración; un proceso de cumplimiento puede requerir conservar un identificador, un importe o una negación sin alteraciones. En esos casos, una transcripción aparentemente buena puede ser insuficiente si el fallo aparece en el dato que activa una búsqueda, una cita, una clasificación o una decisión humana.
La documentación de OpenAI distingue un modelo de transcripción con diarización integrada, que asocia segmentos con hablantes, de la transcripción sin esa capacidad. Por ello, no conviene atribuir diarización a una prueba cuya configuración no la solicitó o que la obtiene de una herramienta externa. Del mismo modo, la documentación de Microsoft para su oferta de voz describe opciones de transcripción y diarización propias de ese servicio; no es una especificación intercambiable de otra API o configuración.
El registro de cada corrida debe incluir una ficha de sistema. Como mínimo: identificador exacto del modelo, fecha y región o entorno si aplica, modalidad de entrada, idioma o detección de idioma, parámetros usados, versión del preprocesado, formato de respuesta, lógica de reintentos y versiones de las herramientas de puntuación. También debe declarar si la diarización, los tiempos o la normalización se producen dentro del servicio evaluado o en una etapa posterior. Sin esa ficha, una diferencia entre dos resultados no puede atribuirse con seguridad al modelo.
Por qué el WER no basta para decidir
La tasa de error de palabras, o WER, es una medida central para comparar hipótesis de texto con una referencia. Se calcula a partir de sustituciones, borrados e inserciones, divididos por el número de palabras de referencia. Su valor está en que obliga a alinear sistemáticamente una salida con una verdad de referencia y permite descomponer el error. Pero no expresa por sí sola el daño operativo de cada error.
Dos sistemas pueden tener el mismo WER y comportarse de forma muy distinta. Sustituir una muletilla puede tener poco efecto en una búsqueda. Omitir el “no” en una autorización, confundir “quince” con “cincuenta”, cambiar un nombre o borrar parte de un identificador puede cambiar el significado de una conversación y alterar el resultado de un flujo posterior. Un WER agregado también puede ocultar que el rendimiento cae en llamadas con ruido, acentos poco representados, conversaciones solapadas o canales telefónicos.
La definición de palabra es otra fuente frecuente de resultados no comparables. Puntuación, mayúsculas, números escritos con cifras o letras, abreviaturas, fechas, monedas y vacilaciones pueden cambiar el conteo. La normalización puede ser apropiada para medir inteligibilidad general, pero resulta inadecuada si elimina una diferencia relevante para el producto. Por ejemplo, normalizar importes antes de puntuar puede ocultar un fallo que un extractor de datos sí sufriría.
Conviene mantener al menos dos vistas. La primera es una puntuación textual normalizada, documentada y estable, útil para comparar la calidad ASR general. La segunda conserva o vuelve a evaluar las formas críticas para el caso de uso: números, nombres, negaciones, códigos, fechas, importes y términos regulados. La segunda vista no reemplaza WER; responde una pregunta diferente: si el sistema preserva los elementos cuyo error tiene un coste desproporcionado.
La tasa de error de caracteres puede complementar WER en idiomas, nombres propios o identificadores donde el límite entre palabras no es una señal suficiente. Sin embargo, tampoco debe presentarse como una medida universal de utilidad. La selección de métricas debe derivarse de la salida y del riesgo del flujo, no de la disponibilidad de una herramienta de scoring.
Matriz mínima de métricas y decisiones
| Dimensión | Medida principal | Qué puede ocultar | Uso recomendado |
|---|---|---|---|
| Texto general | WER; CER cuando aporte señal | Impacto desigual entre palabras | Comparar fidelidad de transcripción bajo reglas fijas |
| Datos críticos | Tasa de error ponderada por entidad y severidad | Errores no anotados como críticos | Controlar nombres, importes, fechas, negaciones e identificadores |
| Hablantes | DER y, si se adopta, JER | Política de solapamiento, collar y regiones excluidas | Validar atribución en diálogos y reuniones |
| Tiempo | Desviación de inicio y fin; cobertura dentro de tolerancia | Segmentos correctos con límites inservibles | Validar citas, clips y automatizaciones temporales |
| Estructura | Tasa de respuestas válidas y campos completos | Texto correcto en una respuesta que el consumidor rechaza | Medir integración con el contrato aguas abajo |
Medir hablantes, tiempos, segmentos e idioma como salidas independientes
La diarización responde a “quién habló cuándo”; no equivale a reconocer las palabras. Su evaluación requiere una referencia temporal de hablantes y una política explícita de puntuación. Las herramientas de diarización documentan que el DER integra error de hablante, falsas alarmas de habla y habla omitida. También permiten opciones que modifican el resultado, como un margen temporal de tolerancia —collar—, la inclusión o exclusión del habla solapada y las regiones evaluables. Un DER sin esas decisiones metodológicas no es suficientemente interpretable para comparar sistemas.
La métrica puede penalizar fenómenos distintos. Un sistema puede detectar el habla pero intercambiar etiquetas entre interlocutores; otro puede perder intervenciones breves; otro puede asignar bien turnos limpios y fallar precisamente cuando dos personas se pisan. El informe debe separar, cuando sea posible, componentes de error y resultados para audio con y sin solapamiento. Además, debe declarar cómo se resuelven los hablantes desconocidos, los cambios de canal y los silencios.
Las marcas de tiempo necesitan una métrica ligada a la acción que realizará el producto. Si una persona abre un clip a partir de una frase, puede medirse la desviación absoluta entre los inicios y finales predichos y los de referencia. Si el requisito es localizar una evidencia, puede ser más pertinente la proporción de segmentos que quedan dentro de una tolerancia previamente aprobada. Una media sola puede esconder una cola de errores extremos: informe también percentiles y el peor tramo relevante por estrato.
La segmentación es distinta de la alineación palabra a palabra. Un sistema puede ubicar palabras aproximadamente bien y, aun así, agrupar de forma poco útil varias intervenciones en un solo segmento. Mida segmentos excesivamente largos, cortes dentro de una frase, duplicaciones en los límites, omisiones y cobertura de habla. Si la interfaz depende de un segmento por intervención o de citas breves, defina esas condiciones como pruebas de aceptación.
El idioma merece una comprobación propia cuando la aplicación usa detección, enruta por idioma o aplica vocabularios y reglas distintas. No basta con observar que una transcripción parezca legible. Deben registrarse el idioma esperado, el declarado por el sistema cuando exista, el idioma de salida y los errores de cambio de idioma en conversaciones multilingües. La cobertura del corpus debe reflejar los idiomas y variedades que el producto pretende admitir; una muestra monolingüe no justifica conclusiones fuera de ella.
Construir un corpus que represente el riesgo, no solo el volumen
El corpus de evaluación debe ser una muestra deliberada de las condiciones que el sistema encontrará, no una colección cómoda de audios limpios. Defina estratos antes de ejecutar el modelo: dominio de conversación, idioma y variedad, canal de captura, ruido, reverberación, calidad del micrófono, número de participantes, solapamiento, duración, velocidad de habla y presencia de vocabulario especializado. Añada estratos para los eventos de alto impacto definidos por el negocio, aunque sean poco frecuentes.
La asignación de tamaño no tiene por qué ser uniforme. Los estratos con mayor exposición o coste de error merecen una muestra suficiente para revelar diferencias prácticas. Una llamada con una cantidad pequeña de conversaciones que contienen importes, autorizaciones o datos contractuales puede ser más informativa que muchas horas adicionales de charla rutinaria. Esta es una decisión de riesgo y cobertura, no una afirmación de que un estrato sea más difícil por definición.
Separe datos de desarrollo y de evaluación. Los primeros sirven para decidir reglas de normalización, umbrales, preprocesado y manejo de errores. Los segundos quedan congelados hasta la comparación que fundamenta una decisión. Si se ajusta el sistema tras ver el conjunto de evaluación, el resultado posterior debe presentarse como desarrollo o validarse en un conjunto nuevo. La metodología de evaluación de NIST enfatiza el uso de protocolos, datos y software de puntuación comunes, además de descripciones del sistema, para que los resultados sean comparables.
La referencia requiere el mismo cuidado que la hipótesis. Para cada muestra, puede incluir transcripción literal según una guía escrita, hablantes con intervalos temporales, segmentos y etiquetas de entidades críticas. La guía debe resolver cifras frente a palabras, vacilaciones, risas, habla ininteligible, interrupciones, pronunciaciones dudosas, préstamos lingüísticos y solapamiento. Si los anotadores aplican reglas distintas, la métrica puede estar midiendo inconsistencias de anotación en lugar de diferencias del ASR.
Use doble anotación o revisión independiente de una fracción priorizada: audios complejos, ejemplos de alto impacto y desacuerdos esperables. Registre desacuerdos, resuélvalos mediante una política definida y conserve la versión de la referencia. La concordancia entre anotadores no hace perfecta a la referencia, pero revela dónde la conclusión es incierta. No etiquete como error de modelo un caso para el que la referencia tampoco ofrece una respuesta estable.
Proceso reproducible para preparar el corpus
- 01Definir población objetivo, riesgos y estratos antes de muestrear.
- 02Asignar identificadores estables a audios, versiones de referencia y reglas de anotación.
- 03Separar conjuntos de desarrollo, validación operativa y evaluación congelada.
- 04Anotar texto, hablantes, tiempos y entidades críticas conforme a una guía versionada.
- 05Revisar de forma independiente una muestra orientada a riesgo y documentar desacuerdos.
- 06Publicar una ficha del corpus con cobertura, exclusiones, distribución por estrato y limitaciones.
Ejecutar y puntuar sin introducir ventajas accidentales
La ejecución comparable entrega el mismo archivo o la misma representación de audio a cada alternativa. Si es necesario convertir formato, recortar silencios, separar canales o reducir ruido, aplique el mismo procedimiento a todos los sistemas o evalúe explícitamente cada variante como parte de un sistema completo. Conserve los archivos de entrada, sus huellas de integridad cuando la política lo permita y los registros técnicos necesarios para repetir la prueba.
Registre las respuestas originales antes de normalizarlas para el scoring. Distinga errores técnicos —solicitudes fallidas, tiempos de espera, respuestas truncadas, límites de tamaño o formatos no analizables— de errores de reconocimiento. Excluir silenciosamente los fallos técnicos mejora artificialmente una métrica de texto y elimina información que puede bloquear el producto. Informe una tasa de finalización, una tasa de respuesta analizable y una tasa de salida válida para el esquema consumidor.
La tasa de validez estructural es decisiva cuando un componente posterior espera campos, segmentos, identificadores de hablante o tiempos con tipos concretos. Defina qué cuenta como válido: respuesta que se analiza, campos obligatorios presentes, valores dentro de rango, orden temporal coherente y correspondencia entre segmentos y texto, si el contrato la exige. Valide primero contra el esquema y después contra las reglas semánticas del flujo. Un objeto formalmente válido puede contener intervalos invertidos o etiquetas de hablante inutilizables.
Para WER y análisis de alineamiento, emplee una herramienta de scoring versionada y una configuración común. El toolkit SCTK de NIST se utiliza para puntuación de reconocimiento de voz y ofrece mecanismos de comparación; su uso no sustituye la necesidad de declarar reglas de normalización y filtros. Para diarización, declare la herramienta, la versión, las regiones evaluables y todas las opciones de collar y solapamiento. Los cambios de herramienta o de parámetros pueden producir diferencias que no proceden del modelo.
Las repeticiones solo son necesarias si el servicio, el preprocesado o el entorno pueden producir resultados variables. Si se repite una solicitud, no promedie sin más las transcripciones: informe estabilidad de salida, discrepancias y la regla empleada. Si no se realizaron repeticiones, indíquelo como límite. También conviene separar la latencia y disponibilidad de la calidad ASR: ambas pueden importar al producto, pero responden a preguntas distintas.
Registro por corrida y tratamiento de fallos
| Elemento | Registro mínimo | Regla de informe |
|---|---|---|
| Sistema | Modelo o snapshot, parámetros, preprocesado y formato | Una fila o identificador por configuración completa |
| Entrada | ID de audio, estrato, duración y versión de referencia | La misma entrada para todas las alternativas |
| Resultado técnico | Éxito, error, reintento, truncamiento y respuesta bruta | No excluir del denominador sin declararlo |
| Scoring | Herramienta, versión, normalización y opciones | Mantener fijo al comparar |
| Salida estructurada | Esquema válido, campos obligatorios y consistencia temporal | Reportar junto a las métricas ASR |
Presentar resultados que permitan decidir y revertir
El informe principal debe mostrar resultados agregados, pero no terminar ahí. Presente cada métrica por estrato, por severidad de entidad crítica y por flujo afectado. Incluya denominadores: número de audios, duración, número de palabras de referencia, cantidad de entidades y minutos de habla anotada, según corresponda. Sin denominadores, una tasa no permite estimar cobertura ni estabilidad.
Acompañe las estimaciones con incertidumbre. Puede usar intervalos obtenidos por remuestreo sobre unidades apropiadas, como archivos o conversaciones, siempre que documente el método. Evite tratar palabras correlacionadas de un mismo audio como observaciones independientes sin advertirlo. Cuando el tamaño de una categoría crítica sea pequeño, comunique el conteo y la incertidumbre en vez de formular conclusiones fuertes a partir de unas pocas ocurrencias.
Los casos representativos ayudan a interpretar una tabla, pero no deben elegirse solo por ser favorables o llamativos. Seleccione ejemplos de cada patrón importante: mejora clara, regresión, fallo crítico, respuesta estructural inválida y caso ambiguo de referencia. Conserve la posibilidad de auditoría interna con el audio y las anotaciones, aplicando los controles de privacidad pertinentes.
Los umbrales de decisión deben definirse antes de mirar el resultado final o, si se definen después, marcarse como exploratorios. Una política puede promover una versión cuando cumple simultáneamente límites de texto, entidades críticas, diarización, tiempos y validez; permitir un despliegue restringido cuando falla solo en estratos excluidos del alcance; exigir revisión humana para casos de riesgo alto; o bloquear la promoción cuando aparecen regresiones materiales. No existe un umbral universal: la tolerancia depende del daño posible y de los controles posteriores.
Una comparación negativa tampoco implica que el modelo sea inútil en todos los contextos. Puede revelar que una configuración es apta para notas internas, pero no para citas temporales, atribución de hablantes o extracción de decisiones. La conclusión rigurosa delimita el alcance: qué corpus, versión, reglas y fecha sustentan el resultado, y qué usos quedan sin demostrar.
Puerta de decisión antes del despliegue
- 01Verificar que todas las corridas tienen ficha de sistema, entradas idénticas y resultados técnicos completos.
- 02Confirmar que se cumplen los mínimos de cobertura por estrato y por entidad crítica.
- 03Comparar cada métrica con su umbral y revisar intervalos de incertidumbre, no solo promedios.
- 04Revisar manualmente regresiones críticas y respuestas estructurales inválidas.
- 05Promover, restringir, mantener revisión humana o bloquear según una política documentada.
- 06Conservar línea base, resultados y criterios para detectar regresiones en una evaluación posterior.
Límites de esta evaluación
Esta guía evalúa la salida ASR y su aptitud para un contrato de datos concreto. No demuestra por sí misma la calidad de un resumen generado a partir de la transcripción, la corrección de una búsqueda, la justicia de una clasificación, la experiencia conversacional, el cumplimiento normativo ni la seguridad de acciones automatizadas posteriores. Cada uno de esos componentes necesita evaluación propia, aunque dependa de la transcripción.
Tampoco demuestra rendimiento futuro fuera del corpus probado. Cambios de población, idioma, acústica, contenido, modelo, endpoint o reglas de normalización pueden invalidar comparaciones anteriores. Repetir la evaluación tras cambios relevantes y vigilar muestras de producción con controles de privacidad ayuda a detectar esa deriva, pero no elimina la incertidumbre.
La conclusión operativa más útil suele ser condicional: bajo un conjunto de audios, una referencia y una política de puntuación declarados, una configuración conserva —o no conserva— las propiedades necesarias para un flujo específico. Esa formulación es menos llamativa que un único porcentaje de precisión, pero permite discutir riesgos, controles y límites sin esconder los errores que realmente interrumpen el trabajo posterior.
Qué sigue abierto
- La denominación «GPT‑Transcribe» no identifica de forma inequívoca un modelo, snapshot, endpoint ni configuración; el informe de evaluación debe registrar esos datos exactos.
- La disponibilidad de diarización, segmentos y marcas temporales depende de la configuración y del servicio utilizado; no debe asumirse a partir del nombre del producto.
- Los umbrales aceptables para WER, DER, tiempos o validez de esquema no son universales y requieren una decisión explícita basada en el caso de uso.
- Una referencia humana puede contener ambigüedades, sobre todo en solapamientos, habla ininteligible, nombres y límites temporales; la doble revisión reduce, pero no elimina, esa incertidumbre.
- Los resultados de un corpus concreto no garantizan rendimiento en idiomas, acentos, condiciones acústicas o dominios que no estén representados.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección