Laboratorio
Entidad que desarrolla o publica el modelo y mantiene su documentación técnica y de seguridad.
Consulta los modelos documentados, las evaluaciones publicadas y las fuentes primarias asociadas a esta organización.
Modelo frontera generalista orientado a tareas complejas, uso de herramientas y trabajo profesional de alta exigencia.
16 SEP. 2026↗ FRONTERA GENERALISTATrabajo complejo, código y agentes con herramientas.
16 SEP. 2026↗ EQUILIBRIO COSTE/CAPACIDADTareas equilibradas entre calidad, velocidad y coste.
16 SEP. 2026↗ ALTA EFICIENCIAAlto volumen, subagentes y extracción estructurada.
16 SEP. 2026↗ FRONTERA ANTERIORGeneración anterior de OpenAI para código y trabajo profesional, conservada para comparar migraciones y coste.
18 SEP. 2026↗ NO RAZONADOR · CONTEXTO LARGOModelo no razonador de contexto largo, útil como referencia histórica para código, seguimiento de instrucciones y latencia predecible.
18 SEP. 2026↗ RAZONAMIENTO ABIERTOModelo de razonamiento con pesos abiertos para ejecución local o privada; cabe en una GPU H100 según OpenAI.
18 SEP. 2026↗ GENERACIÓN Y EDICIÓN VISUALModelo principal de OpenAI para generar y editar imágenes con instrucciones complejas y producción visual de alta calidad.
18 SEP. 2026↗ VÍDEO CON AUDIO SINCRONIZADOModelo histórico de vídeo con audio sincronizado, útil para comparar la evolución de la familia Sora.
18 SEP. 2026↗ CONVERSACIÓN DE VOZ EN TIEMPO REALModelo de voz en tiempo real para conversaciones expresivas, interrupciones naturales y flujos con herramientas.
18 SEP. 2026↗ RECONOCIMIENTO DE VOZModelo especializado de transcripción de alta precisión para archivos y entradas de audio en tiempo real.
18 SEP. 2026↗ REPRESENTACIÓN VECTORIAL DE TEXTOModelo de embeddings de mayor capacidad de OpenAI para búsqueda semántica, clasificación, clustering y RAG.
18 SEP. 2026↗ CÓDIGO, USO DE ORDENADOR Y TRABAJO PROFESIONALModelo de OpenAI para código complejo, uso de ordenador y trabajo profesional con entrada de texto e imagen. El proveedor lo sitúa cerca de Astra en rendimiento, a menor coste; comprueba ese equilibrio con tus propias tareas.
30 SEP. 2026↗Las cifras se muestran con el contexto comunicado por su fuente. Un resultado del proveedor no equivale a una comparación independiente ni sustituye una evaluación propia.
Una organización, un producto y un modelo no son la misma unidad. Inferama los separa para evitar atribuir capacidades o condiciones comerciales al elemento equivocado.
Entidad que desarrolla o publica el modelo y mantiene su documentación técnica y de seguridad.
Versión identificable con límites, modalidades y comportamiento que pueden cambiar entre lanzamientos.
API, aplicación, nube asociada o plan comercial; cada canal puede tener precios, retención y límites distintos.
Cada afirmación debe conservar la página oficial consultada y la fecha de verificación.
Una puntuación de arena describe el resultado de una comparación bajo un protocolo concreto; no demuestra por sí sola que un modelo siga mejor las instrucciones, mantenga la continuidad temporal o sincronice audio y vídeo. Esta guía separa lo que puede afirmarse sobre Sora 2 Pro de lo que los benchmarks disponibles no permiten concluir.
26 sep. 2026 ↗
Guía para evaluar GPT‑Live‑1 en conversaciones de voz full‑duplex separando dinámica de turnos, comprensión, éxito de tarea y seguridad de acciones delegadas. Propone un protocolo reproducible con audio controlado, trazas, anotación temporal y revisión humana ciega.
23 sep. 2026 ↗
Una evaluación útil de transcripción automática no se resume en un único porcentaje de precisión. Esta guía propone un protocolo para medir, por separado, la fidelidad del texto, las entidades críticas, la atribución de hablantes, las marcas de tiempo, la segmentación y la validez de la salida que consume una aplicación. El objetivo es comparar versiones y configuraciones de forma reproducible, y decidir con evidencia cuándo promover, restringir o bloquear un despliegue.
23 sep. 2026 ↗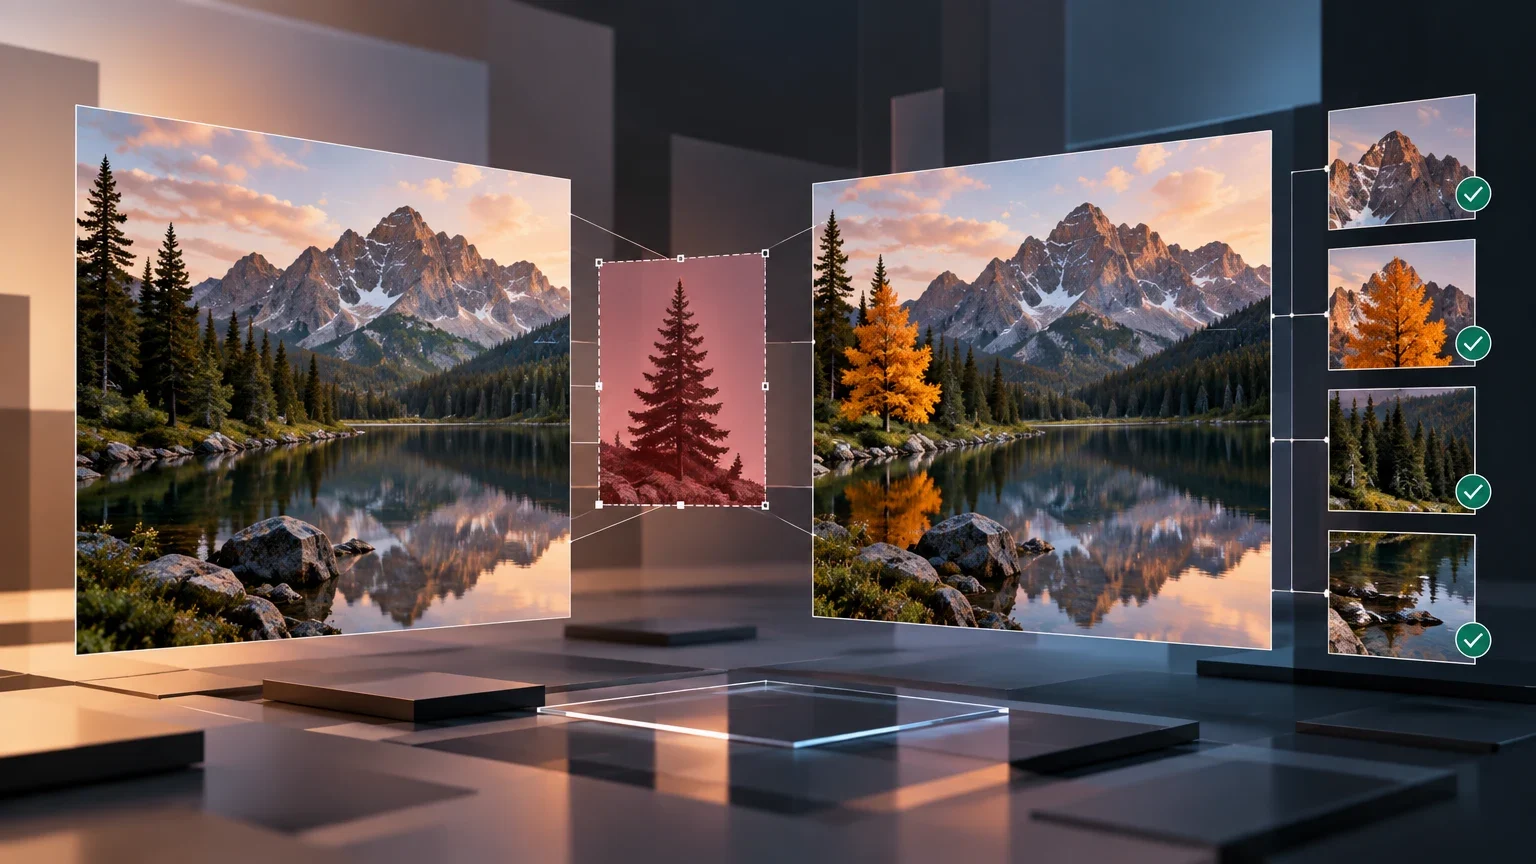
Una edición generativa útil en producción no se valida solo porque el cambio solicitado parezca correcto. Esta guía propone tratar cada retoque como un contrato de preservación: definir qué puede cambiar, qué debe mantenerse, cómo medirlo y cuándo exigir revisión humana.
23 sep. 2026 ↗
GPT-Transcribe figura como un modelo de transcripción disponible a través de la API de OpenAI. Antes de reemplazar un sistema ASR existente, conviene validar no solo el texto resultante, sino también el contrato técnico que sostiene buscadores, resúmenes, alertas, citas, revisiones y registros de cumplimiento.
22 sep. 2026 ↗
BenchCAD 1.0 mide si un sistema puede generar, modificar o interpretar programas CadQuery cuya geometría se puede ejecutar y comparar con una referencia. Es una señal útil sobre reconstrucción paramétrica, pero no sustituye la validación de tolerancias, función, fabricación ni integración en un flujo de ingeniería.
22 sep. 2026 ↗