Definition in einem Satz
Entrenamiento que obtiene sus señales de supervisión de la propia estructura de los datos, por ejemplo prediciendo partes ocultas de un texto.
Definition: Aufsicht, die aus den Daten entsteht
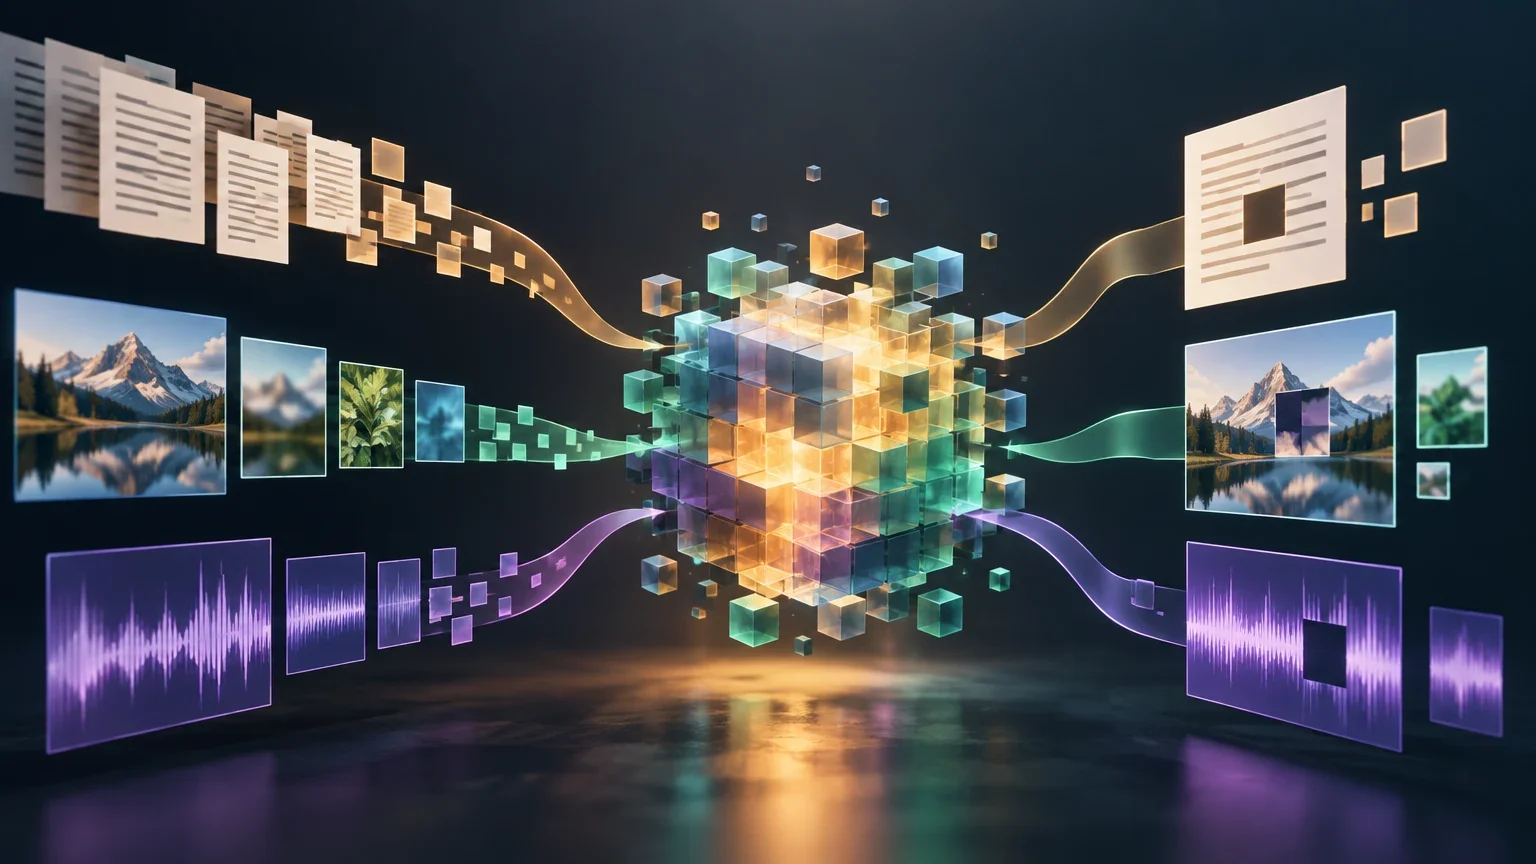
Selbstüberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem das System sein Trainingssignal aus der Struktur oder dem Inhalt der Daten selbst gewinnt. Es ist also nicht darauf angewiesen, dass Menschen für jedes Beispiel eigens ein Label annotieren. Häufig wird dazu ein Beispiel teilweise verborgen, transformiert oder in Teile zerlegt. Das Modell soll dann einen Teil anhand eines anderen vorhersagen. Die daraus entstehende Vorhersageaufgabe wird oft als Prätextaufgabe oder als selbstüberwachtes Lernziel bezeichnet.
Das Wort „selbstüberwacht“ beschreibt, woher das Signal für eine bestimmte Trainingsphase stammt. Es bedeutet nicht, dass ein Modell ohne menschliches Zutun, ohne Gestaltungsentscheidungen oder ohne Evaluation lernt. Menschen wählen die Daten aus, legen das Lernziel fest, entscheiden über mögliche Transformationen und bestimmen, wie Ergebnisse gemessen werden. Auch wenn für jedes einzelne Beispiel kein manuelles Label erforderlich ist, beeinflussen diese Entscheidungen dennoch, was das System lernt.
Der Begriff besagt auch nicht, dass der gesamte Datensatz vollkommen frei von gelabelten Informationen ist. Ein Projekt kann mehrere Phasen umfassen: Zunächst werden mit selbstüberwachten Lernzielen und nicht annotierten Daten Repräsentationen gelernt. Anschließend wird das Modell möglicherweise mit gelabelten Beispielen für eine konkrete Aufgabe feinabgestimmt oder evaluiert. Deshalb sollte man fragen, auf welche Phase sich die Bezeichnung „selbstüberwacht“ bezieht und welche Daten jeweils verwendet wurden.
Eine hilfreiche Definition beschreibt den Ansatz anhand seiner Funktionsweise: Wird das Trainingsziel aus einem Beispiel oder aus Beziehungen zwischen Beispielen abgeleitet, ohne dass für jedes einzelne Beispiel eine eigens dafür erstellte menschliche Annotation erforderlich ist, kann die Methode selbstüberwacht sein. Daraus folgt jedoch nichts über die konkrete Architektur, die Modellgröße, die Qualität der Repräsentationen oder die Leistung bei einer späteren Anwendung.
So funktioniert es: vom Beispiel zu einer auswertbaren Repräsentation
Ein selbstüberwachter Lernablauf lässt sich in drei Schritte gliedern. Zunächst wird entschieden, welche Beziehung innerhalb der Daten als nützliches Trainingssignal dienen soll: etwa welches Wort an einer verdeckten Stelle stehen könnte, welche zwei Ansichten aus demselben Bild stammen oder welche Audioteile zu einer maskierten Repräsentation gehören. Anschließend erzeugt das Modell Vorhersagen und wird so optimiert, dass sie dem aus den Daten abgeleiteten Ziel näherkommen. Schließlich wird untersucht, was das Modell gelernt hat: Man evaluiert das Modell, verwendet seine Repräsentationen weiter oder passt seine Parameter mit Daten für eine bestimmte Aufgabe an.
Eine gelernte Repräsentation ist eine interne Beschreibung der Daten, die das Modell zur Lösung der trainierten Aufgabe verwendet. Sie kann für andere Probleme nützlich sein, doch eine Übertragung auf neue Aufgaben ist nicht automatisch gewährleistet. Eine Repräsentation, die dabei hilft, die vom Prätextziel betonten Beziehungen zu unterscheiden, muss nicht unbedingt die Informationen bewahren, die für eine andere Aufgabe nötig sind. Deshalb sollte die spätere Evaluation zum vorgesehenen Einsatz passen.
Die Prätextaufgabe ist kein neutraler Zwischenschritt. Wenn ein Teil verdeckt wird, muss entschieden werden, welcher Teil verborgen bleibt. Werden zwei Ansichten erzeugt, ist festzulegen, welche Transformationen eingesetzt werden. Werden Beispiele kontrastiv verglichen, muss definiert werden, was als positives oder negatives Beispiel gilt. Diese Entscheidungen lenken die Aufmerksamkeit auf bestimmte Regelmäßigkeiten. Als praktische Überlegung gilt: Je größer der Abstand zwischen der gelernten Regelmäßigkeit und den Anforderungen der späteren Anwendung ist, desto wichtiger wird es, die Übertragung direkt zu messen.
Der Arbeitszyklus
- 01Daten auswählen und festlegen, welche Struktur oder Beziehung als Signal dient.
- 02Ein Lernziel konstruieren: Teile der Daten verbergen, transformieren, zu Paaren zusammenstellen oder kontrastiv vergleichen.
- 03Das Modell auf dieses Ziel trainieren, ohne für jedes Beispiel ein eigens dafür erstelltes manuelles Label vorauszusetzen.
- 04Die Repräsentation anhand relevanter Aufgaben evaluieren und sie gegebenenfalls mit gelabelten Daten feinabstimmen.
- 05Fehler, Abdeckung und mögliche Unterschiede zwischen Trainingsdaten und geplantem Einsatz überprüfen.
Beispiel aus der Sprachverarbeitung: verborgene Tokens mit BERT vorhersagen
BERT ist ein technisches Beispiel für selbstüberwachtes Sprachmodellieren. Beim Ziel des maskierten Sprachmodellierens werden einige Tokens einer Sequenz verborgen. Das Modell wird darauf trainiert, sie anhand des verfügbaren Kontexts vorherzusagen. So entsteht eine Vorhersageaufgabe direkt aus dem Text, ohne dass ein Mensch für jede Position das richtige Wort manuell annotieren muss.
Bei einem Satz wie „Die Wissenschaftlerin veröffentlichte das Ergebnis in der [Maske]“ muss das Modell zum Beispiel die umgebenden Wörter nutzen, um abzuschätzen, welches Token verborgen wurde. Das Beispiel ist schematisch: Im Training verarbeitet das Modell viele Textausschnitte, und das Ziel besteht darin, die maskierten Positionen wiederherzustellen. In seiner ursprünglichen Vortrainingskonfiguration führte BERT außerdem eine Aufgabe zur Vorhersage des nächsten Satzes ein. Diese zusätzliche Aufgabe sollte nicht mit der allgemeinen Definition selbstüberwachten Lernens verwechselt werden.
Mit diesem Lernziel soll das Modell Kontext im Text für die vorgesehenen Vorhersagen nutzen. Es beweist für sich genommen weder, dass das System einen Satz so versteht wie ein Mensch, noch, dass es jede Frage zuverlässig beantworten kann. Für eine konkrete Anwendung müsste man das Verhalten anhand passender Aufgaben evaluieren und prüfen, ob eine spätere Feinabstimmung die benötigten Fähigkeiten verbessert.
Beispiel aus der Bildverarbeitung: Bildansichten mit SimCLR vergleichen
In der Bildverarbeitung kann ein Ansatz zwei transformierte Versionen desselben Bildes erzeugen und das Modell darauf trainieren, ihre Repräsentationen in einem erlernten Raum zueinander in Beziehung zu setzen. SimCLR ist ein Beispiel für kontrastives Lernen visueller Repräsentationen: Das Lernziel verwendet Paare transformierter Ansichten. Welche Transformationen kombiniert werden, beeinflusst dabei die Aufgabe, die das Modell letztlich löst.
Stellen wir uns ein Foto eines Fahrrads vor. Daraus werden zwei Ansichten mit den vom Verfahren festgelegten Transformationen erzeugt. Beim Training soll das Modell erkennen, dass beide Ansichten zum selben Bild gehören, und sie von anderen Beispielen im Batch unterscheiden. Für dieses Lernziel wird ihm nicht notwendigerweise ein manuelles Label wie „Fahrrad“ gegeben. Die Beziehung zwischen den Ansichten dient als Trainingssignal.
Die Wahl der Transformationen ist wichtig. Wenn beide Versionen die für den vorgesehenen Einsatz relevanten Merkmale bewahren, kann die Aufgabe Repräsentationen fördern, die für diesen Einsatz nützlich sind. Werden hingegen wichtige Informationen entfernt oder verzerrt, kann das Lernziel andere Eigenschaften in den Vordergrund rücken. Daraus lässt sich nicht ableiten, dass beliebige Transformationen geeignet wären: Man muss ihre Auswirkungen auf den jeweiligen Anwendungsbereich untersuchen und das Modell anhand konkreter Aufgaben evaluieren.
Die Aussage „Das Modell hat anhand ungelabelter Bilder gelernt“ ist deshalb unvollständig. Um das Ergebnis einordnen zu können, sollte man wissen, welche Transformationen verwendet wurden, wie der Vergleich definiert war und mit welchen nachfolgenden Tests die Übertragung gemessen wurde.
Beispiel aus der Audiokodierung: Sprachrepräsentationen mit wav2vec 2.0
Selbstüberwachtes Lernen wird auch für Sprache und Audio eingesetzt. wav2vec 2.0 lernt Repräsentationen aus Audiodaten, ohne Transkripte für sein Vortrainingsziel vorauszusetzen. Vereinfacht berechnet das Verfahren latente Repräsentationen des Audios, maskiert einen Teil davon und trainiert das System mit einer kontrastiven Aufgabe darauf, die jeweils passenden Zielrepräsentationen zu identifizieren.
So lassen sich akustische Regelmäßigkeiten anhand von Aufnahmen lernen, ohne jeden Ausschnitt transkribieren zu müssen. Anschließend können die Repräsentationen für Aufgaben verwendet oder angepasst werden, die eine Textreferenz erfordern, etwa automatische Spracherkennung. In dieser zweiten Phase können transkribierte Daten zum Einsatz kommen. Dass es später eine gelabelte Trainingsphase gibt, ändert nichts daran, dass das vorherige Lernziel selbstüberwacht war.
Diese Unterscheidung ist wichtig, wenn man ein vollständiges Sprachsystem beschreibt. Die Aussage, ein Sprachmodell sei selbstüberwacht vortrainiert worden, verrät nicht, wie viele Transkripte bei der Feinabstimmung eingesetzt wurden, wie das System evaluiert wurde oder welche Leistung es bei unterschiedlichen Akzenten, Aufnahmebedingungen oder Sprachen erbringt. Solche Fragen erfordern zusätzliche Angaben und Tests; sie lassen sich nicht allein aus dem Methodennamen ableiten.
Verwandte Begriffe, die nicht gleichbedeutend sind
Unüberwachtes Lernen ist ein weit gefasster Begriff für Verfahren, die in Daten nach Strukturen suchen, ohne dass konventionell bereitgestellte Ziel-Labels vorliegen. Selbstüberwachtes Lernen wird oft als verwandter Ansatz behandelt: Es konstruiert ein Vorhersagesignal aus den Daten selbst. Je nach Fachgebiet und Sprachgebrauch können sich die Kategorien überschneiden. Deshalb ist es genauer, das konkrete Lernziel zu erläutern, statt sich allein auf eine allgemeine Bezeichnung zu verlassen.
Halbüberwachtes Lernen kombiniert gelabelte und ungelabelte Daten im Lernprozess. Es ist kein Synonym für selbstüberwachtes Lernen. FixMatch beschreibt zum Beispiel ein halbüberwachtes Verfahren, das gelabelte Daten nutzt und ungelabelte Daten mit Konsistenz und Pseudo-Labels einbezieht. Ein selbstüberwachtes Verfahren kann sein Ziel dagegen aus den Daten ableiten, ohne für jedes Beispiel dieses Ziels ein eigens erstelltes manuelles Label zu benötigen.
Ein Pseudo-Label ist ein Label, das von einem Modell oder einem anderen Verfahren erzeugt und als Ziel für weitere Beispiele verwendet wird. Es entspricht nicht automatisch einem selbstüberwachten Signal, das unmittelbar aus der Struktur eines Beispiels abgeleitet wird. Manche halbüberwachten Verfahren verwenden Pseudo-Labels als Teil ihrer Strategie. Entscheidend ist, woher das Label stammt und wie es eingesetzt wird.
Vortraining bezeichnet eine Phase im Lebenszyklus eines Modells und nicht eine einzelne Lernmethode. Vortraining kann mit selbstüberwachten Zielen erfolgen, aber „vortrainiert“ bedeutet nicht zwangsläufig „selbstüberwacht“. Umgekehrt kann ein selbstüberwachtes Lernziel eingesetzt werden, ohne dass der Begriff Vortraining das ganze System angemessen beschreibt. Lernparadigma und Trainingsphase beantworten unterschiedliche Fragen.
Begriffe im Vergleich
| Begriff | Welche Frage beantwortet er? | Praktische Unterscheidung |
|---|---|---|
| Selbstüberwacht | Woher stammt das Trainingsziel? | Es wird aus Beziehungen oder Strukturen in den Daten selbst abgeleitet. |
| Halbüberwacht | Welche Kombination von Daten wird genutzt? | Gelabelte und ungelabelte Daten werden kombiniert; Pseudo-Labels können eingesetzt werden. |
| Pseudo-Labeling | Wie wird einem Beispiel ein Label zugewiesen? | Ein generiertes Label wird als Ziel verwendet; es kann Teil eines halbüberwachten Verfahrens sein. |
| Vortraining | In welcher Phase wird das Modell trainiert? | Es handelt sich um eine Phase vor einer späteren Nutzung oder Feinabstimmung; sie legt für sich genommen die Art der Aufsicht nicht fest. |
Grenzen, Verzerrungen und häufige Missverständnisse
Ein selbstüberwachtes Lernziel kann sich leicht optimieren lassen und dem Modell dennoch nicht das vermitteln, was es für die spätere Aufgabe benötigt. Die Qualität einer Repräsentation oder ein gutes Ergebnis bei einer Evaluation des Vortrainings ist kein allgemeiner Beleg für gute Leistung bei nachgelagerten Aufgaben. Die Übertragung muss mit für den vorgesehenen Einsatz geeigneten Evaluierungen geprüft werden; sie lässt sich nicht aus einer einzelnen Kennzahl ableiten.
Auch das Fehlen manueller Labels für das Lernziel beseitigt keine Verzerrungen. Daten können unausgewogene Abdeckung, Erfassungsfehler, historische Konventionen oder Unterschiede zwischen den dargestellten Bevölkerungsgruppen widerspiegeln. Die Filterung des Korpus, die verwendeten Transformationen, die Auswahl der Beispiele und die Evaluationskriterien sind Entscheidungen, die Ergebnisse beeinflussen können. „Selbstüberwacht“ ist keine Garantie für Neutralität.
Ein weiteres häufiges Missverständnis ist, den Ansatz als vollständig autonomes Lernen darzustellen. Selbst wenn das Signal aus den Daten abgeleitet wird, müssen Menschen den Korpus und das Lernziel auswählen, das System trainieren und bestimmen, was als zufriedenstellendes Ergebnis gilt. Ebenso falsch wäre die Schlussfolgerung, dass ein Modell in keiner Phase gelabelte Daten verwendet hat, nur weil sein Vortraining selbstüberwacht war.
Schließlich sollte man die Fähigkeit, eine Hilfsaufgabe zu lösen, nicht mit praktischem Nutzen gleichsetzen. Verborgene Tokens vorherzusagen, visuelle Ansichten miteinander in Beziehung zu setzen oder Audiorepräsentationen zu lernen sind jeweils definierte Ziele. Sie zeigen, worauf das System optimiert wurde, ersetzen aber keine Evaluation von Genauigkeit, Robustheit oder Eignung im vorgesehenen Einsatzkontext.
Praktische Kriterien zur Einordnung einer Aussage
Wenn behauptet wird, ein Modell habe selbstüberwacht gelernt, sollte man zuerst fragen, welches Ziel aus den Daten konstruiert wurde: Wurden Elemente verborgen? Wurden transformierte Ansichten verglichen? Wurden Repräsentationen maskiert? Danach sollte man klären, in welcher Phase dieses Ziel zum Einsatz kam und ob es eine spätere Feinabstimmung mit Labels gab. Diese Trennung verhindert, dass das Lernparadigma mit dem Lebenszyklus des Modells vermischt wird.
Anschließend sollte man prüfen, welche Daten und Transformationen verwendet wurden. Die Aufgabe kann nützliche Regelmäßigkeiten abbilden, aber auch die Grenzen des Korpus und der Designentscheidungen widerspiegeln. Entscheidend ist, welche Evaluierung die Übertragung auf die interessierende Anwendung stützt. Ein Ergebnis des Vortrainings allein reicht dafür nicht aus.
Beim Vergleich von Methoden sollte man zuerst das Trainingssignal und die Evaluationsbedingungen beschreiben und erst danach die Namen der Verfahren gegenüberstellen. In einem Glossarvergleich oder einem Vergleichsleitfaden sollten die Kategorien selbstüberwacht, halbüberwacht und Vortraining getrennt bleiben. Weitere verwandte Begriffe lassen sich über die zugehörigen Glossareinträge erschließen, etwa selbstüberwachtes Lernen, sowie über Begriffe zu Architektur oder Evaluation, die das Gesamtsystem erklären.
Eine sorgfältige Beschreibung sollte in der Praxis festhalten, was als Lernziel diente, welche Daten verwendet wurden, welche Transformationen oder Beziehungen das Signal erzeugten, in welchen späteren Phasen Labels hinzukamen und wie die endgültige Leistung evaluiert wurde. Ist eine dieser Informationen nicht dokumentiert, muss die Schlussfolgerung auf das beschränkt bleiben, was tatsächlich bekannt ist. Die abschließende Regel ist einfach: „Selbstüberwacht“ erklärt, wie ein Trainingssignal gewonnen wurde. Der Begriff garantiert weder, was das Modell lernen wird, noch, wie es sich außerhalb dieser Aufgabe verhält.
Kurze Prüfliste
- 01Das aus den Daten abgeleitete Lernziel bestimmen.
- 02Vortraining, Feinabstimmung und Evaluation voneinander trennen.
- 03Prüfen, ob in anderen Phasen gelabelte Daten eingesetzt wurden.
- 04Die Abdeckung des Korpus und die Rolle der Transformationen untersuchen.
- 05Ergebnisse zu nachgelagerten Aufgaben und Bedingungen berücksichtigen, die für den geplanten Einsatz relevant sind.
- 06Schlussfolgerungen formulieren, ohne die Bezeichnung der Methode als Garantie zu behandeln.