Definición en una frase
Entrenamiento que obtiene sus señales de supervisión de la propia estructura de los datos, por ejemplo prediciendo partes ocultas de un texto.
Definición: supervisión creada a partir de los datos
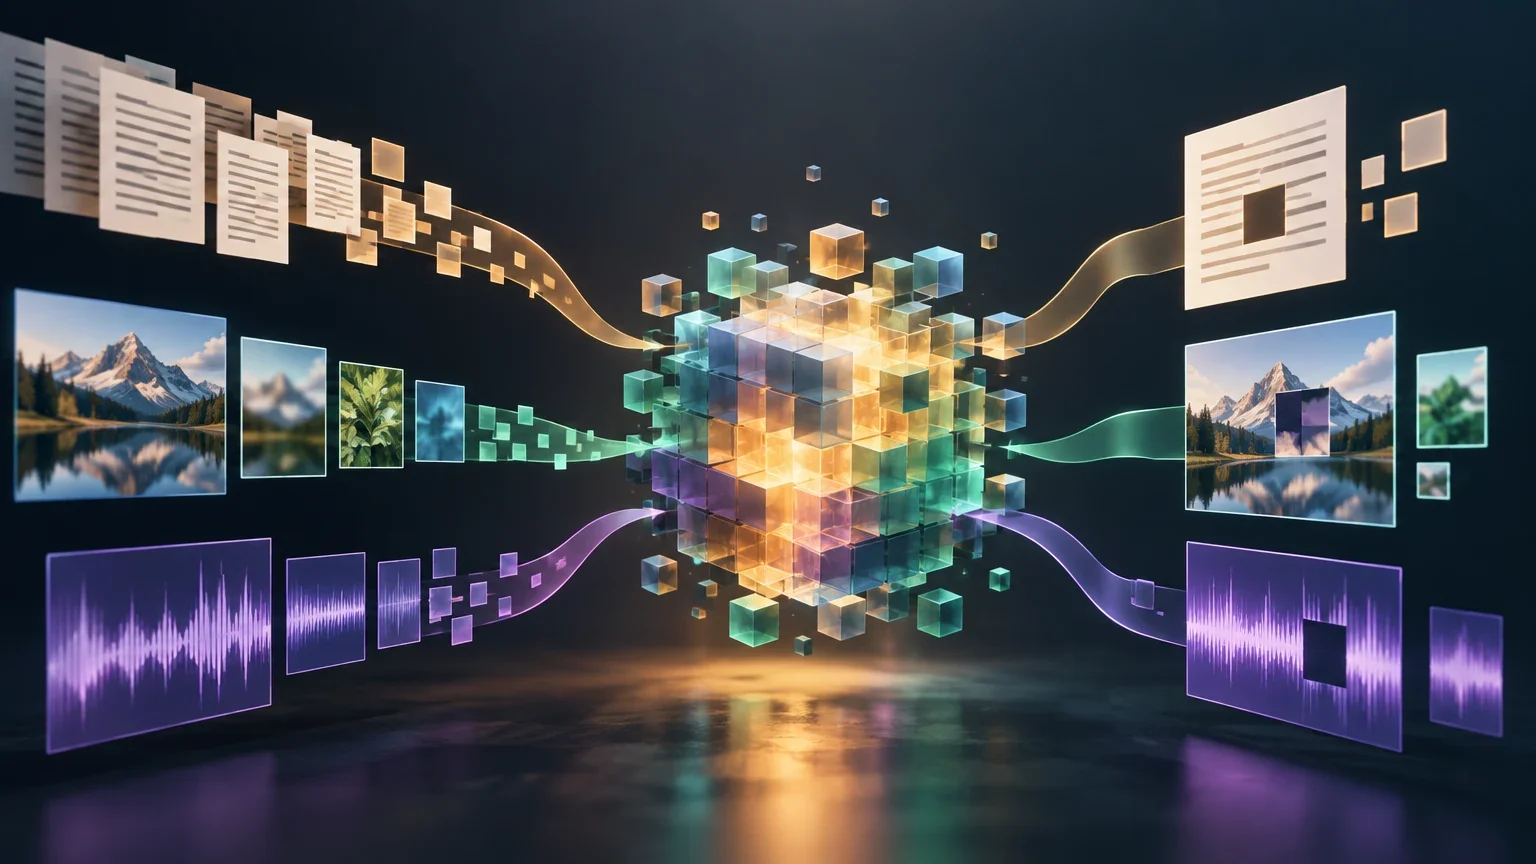
El aprendizaje autosupervisado es un enfoque de aprendizaje automático en el que el sistema obtiene la señal de entrenamiento de la estructura o el contenido de los propios datos, en lugar de depender de etiquetas anotadas específicamente por personas para cada ejemplo. Una forma habitual de hacerlo consiste en ocultar, transformar o dividir una muestra y entrenar el modelo para predecir una parte a partir de otra. La tarea de predicción resultante se conoce a menudo como tarea de pretexto u objetivo autosupervisado.
La palabra «autosupervisado» describe de dónde procede la señal usada durante cierto entrenamiento; no significa que el modelo aprenda sin ninguna intervención humana, sin decisiones de diseño ni sin evaluación. Alguien ha elegido los datos, definido el objetivo, decidido qué transformaciones aplicar y fijado cómo medir el resultado. Es posible que esas decisiones no requieran una etiqueta manual individual para cada elemento, pero aun así afectan a lo que el sistema aprende.
Tampoco equivale a decir que el conjunto de datos carezca por completo de información etiquetada. Un proyecto puede combinar etapas: primero, aprender representaciones mediante objetivos autosupervisados con datos sin anotar; después, ajustar o evaluar el modelo con ejemplos etiquetados. Por eso conviene preguntar qué etapa describe la etiqueta «autosupervisado» y qué datos participaron en cada una.
La definición útil es operativa: si el objetivo de entrenamiento se construye a partir de la muestra o de relaciones entre muestras, sin necesitar una anotación humana específica para ese objetivo en cada caso, el método puede ser autosupervisado. Esto no determina por sí solo la arquitectura, el tamaño del modelo, la calidad de sus representaciones ni su rendimiento en una aplicación posterior.
Cómo funciona: de la muestra a una representación evaluable
Un flujo autosupervisado puede describirse en tres pasos. Primero, se decide qué relación dentro de los datos será útil para entrenar: por ejemplo, qué palabra podría ocupar una posición oculta, qué dos vistas provienen de una misma imagen o qué fragmentos de audio corresponden a una representación enmascarada. Segundo, el modelo produce predicciones y se optimiza para acercarlas al objetivo derivado de los datos. Tercero, se comprueba qué ha aprendido: se evalúa el modelo, se reutilizan sus representaciones o se ajustan sus parámetros con datos de una tarea concreta.
La representación aprendida es una descripción interna de los datos que el modelo usa para resolver la tarea entrenada. Puede resultar útil para otros problemas, pero no hay una garantía automática de transferencia. Una representación que ayuda a distinguir las relaciones enfatizadas por el objetivo de pretexto podría no conservar la información necesaria para una tarea distinta. Por tanto, la evaluación posterior debe corresponder al uso que se pretende dar al sistema.
La tarea de pretexto no es un trámite neutral. Si se oculta una parte, se elige qué ocultar; si se generan dos vistas, se decide qué transformaciones aplicar; si se contrastan ejemplos, se define qué cuenta como positivo o negativo. Esas elecciones ponen énfasis en ciertas regularidades. Como análisis práctico, cuanto mayor sea la distancia entre la regularidad aprendida y el desempeño que exige la aplicación, más importante resulta medir la transferencia directamente.
Ciclo de trabajo
- 01Seleccionar los datos y definir qué estructura o relación se usará como señal.
- 02Construir el objetivo: ocultar, transformar, emparejar o contrastar partes de los datos.
- 03Entrenar el modelo para resolver ese objetivo sin requerir una etiqueta manual específica por ejemplo.
- 04Evaluar la representación en tareas pertinentes y, si procede, ajustarla con datos etiquetados.
- 05Revisar errores, cobertura y posibles diferencias entre los datos de entrenamiento y el uso previsto.
Ejemplo en lenguaje: predecir tokens ocultos con BERT
BERT ofrece un ejemplo técnico de modelado de lenguaje autosupervisado. En su objetivo de modelado de lenguaje enmascarado, se ocultan algunos tokens de una secuencia y se entrena el modelo para predecirlos usando el contexto disponible. Así se forma una tarea de predicción a partir del texto mismo, en vez de pedir a una persona que anote manualmente la palabra correcta en cada posición.
Por ejemplo, ante una oración como «La científica publicó el resultado en la [oculta]», el modelo debe usar las palabras alrededor del hueco para estimar qué token se había ocultado. El ejemplo es esquemático: en el entrenamiento se procesan muchos fragmentos de texto, y el objetivo consiste en recuperar las posiciones enmascaradas. BERT también presentó una tarea de predicción de la siguiente oración en su configuración original de preentrenamiento; no debe confundirse esta tarea adicional con la definición general del aprendizaje autosupervisado.
El objetivo enseña al modelo a aprovechar contexto textual para resolver las predicciones propuestas. No demuestra por sí mismo que el sistema comprenda una frase como lo haría una persona ni que responda con precisión a cualquier pregunta. Para una aplicación, habría que evaluar el comportamiento en tareas pertinentes y comprobar si el ajuste posterior mejora lo que se necesita.
Ejemplo en visión: comparar vistas de una imagen con SimCLR
En visión por computador, un enfoque puede crear dos versiones transformadas de una misma imagen y entrenar un modelo para que sus representaciones se relacionen dentro de un espacio aprendido. SimCLR es un ejemplo de aprendizaje contrastivo de representaciones visuales: su objetivo usa pares de vistas transformadas, y la composición de las transformaciones influye en la tarea que el modelo acaba resolviendo.
Imaginemos una fotografía de una bicicleta. De ella se producen dos vistas mediante transformaciones elegidas por el método. El entrenamiento busca que el modelo reconozca la relación entre ambas vistas como pertenecientes a la misma imagen, en contraste con otras muestras del lote. No se le proporciona necesariamente una etiqueta manual como «bicicleta» para construir ese objetivo. La relación entre vistas es la señal de entrenamiento.
La elección de las transformaciones importa. Si dos versiones conservan las características relevantes para el uso previsto, la tarea podría favorecer representaciones útiles para ese uso; si eliminan o distorsionan información importante, el objetivo podría enfatizar otras propiedades. Esto no permite concluir de antemano que cualquier conjunto de transformaciones sea adecuado: hay que examinar cómo afectan al dominio y evaluar el modelo en las tareas concretas.
En consecuencia, «el modelo aprendió de imágenes sin etiquetas» es una descripción incompleta. Para interpretar el resultado conviene conocer qué transformaciones se usaron, cómo se definió la comparación y con qué pruebas posteriores se midió la transferencia.
Ejemplo en audio: representaciones de voz con wav2vec 2.0
El aprendizaje autosupervisado también se aplica al habla. wav2vec 2.0 aprende representaciones a partir de audio sin requerir transcripciones para construir su objetivo de preentrenamiento. En términos generales, calcula representaciones latentes del audio, enmascara parte de ellas y entrena el sistema con una tarea contrastiva para identificar las representaciones objetivo correspondientes.
Este procedimiento puede aprender regularidades acústicas a partir de grabaciones sin transcribir cada fragmento. Después, las representaciones pueden usarse o ajustarse para tareas que sí requieren texto de referencia, como el reconocimiento automático del habla. En ese segundo paso, pueden intervenir datos transcritos: la presencia de una etapa etiquetada posterior no cambia el hecho de que el objetivo anterior fuera autosupervisado.
La distinción importa al describir un sistema completo. Decir que un modelo de voz se preentrenó de forma autosupervisada no indica cuántas transcripciones se usaron en el ajuste, cómo se evaluó ni qué rendimiento ofrece en distintos acentos, condiciones de grabación o idiomas. Esas cuestiones requieren información y pruebas adicionales; no se deducen solo del nombre del método.
Conceptos próximos que no son sinónimos
Aprendizaje no supervisado es un término amplio para métodos que buscan estructura en datos sin etiquetas objetivo proporcionadas de forma convencional. El aprendizaje autosupervisado suele tratarse como un enfoque relacionado: construye una señal de predicción a partir de los datos. Según el campo y el uso de los términos, las categorías pueden solaparse, por lo que es más preciso explicar el objetivo concreto que depender solo de una etiqueta general.
El aprendizaje semisupervisado combina datos etiquetados y no etiquetados en el proceso de aprendizaje. No es sinónimo de autosupervisado. FixMatch, por ejemplo, describe un método semisupervisado que usa datos etiquetados y aprovecha datos no etiquetados mediante consistencia y pseudoetiquetas. Un método autosupervisado, en cambio, puede generar su objetivo a partir de los datos sin necesitar una etiqueta manual específica para cada ejemplo de ese objetivo.
Una pseudoetiqueta es una etiqueta generada por un modelo o procedimiento y usada como objetivo para otros ejemplos; no equivale automáticamente a una señal autosupervisada derivada directamente de la estructura de la muestra. Algunos métodos semisupervisados emplean pseudoetiquetas, como parte de su estrategia. La procedencia y el uso de esa etiqueta son lo que hay que describir.
Preentrenamiento nombra una etapa del ciclo de vida del modelo, no una única forma de aprender. Puede realizarse con objetivos autosupervisados, pero «preentrenado» no significa necesariamente «autosupervisado». Del mismo modo, un objetivo autosupervisado puede utilizarse sin que la palabra preentrenamiento describa por completo el sistema. Paradigma de aprendizaje y etapa de entrenamiento responden a preguntas distintas.
Guía para distinguir términos
| Término | Pregunta que responde | Distinción práctica |
|---|---|---|
| Autosupervisado | ¿De dónde sale el objetivo de entrenamiento? | De relaciones o estructuras derivadas de los propios datos. |
| Semisupervisado | ¿Qué combinación de datos se aprovecha? | Combina datos etiquetados y no etiquetados; puede emplear pseudoetiquetas. |
| Pseudoetiquetado | ¿Cómo se asigna una etiqueta a un ejemplo? | Una etiqueta generada se usa como objetivo; puede formar parte de un método semisupervisado. |
| Preentrenamiento | ¿En qué etapa se entrena el modelo? | Es una etapa previa a otro uso o ajuste; no especifica por sí sola el tipo de supervisión. |
Límites, sesgos y errores frecuentes
Un objetivo autosupervisado puede ser fácil de optimizar y, aun así, no enseñar lo necesario para la tarea final. La calidad de una representación o el resultado en una evaluación del propio preentrenamiento no constituyen una prueba universal de buen desempeño en tareas posteriores. La transferencia debe comprobarse con evaluaciones adecuadas al uso, y no suponerse a partir de una sola cifra.
La ausencia de etiquetas manuales para el objetivo tampoco elimina sesgos. Los datos pueden reflejar desequilibrios de cobertura, errores de captura, convenciones históricas o diferencias entre las poblaciones representadas. El filtrado del corpus, las transformaciones aplicadas, la selección de ejemplos y los criterios de evaluación son decisiones que pueden influir en los resultados. «Autosupervisado» no es una garantía de neutralidad.
Otro error frecuente es presentar el enfoque como aprendizaje completamente autónomo. Aunque la señal se derive de los datos, alguien debe escoger el corpus y el objetivo, entrenar el sistema y decidir qué cuenta como resultado satisfactorio. También es incorrecto inferir que un modelo no empleó datos etiquetados en ninguna fase solo porque su preentrenamiento fue autosupervisado.
Por último, no se debe confundir la capacidad de resolver una tarea auxiliar con la utilidad práctica. Predecir tokens ocultos, relacionar vistas visuales o aprender representaciones de audio son objetivos definidos; cada uno revela algo sobre lo que el sistema optimizó, pero no reemplaza la evaluación de precisión, robustez o adecuación en el contexto de destino.
Criterios prácticos para interpretar una afirmación
Ante la afirmación de que un modelo aprendió de forma autosupervisada, pregunta primero qué objetivo se construyó a partir de los datos: ¿se ocultaron elementos?, ¿se compararon transformaciones?, ¿se enmascararon representaciones? Después identifica en qué fase se usó ese objetivo y si hubo ajuste posterior con etiquetas. Esta separación evita mezclar el paradigma de aprendizaje con el ciclo de vida del modelo.
A continuación, revisa qué datos y transformaciones participaron. La tarea puede reflejar regularidades útiles, pero también las limitaciones del corpus y de las decisiones de diseño. Comprueba qué evaluación respalda la transferencia a la aplicación que te interesa; un resultado de preentrenamiento por sí solo no basta para establecerla.
Para comparar métodos, describe la señal de entrenamiento y las condiciones de evaluación antes de comparar nombres. En una comparación del glosario o una guía comparativa, conviene mantener separadas las categorías de autosupervisado, semisupervisado y preentrenamiento. Para explorar otros conceptos del glosario, consulta las entradas relacionadas, como aprendizaje autosupervisado, y los términos de arquitectura o evaluación que expliquen el sistema completo.
En la práctica, una descripción rigurosa debería especificar: qué se tomó como objetivo, qué datos se usaron, qué transformaciones o relaciones generaron la señal, qué etapas posteriores incorporaron etiquetas y cómo se evaluó el desempeño final. Si alguna de esas piezas no está documentada, la conclusión debe limitarse a lo que sí se conoce. La regla final es sencilla: «autosupervisado» explica cómo se obtuvo una señal de entrenamiento, no garantiza qué aprenderá el modelo ni cómo se comportará fuera de esa tarea.
Lista breve de comprobación
- 01Identificar el objetivo que se deriva de los datos.
- 02Separar preentrenamiento, ajuste y evaluación.
- 03Comprobar si hubo datos etiquetados en otras etapas.
- 04Examinar la cobertura del corpus y el papel de las transformaciones.
- 05Buscar resultados en tareas posteriores y condiciones relevantes para el uso previsto.
- 06Expresar las conclusiones sin convertir la etiqueta del método en una garantía.