Definizione in una frase
Entrenamiento que obtiene sus señales de supervisión de la propia estructura de los datos, por ejemplo prediciendo partes ocultas de un texto.
Definizione: supervisione ricavata dai dati
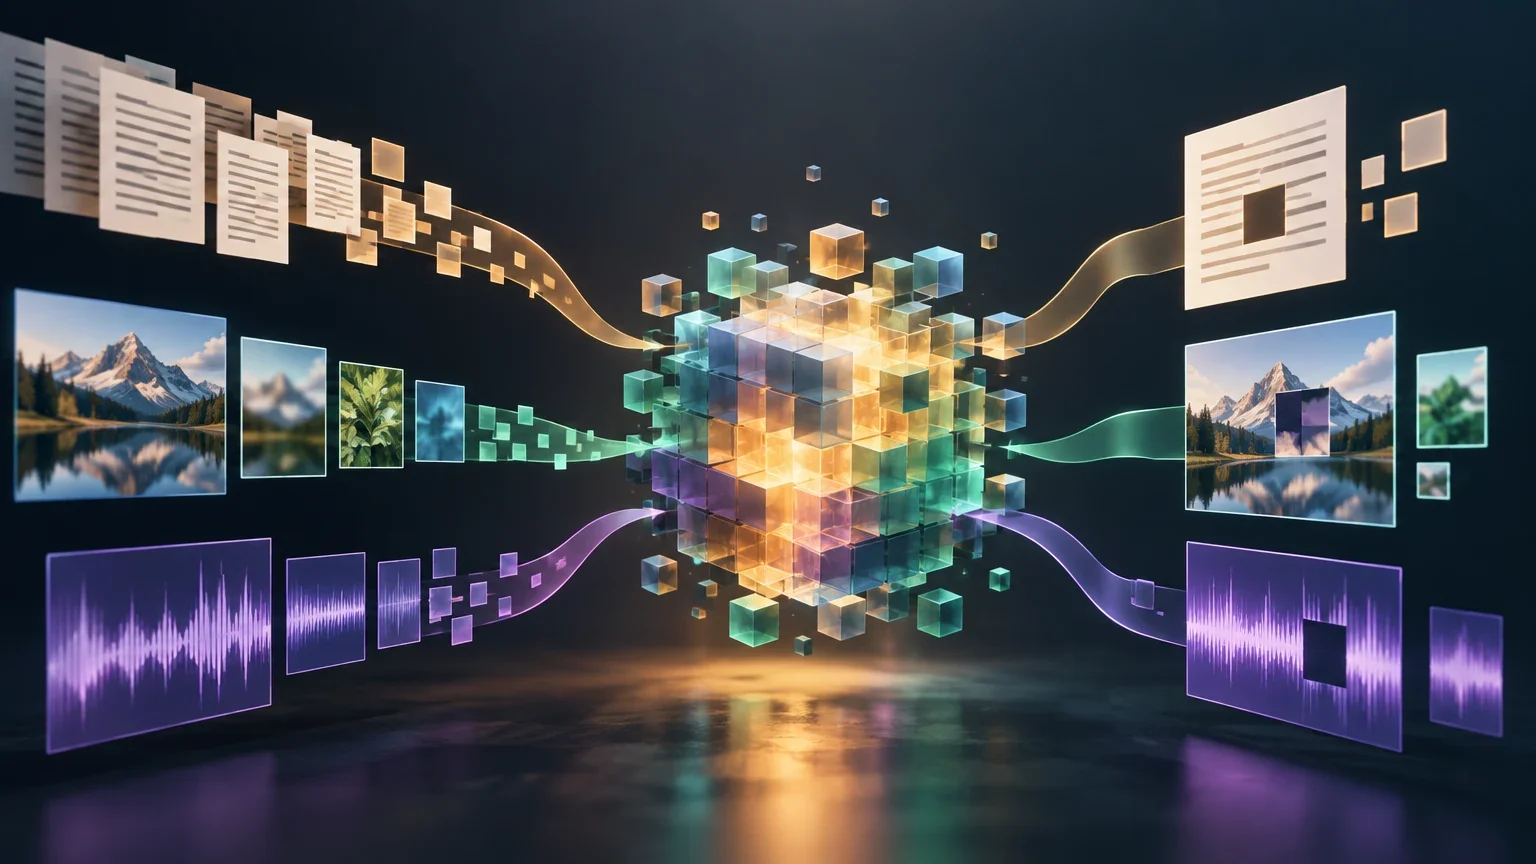
L’apprendimento autosupervisionato è un approccio di apprendimento automatico nel quale il sistema ricava il segnale di addestramento dalla struttura o dal contenuto dei dati stessi, invece di affidarsi a etichette annotate appositamente da persone per ogni esempio. Un metodo comune consiste nel nascondere, trasformare o suddividere un campione e addestrare il modello a predire una parte a partire da un’altra. Il compito di predizione che ne risulta viene spesso chiamato compito ausiliario, o obiettivo autosupervisionato.
La parola «autosupervisionato» descrive l’origine del segnale usato durante una determinata fase di addestramento; non significa che il modello impari senza alcun intervento umano, senza decisioni di progettazione o senza valutazione. Qualcuno ha scelto i dati, definito l’obiettivo, deciso quali trasformazioni applicare e stabilito come misurare il risultato. Queste decisioni potrebbero non richiedere un’etichetta manuale per ogni singolo elemento, ma influenzano comunque ciò che il sistema apprende.
Non significa nemmeno che il set di dati sia del tutto privo di informazioni etichettate. Un progetto può combinare diverse fasi: prima, apprendere rappresentazioni tramite obiettivi autosupervisionati su dati non annotati; poi, mettere a punto o valutare il modello con esempi etichettati. Perciò, quando si legge l’etichetta «autosupervisionato», è utile chiedersi a quale fase si riferisca e quali dati siano stati usati in ciascuna fase.
La definizione operativa è semplice: un metodo può dirsi autosupervisionato se l’obiettivo di addestramento viene costruito a partire dal campione o dalle relazioni tra campioni, senza richiedere per ciascun caso un’annotazione umana specifica per quell’obiettivo. Questo, da solo, non determina l’architettura, le dimensioni del modello, la qualità delle rappresentazioni apprese o le prestazioni in un’applicazione successiva.
Come funziona: dal campione a una rappresentazione valutabile
Un flusso di lavoro autosupervisionato si può descrivere in tre passaggi. Per prima cosa, si decide quale relazione interna ai dati possa essere utile per l’addestramento: per esempio, quale parola potrebbe occupare una posizione nascosta, quali due viste derivino dalla stessa immagine o quali segmenti audio corrispondano a una rappresentazione mascherata. In secondo luogo, il modello produce predizioni e viene ottimizzato per avvicinarle all’obiettivo ricavato dai dati. Infine, si verifica che cosa abbia appreso: si valuta il modello, si riutilizzano le sue rappresentazioni oppure si mettono a punto i suoi parametri con dati relativi a un compito specifico.
Una rappresentazione appresa è una descrizione interna dei dati che il modello usa per risolvere il compito di addestramento. Può risultare utile per altri problemi, ma il trasferimento non è automatico né garantito. Una rappresentazione che aiuta a distinguere le relazioni messe in evidenza dall’obiettivo ausiliario potrebbe non conservare le informazioni necessarie per un compito diverso. La valutazione successiva, quindi, dovrebbe essere pertinente all’uso previsto del sistema.
Il compito ausiliario non è un passaggio neutrale. Se si nasconde una parte, occorre scegliere che cosa nascondere; se si creano due viste, si decide quali trasformazioni applicare; se si confrontano esempi, si definisce che cosa conti come positivo o negativo. Queste scelte mettono in risalto determinate regolarità. In termini pratici, quanto più la regolarità appresa è distante dalle capacità richieste dall’applicazione, tanto più è importante misurare direttamente il trasferimento.
Ciclo di lavoro
- 01Selezionare i dati e definire quale struttura o relazione verrà usata come segnale.
- 02Costruire l’obiettivo: nascondere, trasformare, abbinare o confrontare parti dei dati.
- 03Addestrare il modello a risolvere l’obiettivo senza richiedere un’etichetta manuale specifica per ogni esempio.
- 04Valutare la rappresentazione su compiti pertinenti e, se opportuno, metterla a punto con dati etichettati.
- 05Esaminare gli errori, la copertura e le possibili differenze tra i dati di addestramento e l’uso previsto.
Esempio nel linguaggio: predire token nascosti con BERT
BERT è un esempio tecnico di modellazione del linguaggio autosupervisionata. Nel suo obiettivo di modellazione del linguaggio mascherata, alcuni token di una sequenza vengono nascosti e il modello viene addestrato a predirli usando il contesto disponibile. In questo modo si crea un compito di predizione a partire dal testo stesso, senza chiedere a una persona di annotare manualmente la parola corretta per ogni posizione.
Per esempio, davanti a una frase come «La scienziata ha pubblicato il risultato sulla [nascosta]», il modello deve usare le parole circostanti per stimare quale token sia stato nascosto. È un esempio schematico: durante l’addestramento vengono elaborati molti segmenti di testo e l’obiettivo consiste nel recuperare le posizioni mascherate. Nella configurazione originale di preaddestramento, BERT includeva anche un compito di predizione della frase successiva; questo obiettivo aggiuntivo non va confuso con la definizione generale di apprendimento autosupervisionato.
L’obiettivo insegna al modello a sfruttare il contesto testuale per risolvere le predizioni proposte. Non dimostra, di per sé, che il sistema comprenda una frase come una persona né che risponda con precisione a qualsiasi domanda. Per un’applicazione concreta, bisognerebbe valutare il comportamento su compiti pertinenti e verificare se l’eventuale messa a punto successiva migliori le capacità necessarie.
Esempio nella visione artificiale: confrontare viste di un’immagine con SimCLR
Nella visione artificiale, un approccio può creare due versioni trasformate della stessa immagine e addestrare un modello a mettere in relazione le loro rappresentazioni in uno spazio appreso. SimCLR è un esempio di apprendimento contrastivo di rappresentazioni visive: il suo obiettivo usa coppie di viste trasformate e la composizione delle trasformazioni influenza il compito che il modello finisce per svolgere.
Immaginiamo la fotografia di una bicicletta. Il metodo genera due viste applicando le trasformazioni prescelte. Durante l’addestramento, il modello impara a riconoscere la relazione tra le due viste come appartenenti alla stessa immagine, distinguendole da altri campioni presenti nel lotto. Per costruire questo obiettivo non gli viene necessariamente fornita un’etichetta manuale come «bicicletta». Il segnale di addestramento è la relazione tra le viste.
La scelta delle trasformazioni è importante. Se le due versioni conservano le caratteristiche pertinenti all’uso previsto, il compito potrebbe favorire rappresentazioni utili per quell’uso; se invece eliminano o distorcono informazioni importanti, l’obiettivo potrebbe mettere in risalto proprietà diverse. Non si può quindi concludere in anticipo che qualsiasi insieme di trasformazioni sia adeguato: occorre esaminarne gli effetti sul dominio e valutare il modello sui compiti concreti.
Di conseguenza, dire «il modello ha imparato da immagini senza etichette» è una descrizione incompleta. Per interpretare il risultato, è utile sapere quali trasformazioni siano state usate, come sia stato definito il confronto e quali prove successive siano servite a misurare il trasferimento.
Esempio nell’audio: rappresentazioni vocali con wav2vec 2.0
L’apprendimento autosupervisionato si applica anche al parlato. wav2vec 2.0 apprende rappresentazioni a partire da audio senza richiedere trascrizioni per costruire l’obiettivo di preaddestramento. In termini generali, calcola rappresentazioni latenti dell’audio, ne maschera una parte e addestra il sistema con un compito contrastivo per identificare le rappresentazioni obiettivo corrispondenti.
Questa procedura può apprendere regolarità acustiche da registrazioni senza trascrivere ogni segmento. In seguito, le rappresentazioni possono essere usate o messe a punto per compiti che richiedono un riferimento testuale, come il riconoscimento automatico del parlato. In questa seconda fase possono intervenire dati trascritti: la presenza di una fase successiva supervisionata non cambia il fatto che l’obiettivo precedente fosse autosupervisionato.
Questa distinzione è importante quando si descrive un sistema completo. Dire che un modello vocale è stato preaddestrato in modo autosupervisionato non chiarisce quante trascrizioni siano state usate per la messa a punto, come sia avvenuta la valutazione né quali prestazioni offra con accenti, condizioni di registrazione o lingue differenti. Servono informazioni e prove aggiuntive: questi aspetti non si deducono dal solo nome del metodo.
Concetti affini che non sono sinonimi
Apprendimento non supervisionato è un termine ampio per indicare metodi che cercano strutture nei dati senza etichette-obiettivo fornite nel modo convenzionale. L’apprendimento autosupervisionato viene spesso considerato un approccio correlato: costruisce un segnale di predizione a partire dai dati. A seconda del campo e dell’uso dei termini, le categorie possono sovrapporsi. Perciò è più preciso spiegare l’obiettivo specifico che affidarsi soltanto a un’etichetta generale.
L’apprendimento semisupervisionato combina dati etichettati e non etichettati nel processo di apprendimento. Non è sinonimo di apprendimento autosupervisionato. FixMatch, per esempio, descrive un metodo semisupervisionato che usa dati etichettati e sfrutta quelli non etichettati tramite coerenza e pseudo-etichette. Un metodo autosupervisionato, invece, può generare il proprio obiettivo dai dati senza richiedere un’etichetta manuale specifica per ciascun esempio coinvolto nell’obiettivo.
Una pseudo-etichetta è un’etichetta generata da un modello o da una procedura e usata come obiettivo per altri esempi; non equivale automaticamente a un segnale autosupervisionato ricavato direttamente dalla struttura del campione. Alcuni metodi semisupervisionati usano pseudo-etichette come parte della propria strategia. Ciò che occorre descrivere è la provenienza dell’etichetta e il modo in cui viene usata.
Preaddestramento indica una fase del ciclo di vita del modello, non un unico modo di apprendere. Può essere svolto con obiettivi autosupervisionati, ma «preaddestrato» non significa necessariamente «autosupervisionato». Allo stesso modo, un obiettivo autosupervisionato può essere usato senza che la parola preaddestramento descriva da sola l’intero sistema. Il paradigma di apprendimento e la fase di addestramento rispondono a domande diverse.
Guida per distinguere i termini
| Termine | A quale domanda risponde? | Distinzione pratica |
|---|---|---|
| Autosupervisionato | Da dove proviene l’obiettivo di addestramento? | Da relazioni o strutture ricavate dai dati stessi. |
| Semisupervisionato | Quale combinazione di dati viene sfruttata? | Combina dati etichettati e non etichettati; può usare pseudo-etichette. |
| Pseudo-etichettatura | Come viene assegnata un’etichetta a un esempio? | Si usa come obiettivo un’etichetta generata; può far parte di un metodo semisupervisionato. |
| Preaddestramento | In quale fase viene addestrato il modello? | È una fase che precede un altro uso o la messa a punto; non specifica, da sola, il tipo di supervisione. |
Limiti, distorsioni ed errori frequenti
Un obiettivo autosupervisionato può essere facile da ottimizzare e, allo stesso tempo, non insegnare ciò che serve per il compito finale. La qualità di una rappresentazione o il risultato ottenuto nella valutazione del preaddestramento non costituiscono una prova universale di buone prestazioni nei compiti successivi. Il trasferimento va verificato con valutazioni adeguate all’uso previsto e non dato per scontato sulla base di un unico risultato.
L’assenza di etichette manuali per l’obiettivo non elimina neppure le distorsioni. I dati possono riflettere una copertura squilibrata, errori di acquisizione, convenzioni storiche o differenze tra le popolazioni rappresentate. Il filtraggio del corpus, le trasformazioni applicate, la selezione degli esempi e i criteri di valutazione sono decisioni che possono influenzare i risultati. «Autosupervisionato» non garantisce neutralità.
Un altro errore frequente è descrivere questo approccio come un apprendimento del tutto autonomo. Anche quando il segnale viene ricavato dai dati, qualcuno deve scegliere il corpus e l’obiettivo, addestrare il sistema e decidere che cosa conti come risultato soddisfacente. È inoltre sbagliato dedurre che un modello non abbia usato dati etichettati in nessuna fase solo perché il suo preaddestramento era autosupervisionato.
Infine, non si deve confondere la capacità di risolvere un compito ausiliario con l’utilità pratica. Predire token nascosti, mettere in relazione viste di immagini o apprendere rappresentazioni audio sono obiettivi definiti. Ciascuno rivela qualcosa su ciò che il sistema ha ottimizzato, ma non sostituisce la valutazione di accuratezza, robustezza o adeguatezza nel contesto di destinazione.
Criteri pratici per interpretare un’affermazione
Quando si afferma che un modello ha appreso in modo autosupervisionato, la prima domanda da porsi è quale obiettivo sia stato costruito a partire dai dati: sono stati nascosti alcuni elementi? Sono state confrontate trasformazioni? Sono state mascherate delle rappresentazioni? Poi occorre individuare la fase in cui è stato usato quell’obiettivo e verificare se in seguito sia avvenuta una messa a punto con etichette. Questa distinzione evita di confondere il paradigma di apprendimento con il ciclo di vita del modello.
In seguito, è utile esaminare quali dati e trasformazioni siano stati coinvolti. Il compito può far emergere regolarità utili, ma anche i limiti del corpus e delle decisioni di progettazione. Verifica quali valutazioni sostengano il trasferimento all’applicazione che ti interessa: un risultato di preaddestramento, da solo, non basta a dimostrarlo.
Per confrontare i metodi, è meglio descrivere il segnale di addestramento e le condizioni di valutazione prima di confrontare i nomi. In una guida comparativa o nel glossario, conviene tenere distinte le categorie di apprendimento autosupervisionato, semisupervisionato e preaddestramento. Per approfondire altri concetti del glossario, consulta le voci correlate, come apprendimento autosupervisionato, e i termini relativi all’architettura o alla valutazione che aiutano a descrivere il sistema completo.
Una descrizione rigorosa dovrebbe specificare, nella pratica, quale fosse l’obiettivo, quali dati siano stati utilizzati, quali trasformazioni o relazioni abbiano generato il segnale, quali fasi successive abbiano introdotto etichette e come siano state valutate le prestazioni finali. Se una di queste informazioni non è documentata, le conclusioni dovrebbero limitarsi a ciò che è noto. La regola conclusiva è semplice: «autosupervisionato» spiega come è stato ottenuto un segnale di addestramento; non garantisce che cosa apprenderà il modello né come si comporterà al di fuori di quel compito.
Breve lista di controllo
- 01Individuare l’obiettivo ricavato dai dati.
- 02Distinguere tra preaddestramento, messa a punto e valutazione.
- 03Verificare se siano stati usati dati etichettati in altre fasi.
- 04Esaminare la copertura del corpus e il ruolo delle trasformazioni.
- 05Cercare risultati su compiti successivi e in condizioni pertinenti all’uso previsto.
- 06Formulare le conclusioni senza trasformare l’etichetta del metodo in una garanzia.