Définition en une phrase
Entrenamiento que obtiene sus señales de supervisión de la propia estructura de los datos, por ejemplo prediciendo partes ocultas de un texto.
Définition : une supervision construite à partir des données
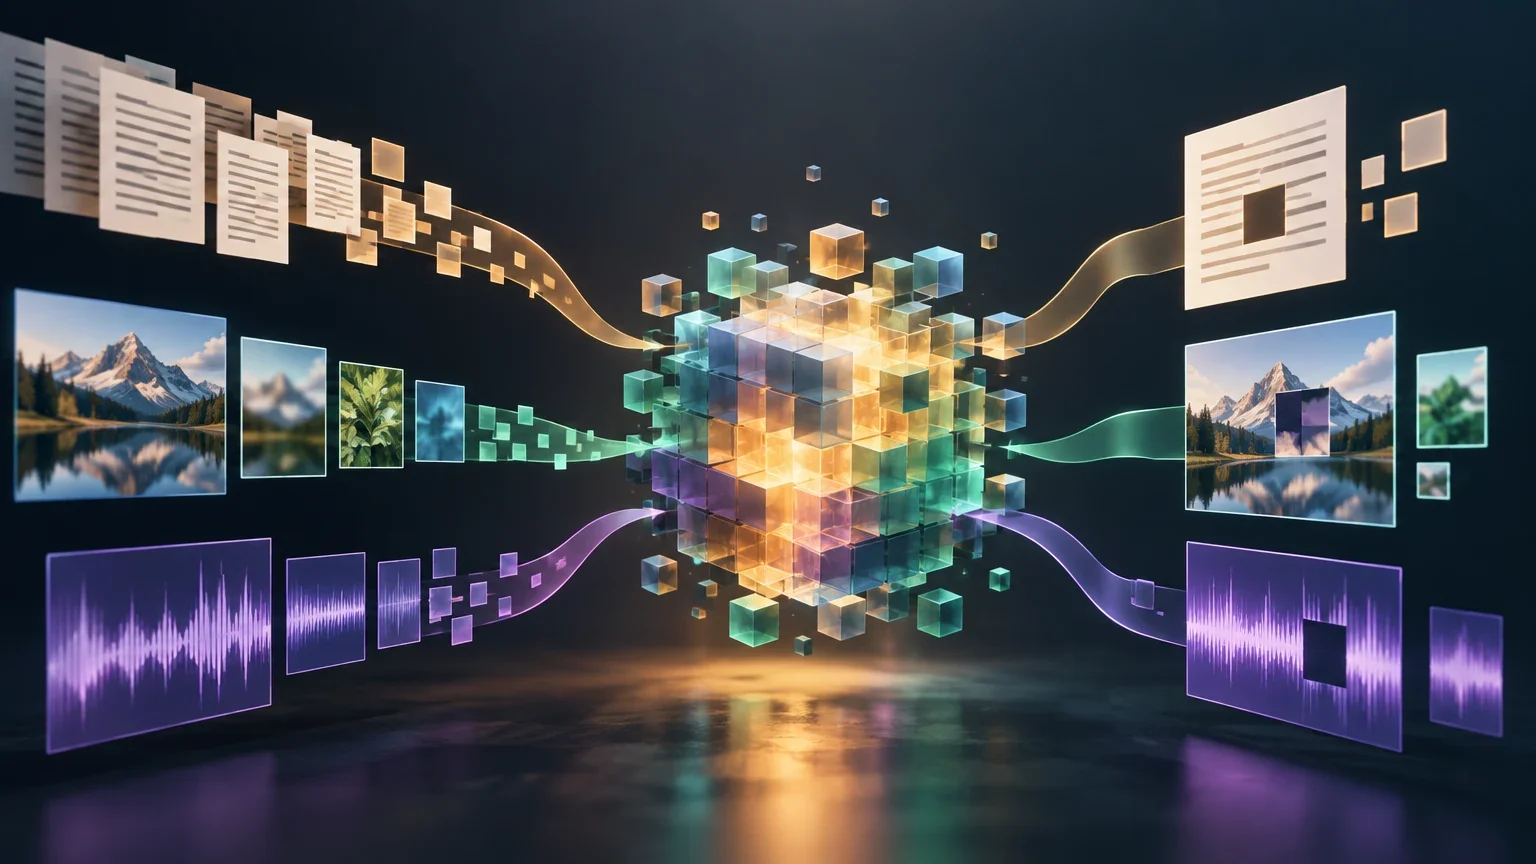
L’apprentissage autosupervisé est une approche de l’apprentissage automatique dans laquelle le système tire son signal d’entraînement de la structure ou du contenu des données elles-mêmes, plutôt que de s’appuyer sur des étiquettes annotées spécifiquement par des personnes pour chaque exemple. Une méthode courante consiste à masquer, transformer ou scinder un échantillon, puis à entraîner le modèle à prédire une partie à partir d’une autre. La tâche de prédiction ainsi obtenue est souvent appelée tâche prétexte ou objectif autosupervisé.
Le terme « autosupervisé » indique l’origine du signal utilisé pendant une partie de l’entraînement ; il ne signifie pas que le modèle apprend sans aucune intervention humaine, sans choix de conception ni sans évaluation. Quelqu’un a sélectionné les données, défini l’objectif, décidé des transformations à appliquer et fixé la manière de mesurer les résultats. Ces choix peuvent ne pas exiger d’étiquette manuelle pour chaque élément, mais ils influencent malgré tout ce que le système apprend.
Cela ne signifie pas non plus que le jeu de données soit entièrement dépourvu d’informations étiquetées. Un projet peut comporter plusieurs étapes : apprendre d’abord des représentations à l’aide d’objectifs autosupervisés sur des données non annotées, puis affiner ou évaluer le modèle à partir d’exemples étiquetés. Il est donc utile de demander quelle étape est qualifiée d’« autosupervisée » et quelles données ont été utilisées à chacune d’elles.
La définition la plus utile est opérationnelle : si l’objectif d’entraînement est construit à partir de l’échantillon ou des relations entre les échantillons, sans nécessiter pour cet objectif une annotation humaine spécifique de chaque exemple, la méthode peut être dite autosupervisée. À lui seul, ce terme ne précise ni l’architecture, ni la taille du modèle, ni la qualité des représentations, ni les performances sur une application ultérieure.
Fonctionnement : de l’échantillon à une représentation évaluable
Un processus autosupervisé peut se décrire en trois étapes. Premièrement, on choisit la relation au sein des données qui servira à l’entraînement : par exemple, le mot qui pourrait occuper une position masquée, les deux vues issues d’une même image ou les parties d’un signal audio correspondant à une représentation masquée. Deuxièmement, le modèle produit des prédictions et est optimisé afin de les rapprocher de la cible dérivée des données. Troisièmement, on vérifie ce qu’il a appris : on évalue le modèle, on réutilise ses représentations ou on ajuste ses paramètres pour une tâche précise.
La représentation apprise est une description interne des données que le modèle utilise pour résoudre la tâche d’entraînement. Elle peut être utile à d’autres problèmes, mais son transfert n’est jamais garanti automatiquement. Une représentation qui aide à distinguer les relations mises en avant par la tâche prétexte peut ne pas conserver les informations nécessaires à une autre tâche. L’évaluation ultérieure doit donc correspondre à l’usage visé.
La tâche prétexte n’est pas une simple étape neutre. Si une partie est masquée, il faut choisir laquelle ; si deux vues sont générées, il faut décider des transformations à appliquer ; si des exemples sont comparés, il faut définir ce qui compte comme positif ou négatif. Ces choix mettent l’accent sur certaines régularités. En pratique, plus la régularité apprise est éloignée des performances requises par l’application, plus il est important de mesurer directement le transfert.
Cycle de travail
- 01Sélectionner les données et définir la structure ou la relation qui servira de signal.
- 02Construire l’objectif : masquer, transformer, associer ou comparer des parties des données.
- 03Entraîner le modèle à résoudre cet objectif sans exiger d’étiquette manuelle spécifique pour chaque exemple.
- 04Évaluer la représentation sur des tâches pertinentes et, si nécessaire, l’affiner à l’aide de données étiquetées.
- 05Examiner les erreurs, la couverture et les différences possibles entre les données d’entraînement et l’usage prévu.
Exemple en langage : prédire des tokens masqués avec BERT
BERT fournit un exemple technique de modélisation du langage autosupervisée. Dans son objectif de modélisation du langage masqué, certains tokens d’une séquence sont masqués et le modèle est entraîné à les prédire à partir du contexte disponible. La tâche de prédiction est ainsi construite à partir du texte lui-même, au lieu de demander à une personne d’annoter manuellement le mot correct à chaque position.
Par exemple, face à une phrase comme « La scientifique a publié le résultat dans la [masquée] », le modèle doit utiliser les mots qui entourent le blanc pour estimer le token qui a été masqué. Cet exemple est schématique : pendant l’entraînement, de nombreux fragments de texte sont traités et l’objectif consiste à retrouver les positions masquées. Dans sa configuration de préentraînement d’origine, BERT proposait également une tâche de prédiction de la phrase suivante ; cette tâche supplémentaire ne doit pas être confondue avec la définition générale de l’apprentissage autosupervisé.
Cet objectif apprend au modèle à exploiter le contexte textuel pour effectuer les prédictions demandées. Il ne démontre pas, à lui seul, que le système comprend une phrase comme le ferait une personne ni qu’il répondra correctement à n’importe quelle question. Pour une application donnée, il faut évaluer son comportement sur des tâches pertinentes et vérifier si l’affinage ultérieur améliore les capacités recherchées.
Exemple en vision : comparer des vues d’une image avec SimCLR
En vision par ordinateur, une approche peut créer deux versions transformées d’une même image et entraîner un modèle à rapprocher leurs représentations dans un espace appris. SimCLR est un exemple d’apprentissage contrastif de représentations visuelles : son objectif utilise des paires de vues transformées, et la composition des transformations influe sur la tâche que le modèle apprend finalement à résoudre.
Imaginons une photographie de vélo. La méthode en produit deux vues à l’aide de transformations choisies. L’entraînement cherche à faire reconnaître au modèle que ces deux vues proviennent de la même image, en les distinguant d’autres échantillons du lot. Pour construire cet objectif, il n’est pas nécessaire de lui fournir une étiquette manuelle telle que « vélo ». C’est la relation entre les vues qui sert de signal d’entraînement.
Le choix des transformations est important. Si les deux versions conservent les caractéristiques pertinentes pour l’usage prévu, la tâche peut favoriser des représentations utiles à cet usage ; si elles suppriment ou déforment des informations importantes, l’objectif peut mettre l’accent sur d’autres propriétés. On ne peut pas en conclure à l’avance que n’importe quel ensemble de transformations convient : il faut examiner ses effets sur le domaine et évaluer le modèle sur les tâches précises.
Par conséquent, dire qu’« un modèle a appris à partir d’images sans étiquettes » est incomplet. Pour interpréter le résultat, il faut savoir quelles transformations ont été appliquées, comment la comparaison a été définie et quels tests ultérieurs ont servi à mesurer le transfert.
Exemple en audio : des représentations de la parole avec wav2vec 2.0
L’apprentissage autosupervisé s’applique également à la parole. wav2vec 2.0 apprend des représentations à partir de données audio sans avoir besoin de transcriptions pour construire son objectif de préentraînement. En termes généraux, le modèle calcule des représentations latentes de l’audio, en masque une partie et s’entraîne à l’aide d’une tâche contrastive pour identifier les représentations cibles correspondantes.
Cette procédure peut apprendre des régularités acoustiques à partir d’enregistrements sans transcrire chaque fragment. Les représentations peuvent ensuite être utilisées ou affinées pour des tâches qui nécessitent un texte de référence, comme la reconnaissance automatique de la parole. Cette seconde étape peut faire intervenir des données transcrites : l’existence d’une étape étiquetée ultérieure ne change pas la nature autosupervisée de l’objectif précédent.
Cette distinction est importante lorsqu’on décrit un système dans son ensemble. Dire qu’un modèle de parole a été préentraîné de manière autosupervisée ne précise ni le nombre de transcriptions utilisées lors de l’affinage, ni la manière dont il a été évalué, ni ses performances selon les accents, les conditions d’enregistrement ou les langues. Ces questions nécessitent des informations et des tests supplémentaires ; elles ne découlent pas du seul nom de la méthode.
Des notions proches, mais non synonymes
L’apprentissage non supervisé est un terme large qui désigne des méthodes visant à trouver une structure dans des données sans étiquettes cibles fournies de manière conventionnelle. L’apprentissage autosupervisé est souvent considéré comme une approche apparentée : il construit un signal de prédiction à partir des données. Les catégories peuvent se chevaucher selon les disciplines et l’usage des termes ; il est donc plus précis de décrire l’objectif concret que de s’appuyer uniquement sur une étiquette générale.
L’apprentissage semi-supervisé combine des données étiquetées et non étiquetées au cours du processus d’apprentissage. Il n’est pas synonyme d’apprentissage autosupervisé. FixMatch, par exemple, décrit une méthode semi-supervisée qui utilise des données étiquetées et tire parti des données non étiquetées au moyen de la cohérence et de pseudo-étiquettes. En revanche, une méthode autosupervisée peut générer son objectif à partir des données sans nécessiter d’étiquette manuelle spécifique pour chaque exemple correspondant à cet objectif.
Une pseudo-étiquette est une étiquette générée par un modèle ou une procédure, puis utilisée comme cible pour d’autres exemples ; elle n’équivaut pas automatiquement à un signal autosupervisé directement dérivé de la structure d’un échantillon. Certaines méthodes semi-supervisées utilisent des pseudo-étiquettes dans le cadre de leur stratégie. Il convient de décrire l’origine et l’utilisation de cette étiquette.
Le préentraînement désigne une étape du cycle de vie du modèle, et non une méthode d’apprentissage unique. Il peut reposer sur des objectifs autosupervisés, mais « préentraîné » ne signifie pas nécessairement « autosupervisé ». Inversement, un objectif autosupervisé peut être utilisé sans que le mot préentraînement décrive à lui seul l’ensemble du système. Le paradigme d’apprentissage et l’étape d’entraînement répondent à des questions différentes.
Repères pour distinguer les termes
| Terme | Question à laquelle il répond | Distinction pratique |
|---|---|---|
| Autosupervisé | D’où vient l’objectif d’entraînement ? | De relations ou de structures dérivées des données elles-mêmes. |
| Semi-supervisé | Quelle combinaison de données est exploitée ? | Combine des données étiquetées et non étiquetées ; peut faire appel à des pseudo-étiquettes. |
| Pseudo-étiquetage | Comment une étiquette est-elle attribuée à un exemple ? | Une étiquette générée est utilisée comme cible ; elle peut faire partie d’une méthode semi-supervisée. |
| Préentraînement | À quelle étape le modèle est-il entraîné ? | Étape préalable à un autre usage ou à un affinage ; elle ne précise pas, à elle seule, le type de supervision. |
Limites, biais et erreurs fréquentes
Un objectif autosupervisé peut être facile à optimiser sans pour autant enseigner ce qui est nécessaire à la tâche finale. La qualité d’une représentation ou le résultat obtenu sur une évaluation du préentraînement ne constituent pas une preuve universelle de bonnes performances sur des tâches ultérieures. Le transfert doit être vérifié au moyen d’évaluations adaptées à l’usage prévu, et non présumé à partir d’un seul indicateur.
L’absence d’étiquettes manuelles pour l’objectif n’élimine pas non plus les biais. Les données peuvent refléter des déséquilibres de couverture, des erreurs de collecte, des conventions historiques ou des différences entre les populations représentées. Le filtrage du corpus, les transformations appliquées, la sélection des exemples et les critères d’évaluation sont autant de décisions susceptibles d’influencer les résultats. « Autosupervisé » ne garantit pas la neutralité.
Une autre erreur fréquente consiste à présenter cette approche comme un apprentissage entièrement autonome. Même si le signal est dérivé des données, quelqu’un doit choisir le corpus et l’objectif, entraîner le système et décider de ce qui constitue un résultat satisfaisant. Il est également incorrect de déduire qu’un modèle n’a utilisé aucune donnée étiquetée à quelque étape que ce soit au seul motif que son préentraînement était autosupervisé.
Enfin, il ne faut pas confondre la capacité à résoudre une tâche auxiliaire avec l’utilité pratique. Prédire des tokens masqués, rapprocher des vues visuelles ou apprendre des représentations audio sont des objectifs définis. Chacun renseigne sur ce que le système a optimisé, mais aucun ne remplace l’évaluation de sa précision, de sa robustesse ou de son adéquation au contexte d’utilisation.
Critères pratiques pour interpréter une affirmation
Lorsqu’on affirme qu’un modèle a appris de manière autosupervisée, il faut d’abord demander quel objectif a été construit à partir des données : des éléments ont-ils été masqués ? Des transformations ont-elles été comparées ? Des représentations ont-elles été masquées ? Il faut ensuite déterminer à quelle étape cet objectif a été utilisé et si un affinage ultérieur a fait appel à des étiquettes. Cette distinction évite de confondre paradigme d’apprentissage et cycle de vie du modèle.
Il faut ensuite examiner les données et les transformations utilisées. La tâche peut refléter des régularités utiles, mais aussi les limites du corpus et des choix de conception. Vérifiez quelles évaluations étayent le transfert vers l’application qui vous intéresse : un résultat de préentraînement ne suffit pas, à lui seul, à l’établir.
Pour comparer des méthodes, décrivez le signal d’entraînement et les conditions d’évaluation avant de comparer les noms. Dans une comparaison du glossaire ou un guide comparatif, il est utile de garder distinctes les catégories autosupervisé, semi-supervisé et préentraînement. Pour découvrir d’autres notions du glossaire, consultez les entrées liées, comme celle sur l’apprentissage autosupervisé, ainsi que les termes d’architecture ou d’évaluation qui permettent de comprendre le système dans son ensemble.
En pratique, une description rigoureuse devrait préciser : ce qui a servi de cible, les données utilisées, les transformations ou relations qui ont produit le signal, les étapes ultérieures ayant fait appel à des étiquettes et la manière dont les performances finales ont été évaluées. Si l’un de ces éléments n’est pas documenté, les conclusions doivent se limiter à ce qui est effectivement connu. La règle finale est simple : « autosupervisé » explique comment un signal d’entraînement a été obtenu ; le terme ne garantit ni ce que le modèle apprendra ni son comportement au-delà de cette tâche.
Liste de vérification rapide
- 01Identifier l’objectif dérivé des données.
- 02Distinguer le préentraînement, l’affinage et l’évaluation.
- 03Vérifier si des données étiquetées ont été utilisées à d’autres étapes.
- 04Examiner la couverture du corpus et le rôle des transformations.
- 05Rechercher des résultats sur des tâches ultérieures et dans des conditions pertinentes pour l’usage prévu.
- 06Formuler les conclusions sans transformer l’étiquette de la méthode en garantie.