Definition in einem Satz
Fähigkeit, mehr als einen Informationstyp zu verarbeiten oder zu generieren, wie Text, Bild, Audio oder Video.
Definition und Begriffe, die nicht verwechselt werden sollten
Multimodalität bezeichnet die Fähigkeit eines KI-Systems, verschiedene Arten von Informationen, sogenannte Modalitäten, zu verarbeiten und miteinander zu verknüpfen. Dazu gehören beispielsweise Text, Audio, Bilder und Video. Unimodale Modelle arbeiten dagegen mit einer einzelnen Eingabeart. Multimodale Systeme sollen Informationen aus mehreren Formaten gemeinsam berücksichtigen – so wie sie in der realen Welt häufig auftreten. Das kann Aufgaben wie die Beantwortung visueller Fragen, die Suche nach Inhalten über verschiedene Formate hinweg oder die Beschreibung von Bildern unterstützen.
Multimodalität ist nicht gleichbedeutend mit unstrukturierten Daten. Ein Video ohne Transkript kann unstrukturiert sein, aber ein System ist erst dann multimodal, wenn es Informationen aus unterschiedlichen Modalitäten gezielt auswertet und in Beziehung setzt. Technisch entscheidend sind dabei Ausrichtung und Fusion: Das System muss bestimmen, welche Bestandteile verschiedener Modalitäten zusammengehören und wie es sie zu einer gemeinsamen Repräsentation kombiniert. Multimodalität ist auch nicht bloß einfaches Transferlernen. Sie erfordert Verfahren, mit denen die verschiedenen Informationsströme miteinander interagieren können.
Unimodale und multimodale Daten im Vergleich
Ein technischer Vergleich der Datenstrukturen und Verarbeitungsschritte.
| Merkmal | Unimodal | Multimodal |
|---|---|---|
| Eingaben | Eine Datenart, zum Beispiel nur Text | Mindestens zwei Datenarten, zum Beispiel Text und Bild |
| Struktur | Homogen, etwa Textsequenzen oder Bildmatrizen | Heterogen, etwa Tokens, Pixel und Schallwellen |
| Verarbeitung | Ein auf eine Modalität zugeschnittener Ablauf | Ausrichtung und Verknüpfung mehrerer Modalitäten |
| Komplexität | In der Regel geringerer Rechenaufwand | Häufig höherer Bedarf an Rechenleistung und Speicher |
Funktionsweise Schritt für Schritt
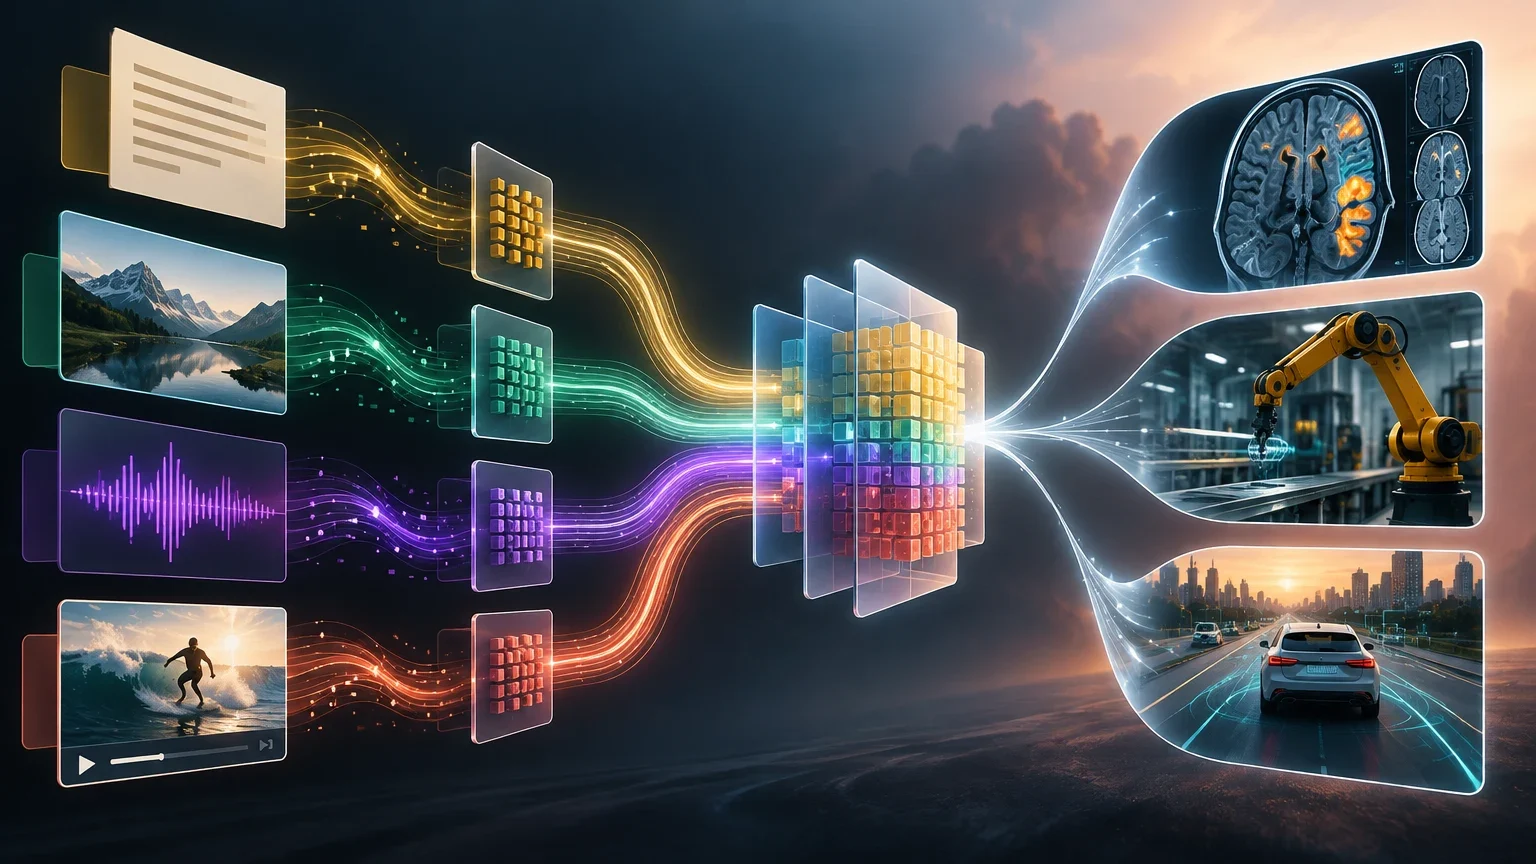
Ein multimodales Modell verarbeitet Rohdaten in mehreren Schritten zu einer gemeinsamen Repräsentation. Zuerst werden die Eingaben kodiert, also in Merkmale umgewandelt, mit denen das Modell arbeiten kann. Text wird üblicherweise tokenisiert und in Vektoren überführt. Bilder lassen sich etwa mit Vision Transformers (ViT) oder Faltungsnetzen (CNNs) verarbeiten, die Formen und räumliche Muster erfassen. Für Audio kommen spezialisierte Verfahren wie wav2vec infrage, die Merkmale von Sprache oder anderen Geräuschen abbilden.
Anschließend werden die Merkmale projiziert: Transformationen bringen sie in einen gemeinsamen oder kompatiblen Einbettungsraum. So können die Vektoren verschiedener Modalitäten miteinander verglichen und kombiniert werden. Bei der anschließenden Fusion werden die Merkmale zusammengeführt – beispielsweise durch Aneinanderreihen oder mithilfe komplexerer Verfahren wie Cross-Attention. Dabei kann eine Modalität, etwa Text, gezielt auf relevante Teile einer anderen Modalität, etwa Bildbereiche, zugreifen. Transformer-Schichten verarbeiten die kombinierten Merkmale weiter. Ein Decoder erzeugt schließlich die jeweilige Ausgabe, zum Beispiel Text, eine Klassifikation oder ein Bild.
Pipeline der multimodalen Verarbeitung
Eine vereinfachte Abfolge der technischen Verarbeitungsschritte.
- 01Kodierung: Rohdaten wie Text, Bild oder Audio werden in modalitätsspezifische Merkmalsvektoren umgewandelt.
- 02Projektion: Lineare Transformationen oder Projektionsschichten überführen die Merkmale in einen gemeinsamen oder kompatiblen Einbettungsraum.
- 03Fusion: Die aufeinander abgestimmten Merkmale werden etwa durch Aneinanderreihen oder Cross-Attention kombiniert.
- 04Modalitätenübergreifende Verarbeitung: Selbstaufmerksamkeit und Cross-Attention verfeinern die Beziehungen zwischen den Modalitäten.
- 05Dekodierung: Das Modell erzeugt aus den verarbeiteten Merkmalen eine Ausgabe, beispielsweise Text, ein Label oder ein Bild.
Drei Beispiele aus unterschiedlichen Anwendungsbereichen
In der Medizin können multimodale Systeme medizinische Bilder wie Röntgen- oder MRT-Aufnahmen mit klinischen Notizen und weiteren Patientendaten kombinieren. Ein Beispiel ist die Analyse histopathologischer Aufnahmen: Das Modell setzt sichtbare Muster in einer Gewebeprobe mit diagnostischen Textangaben in Beziehung, um Fachleute bei der Prüfung zu unterstützen. Solche Systeme sollen ergänzende Informationen verfügbar machen; daraus folgt jedoch nicht automatisch, dass sie Krankheiten früher erkennen oder Diagnosen zuverlässig stellen. Die medizinische Beurteilung bleibt eine Aufgabe für qualifiziertes Personal.
In der Industrie und Fertigung können Systeme Sensordaten als Zeitreihen, Bilder aus der Qualitätskontrolle und schriftliche Wartungsprotokolle gemeinsam auswerten. Zeigt ein Sensor beispielsweise ungewöhnliche Vibrationen und dokumentiert eine Kamera zugleich sichtbaren Verschleiß, kann ein System beide Hinweise zusammenführen und einen Prüfbedarf markieren. Das ist ein illustriertes Anwendungsszenario, kein Nachweis dafür, dass ein konkretes Modell Ausfälle zuverlässig vorhersagt oder Stillstandskosten senkt.
Bei autonomen Fahrzeugen kann die Sensorfusion Informationen von Kameras, LiDAR und Radar kombinieren. Kameras erfassen unter anderem Farbe und Textur, LiDAR liefert Distanzinformationen und Radar kann Bewegungen beziehungsweise Geschwindigkeiten erfassen. Die Sensoren ergänzen einander, haben aber jeweils eigene Grenzen. Die gemeinsame Verarbeitung kann ein umfassenderes Bild der Umgebung liefern; sie garantiert jedoch weder Sicherheit noch eine zuverlässige Erkennung in allen Situationen.
So lässt sich das Ergebnis bewerten
Die Bewertung multimodaler Systeme ist anspruchsvoller als die eines Modells, das nur eine Datenart verarbeitet. Es reicht nicht, die Leistung bei Bildverarbeitung und Sprachverarbeitung einzeln zu messen: Entscheidend ist auch, ob das System Informationen zwischen den Modalitäten korrekt verknüpft. Gute Einzelergebnisse in Computer Vision und Sprachverarbeitung garantieren nicht, dass die kombinierte Aufgabe ebenfalls gut gelöst wird. Tests sollten deshalb prüfen, ob das Modell beispielsweise Wörter den passenden Bildbereichen zuordnet und relevante Informationen nicht falsch zusammenführt.
Ebenso wichtig sind Robustheitstests für fehlende oder beeinträchtigte Eingaben. Eine Kamera kann ausfallen, Bilder können dunkel sein und Audio kann Hintergrundgeräusche enthalten. Ein robustes System sollte mit solchen Abweichungen nachvollziehbar umgehen, statt unzuverlässige Ausgaben als sicher darzustellen. Für Anwendungen mit hohen Risiken sollten zudem Unsicherheit, Fehlertypen, Eskalationsregeln und menschliche Prüfungen berücksichtigt werden. Erklärbare Ausgaben können hilfreich sein, ersetzen aber keine Leistungsprüfung und sind für sich genommen kein Beweis für Richtigkeit.
Häufige Fehler und Grenzen
Ein wichtiger praktischer Nachteil ist der zusätzliche Rechenaufwand. Besonders die Verarbeitung von Video oder Audio in Echtzeit kann erhebliche Ressourcen erfordern und den Einsatz auf Geräten mit begrenzter Rechenleistung oder bei strengen Latenzanforderungen erschweren. Auch die Ausrichtung der Daten bleibt eine Herausforderung: Sensoren können in unterschiedlichen Abständen messen, Bild- und Audiodaten müssen zeitlich zusammenpassen, und Informationen können auf verschiedene Koordinatensysteme verteilt sein. Vorverarbeitung und Synchronisation können dabei selbst Fehler verursachen.
Ein verbreiteter Irrtum ist, Redundanz mit Zuverlässigkeit gleichzusetzen. Mehrere Datenquellen können einander ergänzen, aber auch widersprüchliche, irrelevante oder fehlerhafte Hinweise liefern. Zudem kann die Verknüpfung zuvor getrennt betrachteter, scheinbar anonymisierter Daten die Wiedererkennung von Personen ermöglichen. Ein weiteres Risiko entsteht, wenn die Trainingsdaten bestimmte Modalitäten unterrepräsentieren: Das Modell kann sich dann stärker auf die dominierende Datenart stützen oder systematische Verzerrungen übernehmen. Multimodalität ist daher nicht automatisch besser; ihr Nutzen hängt von Aufgabe, Datenqualität und sorgfältiger Prüfung ab.
Herausforderungen und mögliche Maßnahmen
Eine Übersicht über technische und organisatorische Probleme. Die genannten Maßnahmen sind Ansätze, keine Garantie für deren vollständige Beseitigung.
| Herausforderung | Beschreibung | Möglicher Ansatz |
|---|---|---|
| Zeitliche Ausrichtung | Sensoren und Aufzeichnungen verwenden unterschiedliche Abtastraten oder Zeitstempel. | Zeitstempel prüfen und Daten mit geeigneten Synchronisationsverfahren abgleichen. |
| Rechenaufwand | Die Verarbeitung mehrerer Modalitäten, besonders in Echtzeit, kann hohe Ressourcen beanspruchen. | Modelle und Verarbeitungspipeline auf den konkreten Bedarf abstimmen; auch lokale Verarbeitung prüfen. |
| Datenschutz | Die Kombination verschiedener Datenarten kann Rückschlüsse auf Personen ermöglichen. | Zugriffsrechte, Zweckbindung und Datenminimierung umsetzen; Datenschutzrisiken gesondert bewerten. |
| Ungleich verteilte Trainingsdaten | Eine Modalität kann häufiger oder besser repräsentiert sein als andere. | Datenabdeckung prüfen und die Leistung nach Modalität sowie relevanten Gruppen auswerten. |
Häufige Fragen und Quellen
Ist multimodal immer besser als unimodal? Nein. Bei einer klar eingegrenzten Aufgabe, deren Informationen in einem einzigen Format vorliegen – etwa der Klassifikation von E-Mails –, kann ein Textmodell kostengünstiger und einfacher zu betreiben sein. Multimodale Verarbeitung ist dann sinnvoll, wenn wichtige Informationen auf mehrere Formate verteilt sind und ihre Verknüpfung die konkrete Aufgabe nachweisbar verbessert.
Welche Rolle spielt Cross-Attention? Sie ermöglicht es einer Modalität, gezielt Informationen aus einer anderen zu berücksichtigen. Anders als Selbstaufmerksamkeit, die Beziehungen innerhalb einer Sequenz verarbeitet, kann Cross-Attention etwa Textmerkmale mit Merkmalen von Bildbereichen verknüpfen. Das kann Aufgaben wie visuelle Fragebeantwortung oder Bildbeschreibung unterstützen, garantiert aber nicht, dass die Zuordnung korrekt ist.
Die Grunddefinition und die technischen Schritte in diesem Eintrag stützen sich auf die verfügbaren Dokumentationen zu multimodalen Sprachmodellen und multimodalen Daten. Eine allgemein gültige Kennzahl für die Qualität multimodaler Fusion lässt sich daraus nicht ableiten. Ergebnisse sind daher aufgabenspezifisch zu prüfen; Benchmarks verschiedener Modelle oder Studien sind nicht ohne Weiteres vergleichbar.