Definição numa frase
Capacidade de processar ou gerar mais de um tipo de informação, como texto, imagem, áudio ou vídeo.
Definição e conceitos que não devem ser confundidos
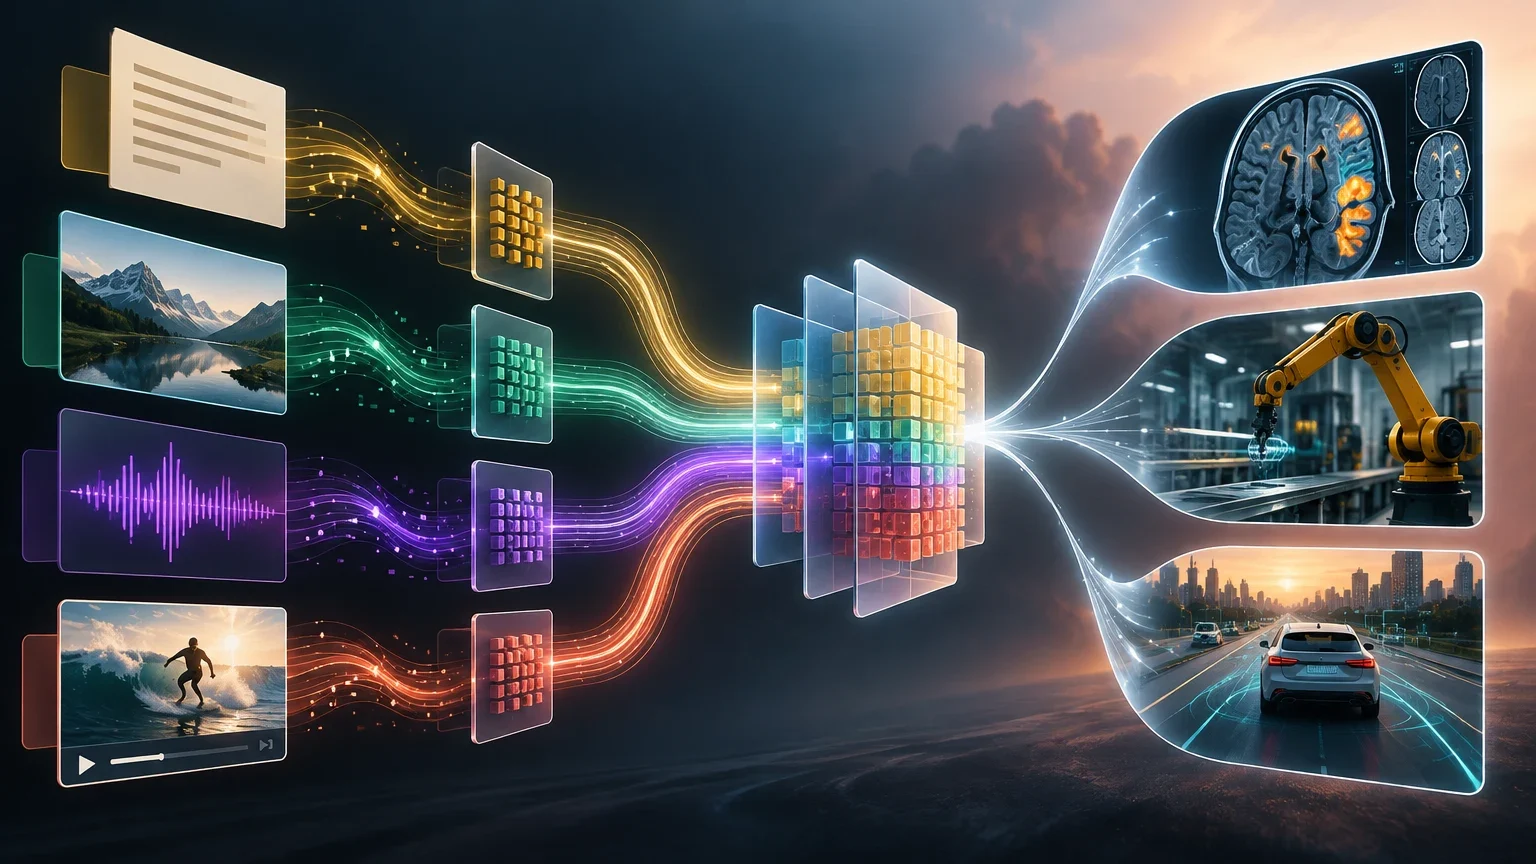
Multimodalidade é a capacidade de um sistema de inteligência artificial processar e integrar mais de um tipo de informação, ou modalidade, como texto, áudio, imagens e vídeo. Ao contrário de um sistema unimodal, que trabalha com uma única modalidade, um sistema multimodal pode relacionar informações apresentadas em formatos diferentes. Isso é útil quando o contexto de uma tarefa está distribuído entre vários tipos de dados — por exemplo, numa imagem acompanhada de uma pergunta escrita.
Multimodalidade não é sinónimo de dados não estruturados. Um vídeo sem transcrição pode ser um dado não estruturado; só passa a fazer parte de um processamento multimodal quando o sistema consegue analisá-lo e relacioná-lo com outra modalidade, como texto ou áudio. Também não basta juntar ficheiros num mesmo conjunto de dados. O desafio técnico está em identificar correspondências entre modalidades, alinhá-las e combinar as informações de modo adequado à tarefa. As modalidades podem ser complementares, mas também podem conter dados redundantes, incompletos ou contraditórios.
Sistemas unimodais e multimodais
A diferença principal está no número e na combinação das modalidades processadas.
| Característica | Unimodal | Multimodal |
|---|---|---|
| Entrada de dados | Uma modalidade, como texto | Duas ou mais modalidades, como texto e imagem |
| Estrutura | Um tipo de representação | Estruturas diferentes, como tokens, píxeis e ondas sonoras |
| Processamento | Especializado numa modalidade | Pode incluir alinhamento e interação entre modalidades |
| Complexidade | Em geral, menor | Pode exigir mais dados, processamento e validação |
Funcionamento passo a passo
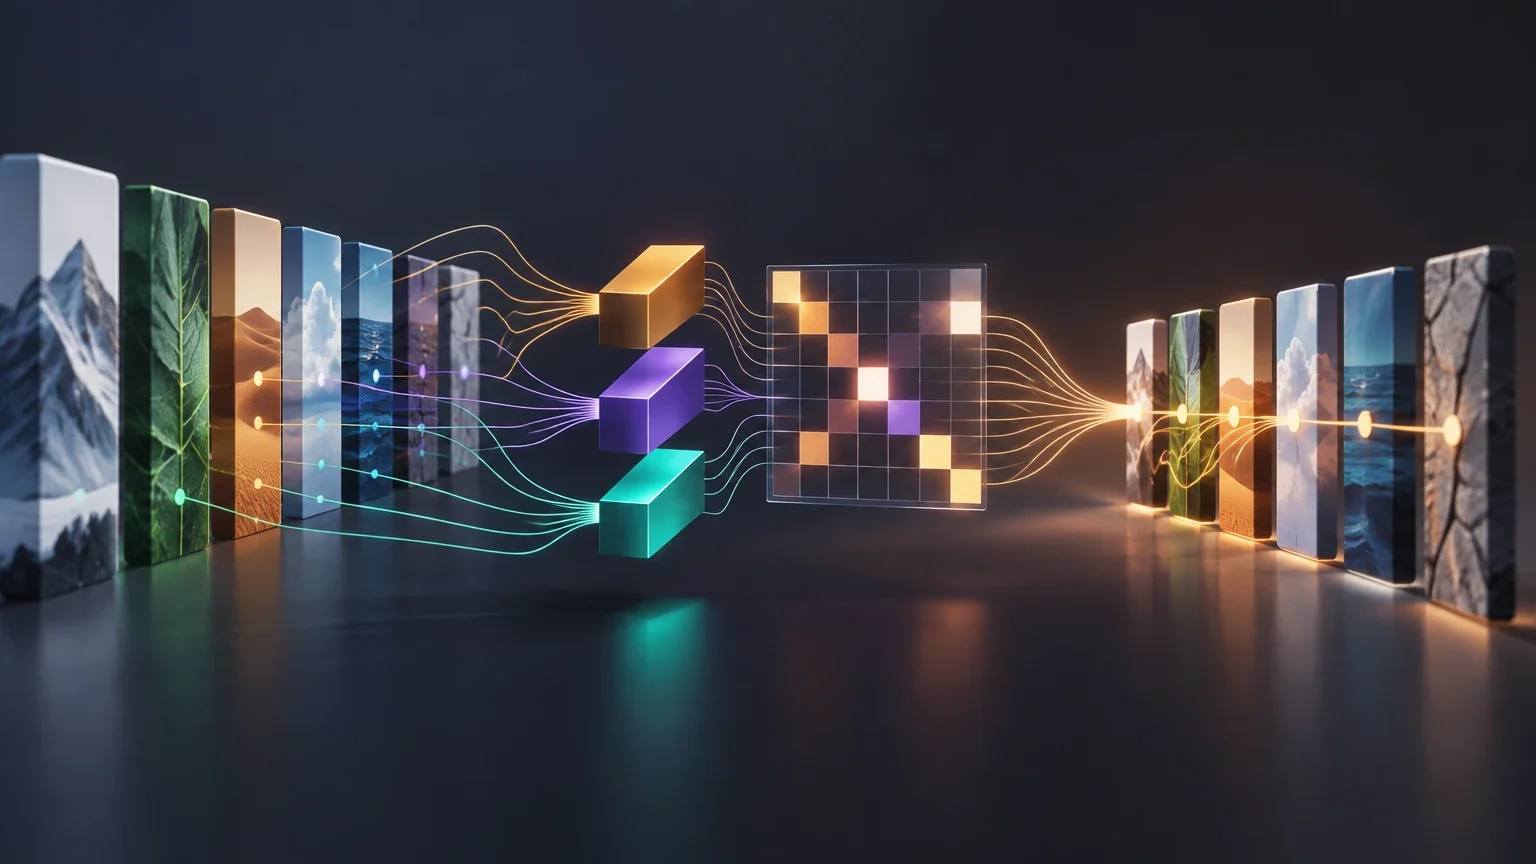
Não existe um único pipeline para todos os sistemas multimodais. A arquitetura depende das modalidades, da tarefa e do tipo de resultado pretendido. Um processo comum começa por codificar cada entrada numa representação numérica. O texto pode ser dividido em tokens; uma imagem pode ser representada por características visuais; e o áudio pode ser processado como uma forma de onda ou convertido numa representação que preserve informação relevante sobre a fala e outros sons.
As representações podem então ser projetadas para um formato compatível, combinadas e processadas para que o sistema relacione as modalidades. A fusão pode ocorrer de diferentes maneiras: os vetores podem ser concatenados, ou mecanismos como a atenção cruzada podem permitir que uma modalidade consulte partes relevantes de outra. Por fim, um descodificador produz o resultado da tarefa — por exemplo, uma resposta em texto, uma classificação ou uma ação. Nem todos os sistemas usam exatamente estas etapas ou nesta ordem.
Etapas frequentes num pipeline multimodal
Uma descrição geral do processo; a implementação concreta varia consoante o modelo e a tarefa.
- 01Codificação: converter cada entrada, como texto, imagem ou áudio, numa representação que o modelo consiga processar.
- 02Projeção: adaptar as representações para que possam ser usadas em conjunto, quando a arquitetura exige essa etapa.
- 03Fusão: combinar as informações, por concatenação ou por mecanismos aprendidos, como a atenção cruzada.
- 04Interação: processar as relações dentro de cada modalidade e entre modalidades, quando o modelo suporta essas operações.
- 05Descodificação: transformar a representação processada numa saída apropriada para a tarefa, como texto ou uma classificação.
Três exemplos desenvolvidos em áreas relevantes
Na saúde, um sistema pode relacionar imagens médicas com notas clínicas e outros dados do paciente para apoiar uma tarefa delimitada, como organizar informação ou sinalizar um caso para revisão. Num exemplo ilustrativo, o sistema analisa uma imagem de histopatologia em conjunto com uma descrição clínica fornecida por profissionais. Isso não demonstra, por si só, que o sistema detete doenças melhor do que um especialista: o desempenho precisa de ser avaliado na população, no contexto clínico e para a tarefa em que será utilizado. A decisão médica continua a exigir supervisão profissional.
Na indústria, um sistema de manutenção pode combinar leituras de sensores ao longo do tempo, imagens de inspeção e registos escritos de manutenção. Por exemplo, uma equipa poderia investigar se vibrações fora do padrão coincidem com sinais visuais de desgaste e intervenções anteriores. Essa combinação pode ajudar a priorizar uma inspeção, mas não garante que uma avaria seja prevista nem que o tempo de inatividade diminua. A qualidade dos sensores, a sincronização das medições e a validação em condições reais são determinantes.
Num veículo autónomo ou num sistema de assistência à condução, câmaras, radar e outros sensores podem fornecer informações diferentes sobre o ambiente. As câmaras registam, entre outras coisas, cor e textura; o radar pode contribuir com informação sobre distância e velocidade relativa. A fusão procura formar uma estimativa mais completa do que aquela que uma única fonte permitiria. Contudo, nenhum arranjo elimina a incerteza: condições meteorológicas, falhas, obstáculos e erros de alinhamento podem comprometer as leituras. Por isso, os exemplos de fusão não devem ser confundidos com uma garantia de segurança.
Como avaliar o resultado
A avaliação deve refletir a tarefa e as condições em que o sistema será utilizado. Além de medir o resultado final, convém comparar o sistema multimodal com alternativas relevantes, incluindo modelos unimodais e processos existentes. Se o sistema recebe texto e imagens, por exemplo, a avaliação deve verificar se a modalidade visual acrescenta informação útil, e não apenas se o modelo produz uma resposta plausível.
Também é importante testar entradas incompletas, ruidosas ou contraditórias. O desempenho pode mudar quando uma imagem está desfocada, o áudio contém ruído ou uma fonte de dados está indisponível. Em aplicações de maior risco, a equipa deve definir que casos exigem revisão humana, registar erros e verificar se os resultados se mantêm em dados representativos do uso previsto. Uma medida de desempenho isolada não estabelece, por si só, segurança ou adequação para implantação.
Erros habituais e limites
Um erro frequente é tratar a multimodalidade como uma melhoria automática. Mais entradas podem acrescentar contexto, mas também introduzir ruído, dados incompatíveis, custos de armazenamento e processamento, e novas fontes de erro. A qualidade do resultado depende da tarefa, dos dados, do modelo e da forma como as modalidades são combinadas. Um modelo competente em visão e outro competente em linguagem não será necessariamente competente na tarefa que exige a integração de ambos.
Outro desafio é o alinhamento. Uma imagem, um texto e uma medição de sensor podem descrever o mesmo evento, mas ter sido recolhidos em momentos ou escalas diferentes. Atrasos, frequências de amostragem diferentes, registos incompletos e metadados incorretos podem levar o sistema a associar informações que não correspondem. O processamento de áudio e vídeo também pode exigir sincronização temporal. Além disso, combinar dados de várias fontes pode aumentar riscos de privacidade: informações aparentemente anónimas podem tornar-se identificáveis quando relacionadas com outros dados. O custo computacional, a disponibilidade de dados equilibrados e a dependência de revisão especializada também limitam algumas aplicações.
Desafios e medidas de controlo
Os controlos dependem do contexto e não eliminam todos os riscos.
| Desafio | O que pode acontecer | Medida a considerar |
|---|---|---|
| Alinhamento | Dados de modalidades diferentes podem referir-se a momentos ou eventos distintos. | Verificar marcas temporais, correspondências e qualidade dos metadados. |
| Custo computacional | Processar imagens, áudio ou vídeo pode exigir mais recursos. | Medir latência e custo na carga de trabalho prevista; comparar com alternativas simples. |
| Privacidade | A combinação de fontes pode revelar a identidade ou informação sensível. | Limitar a recolha e o acesso; avaliar riscos de reidentificação e retenção. |
| Dados incompletos ou desequilibrados | O sistema pode depender demasiado de uma modalidade ou falhar quando uma falta. | Testar modalidades em falta e diferentes níveis de qualidade; rever os casos de falha. |
Perguntas frequentes e fontes primárias
A multimodalidade é sempre melhor do que uma abordagem unimodal? Não. Se uma tarefa depende de uma única modalidade, como classificar mensagens de texto, uma solução unimodal pode ser mais simples e suficiente. A abordagem multimodal faz sentido quando informações relevantes estão distribuídas por formatos diferentes e a sua combinação melhora de forma demonstrável o resultado, tendo em conta os custos e os riscos adicionais.
Qual é o papel da atenção cruzada? É um mecanismo que pode permitir que elementos de uma modalidade atribuam atenção a elementos de outra. Por exemplo, numa tarefa de pergunta e resposta sobre uma imagem, a representação textual pode interagir com características visuais relevantes. Nem todos os sistemas multimodais usam atenção cruzada; arquiteturas e estratégias de fusão variam conforme o modelo.
Fontes e alcance da evidência
A definição geral de aprendizagem multimodal é consistente com a investigação académica sobre a integração de diferentes tipos de dados. O trabalho de Ngiam e colaboradores, publicado em 2011, é uma referência inicial na área, mas não constitui prova de que qualquer aplicação moderna funcione de forma eficaz. Conceitos como alinhamento e fusão também são discutidos em revisões académicas sobre aprendizagem automática multimodal.
As descrições de codificação, projeção e fusão apresentadas nesta ficha são uma explicação geral de estratégias usadas em algumas arquiteturas, não uma especificação universal. As limitações e os exemplos devem ser interpretados como considerações técnicas e cenários ilustrativos, não como resultados medidos para um sistema específico. A eficácia depende da implementação, dos dados e da avaliação no contexto de uso.