Definizione in una frase
Capacità di elaborare o generare più di un tipo di informazione, come testo, immagine, audio o video.
Definizione e concetti da non confondere
La multimodalità è la capacità di un sistema di intelligenza artificiale di elaborare e integrare più tipi di dati, detti modalità, come testo, audio, immagini o video. A differenza dei modelli unimodali, che operano su un solo formato di input, i sistemi multimodali cercano di rappresentare la complessità del mondo reale, nel quale le informazioni raramente si presentano in modo isolato. Mettere in relazione modalità diverse può offrire un contesto più ricco e sostenere attività come rispondere a domande su un’immagine, recuperare contenuti attraverso modalità diverse o descrivere una scena.
Multimodalità non significa semplicemente che un insieme di dati contenga materiale non strutturato. Un video senza trascrizione, per esempio, può essere non strutturato senza che un sistema ne estragga e metta in relazione informazioni provenienti da più modalità. Il punto tecnico è proprio questo: l’allineamento individua quali parti di modalità diverse corrispondono tra loro; la fusione stabilisce come combinarle. Non basta nemmeno applicare un semplice trasferimento di apprendimento: occorrono rappresentazioni e componenti che consentano alle modalità di interagire, anche se le architetture e il grado d’integrazione variano da un sistema all’altro.
Dati unimodali e multimodali a confronto
Confronto tra caratteristiche degli input e modalità di elaborazione. La complessità e il costo effettivi dipendono dal sistema e dal compito.
| Caratteristica | Unimodale | Multimodale |
|---|---|---|
| Input | Un solo tipo, per esempio solo testo | Due o più tipi, per esempio testo e immagine |
| Struttura | Una famiglia di rappresentazioni, come sequenze o matrici | Rappresentazioni eterogenee, come token, pixel e forme d’onda |
| Elaborazione | Pipeline specializzata per una modalità | Allineamento e interazione tra modalità; la fusione può avvenire in fasi diverse |
| Complessità | In genere minori esigenze d’integrazione | Può richiedere più calcolo, memoria e gestione dei dati |
Come funziona, passo dopo passo
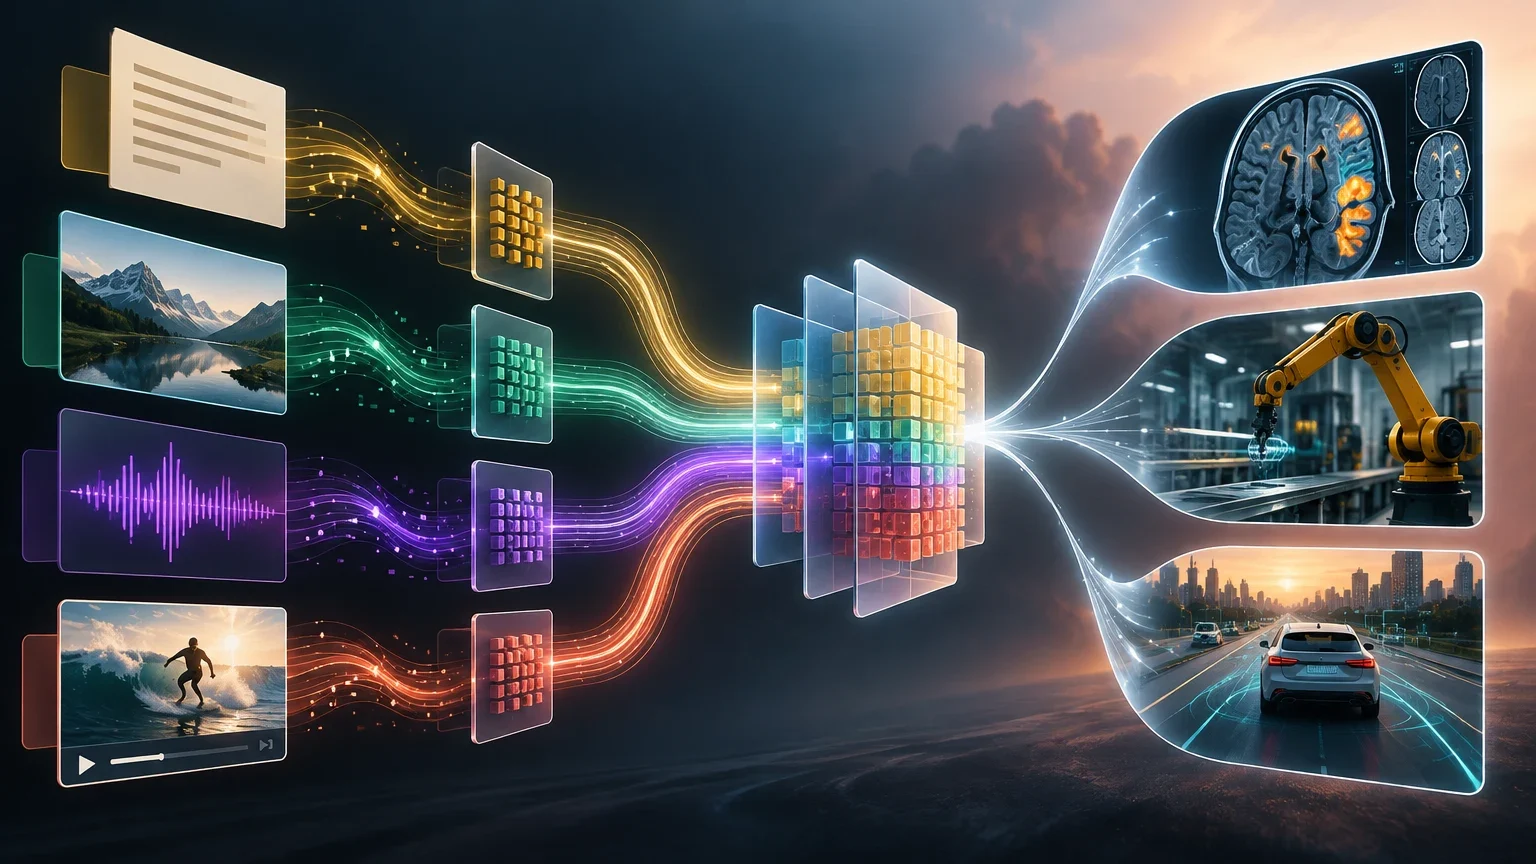
Un sistema multimodale trasforma gli input originali in rappresentazioni che il modello può confrontare e utilizzare. Una prima fase è la codifica: ogni modalità viene convertita in caratteristiche adatte alla sua struttura. Il testo può essere suddiviso in token e rappresentato con vettori; le immagini possono essere elaborate con architetture di visione, come i Vision Transformer o le reti convoluzionali; l’audio può essere trasformato in rappresentazioni che conservano informazioni utili sulla voce e sui suoni. Non tutti i modelli usano gli stessi componenti: la scelta dipende dalle modalità e dal compito.
Le caratteristiche così ottenute possono avere formati e dimensioni differenti. Una fase di proiezione, quando prevista, le porta in uno spazio di rappresentazione compatibile. Il sistema può poi fonderle, per esempio concatenando i vettori oppure usando meccanismi appresi per combinare le informazioni. Con l’attenzione incrociata, una modalità può concentrarsi sulle parti pertinenti di un’altra: per esempio, il testo di una domanda può interagire con regioni specifiche di un’immagine. Gli strati del modello elaborano le relazioni risultanti e un decodificatore produce l’output richiesto, che può essere testo, una classe o un altro tipo di risultato. Codifica, proiezione, fusione e decodifica descrivono un flusso comune, non una sequenza obbligatoria identica per ogni architettura.
Un flusso tipico di elaborazione multimodale
Le fasi possono sovrapporsi o variare a seconda dell’architettura e dell’applicazione.
- 01Codifica: trasformare testo, immagini o audio in rappresentazioni adatte alla modalità corrispondente.
- 02Proiezione: quando prevista, rendere le caratteristiche compatibili tramite trasformazioni o livelli di proiezione appresi.
- 03Fusione: combinare le rappresentazioni, per esempio mediante concatenazione o meccanismi di attenzione.
- 04Interazione tra modalità: elaborare relazioni tra elementi di input diversi; l’attenzione incrociata è una delle tecniche possibili.
- 05Decodifica: convertire le rappresentazioni elaborate nell’output richiesto, come una descrizione o una classificazione.
Tre esempi in ambiti diversi
In ambito sanitario, un sistema può mettere in relazione immagini mediche, note cliniche e informazioni strutturate del paziente. Per esempio, un modello di supporto alla revisione di immagini istopatologiche potrebbe confrontare caratteristiche visive di un campione con descrizioni diagnostiche. Questo può aiutare a organizzare o recuperare informazioni pertinenti, ma non equivale a dimostrare che il sistema diagnostichi una malattia con maggiore accuratezza né autorizza a sostituire la valutazione clinica. Per un uso concreto servono dati adeguati, validazione nella popolazione e nel contesto previsti, oltre a supervisione professionale.
In un impianto di produzione, un sistema potrebbe confrontare serie temporali di sensori, immagini di ispezione e registri di manutenzione. Un aumento delle vibrazioni, per esempio, potrebbe essere valutato insieme a immagini che mostrano usura e a segnalazioni di interventi precedenti. Il risultato potrebbe segnalare un’anomalia da verificare o aiutare a stabilire le priorità di ispezione. È un esempio illustrativo: non dimostra che la fusione riduca sempre i fermi macchina o i costi. L’utilità va verificata sul processo reale e rispetto a metodi più semplici.
Nei veicoli, diversi sensori possono fornire informazioni complementari: una telecamera registra colore e texture, mentre sistemi come radar e LiDAR possono contribuire con misure di distanza o velocità. La fusione può aiutare a valutare l’ambiente quando una singola fonte è incerta o incompleta, ma nessun sensore è infallibile e le prestazioni dipendono dalle condizioni, dalla configurazione e dall’integrazione. Perciò un sistema multimodale non garantisce da solo una guida sicura: occorrono prove specifiche, gestione dei guasti e procedure di sicurezza.
Come valutare il risultato
Valutare un sistema multimodale richiede più di una misura generale di accuratezza. Occorre verificare come funziona sulle singole modalità e se le collega correttamente nel compito previsto. Un buon risultato nell’elaborazione di immagini e un buon risultato nell’elaborazione del linguaggio, considerati separatamente, non dimostrano che il sistema sappia rispondere bene a una domanda su un’immagine. La valutazione dovrebbe quindi includere esempi in cui sia possibile controllare l’associazione tra elementi visivi e parole, e misurare il risultato rispetto a una soluzione di riferimento adeguata.
È importante anche verificare come il sistema reagisce a input mancanti, rumorosi o di qualità diversa. Una telecamera può produrre immagini scure, una registrazione audio può essere disturbata o una modalità può non essere disponibile. Si può misurare se le prestazioni peggiorano in modo prevedibile e se il sistema segnala l’incertezza invece di produrre una risposta sicura ma infondata. Nei contesti ad alto rischio, la valutazione deve includere soglie di affidabilità, revisione umana, tracciabilità e prove condotte nelle condizioni d’uso previste. Le metriche devono essere scelte in base al compito: non esiste un unico punteggio che descriva ogni aspetto della qualità multimodale.
Errori frequenti e limiti
Un errore comune è supporre che più modalità producano automaticamente risultati migliori. Gli input aggiuntivi possono essere ridondanti, rumorosi o contraddittori e rendere più difficile interpretare il risultato. L’allineamento può essere complesso: dati raccolti in momenti diversi o con frequenze differenti non corrispondono necessariamente in modo preciso. Anche la sincronizzazione temporale e l’associazione tra regioni visive, testo e segnali audio possono introdurre errori che si ripercuotono sulle fasi successive.
Un altro limite è il costo. Elaborare video, audio o flussi di sensori può richiedere più memoria e capacità di calcolo rispetto a un compito basato su un solo tipo di input; latenza e consumi dipendono dalla quantità di dati, dall’architettura e dall’hardware. Inoltre, l’idea che una modalità compensi sempre i problemi di un’altra è rischiosa: la fonte restante potrebbe essere anch’essa incompleta o fuorviante. Dati sbilanciati possono portare il sistema a fare affidamento soprattutto sulla modalità più rappresentata, mentre le differenze di qualità tra fonti possono distorcere le previsioni.
La combinazione di dati può inoltre creare rischi per la privacy. Informazioni che sembrano anonime se considerate separatamente possono diventare identificabili quando vengono collegate, a seconda dei dati e del contesto. Occorrono quindi controlli di accesso, minimizzazione dei dati e misure di protezione adeguate; non è corretto presentare una singola tecnica come soluzione universale. Anche l’equità e la robustezza vanno controllate sulle diverse modalità e sui gruppi pertinenti. L’adozione è giustificata quando il contributo misurabile delle informazioni aggiuntive supera i costi e i rischi operativi.
Sfide e possibili misure di gestione
Le misure vanno scelte in base all’applicazione, ai dati e ai requisiti di sicurezza.
| Sfida | Perché conta | Possibile misura |
|---|---|---|
| Allineamento temporale | Le modalità possono essere raccolte a frequenze o orari diversi. | Verificare timestamp e sincronizzazione; documentare i dati mancanti. |
| Costo e latenza | Video e flussi continui possono richiedere più risorse. | Misurare consumo e tempi; valutare modelli più leggeri o elaborazione locale quando appropriato. |
| Privacy | Collegare fonti diverse può aumentare il rischio di identificazione. | Limitare raccolta e accesso; applicare controlli e valutazioni di rischio pertinenti. |
| Squilibrio tra modalità | Il modello può dipendere troppo dalla fonte più disponibile o affidabile. | Valutare ogni modalità e le loro combinazioni su dati rappresentativi. |
Domande frequenti e fonti primarie
La multimodalità è sempre migliore dell’approccio unimodale? No. Se un compito è ben definito e le informazioni necessarie sono già contenute in un solo formato, un modello unimodale può essere più semplice e meno costoso da gestire. Il ricorso a più modalità ha senso quando informazioni pertinenti sono distribuite tra diversi formati e la loro combinazione migliora in modo verificabile il risultato.
Che ruolo ha l’attenzione incrociata? È una tecnica che permette a elementi di una modalità di interagire con quelli di un’altra, per esempio a una domanda testuale di concentrarsi sulle regioni pertinenti di un’immagine. Non è l’unico modo di integrare modalità diverse e non garantisce, da sola, risposte corrette. Qual è la differenza tra multimodalità e dati non strutturati? La prima riguarda l’elaborazione o la generazione di più tipi di informazione; la seconda descrive dati privi di una struttura tabellare fissa. Un sistema può contenere dati non strutturati senza metterli in relazione multimodalmente.
Le definizioni generali non implicano che ogni architettura segua lo stesso flusso. L’articolo originale di Ngiam e colleghi del 2011 è un riferimento storico sul tema dell’apprendimento da più modalità; le architetture e gli esempi sviluppati in seguito non vanno interpretati come prova di una prestazione generale. Per descrivere le fasi tecniche e i limiti dei modelli multimodali linguistici, il materiale documentale della scheda include anche la spiegazione tecnica di IBM. Le affermazioni sulla sicurezza, sulla salute e sui risultati industriali richiedono invece verifiche specifiche per ciascun impiego.
Fonti del dossier
Il dossier consultato include una panoramica tecnica IBM sui modelli linguistici multimodali e sulle fasi di codifica, proiezione, fusione e interazione tra modalità. La pagina riassume architetture e sfide: è una fonte secondaria, non una prova sperimentale originale per tutte le affermazioni descritte.
Per la prospettiva storica, la fonte primaria identificata è il lavoro di Ngiam e colleghi sull’apprendimento multimodale, pubblicato negli atti dell’International Conference on Machine Learning del 2011. La pagina enciclopedica consultata ne riporta la citazione e offre un orientamento generale, ma non sostituisce la lettura del lavoro originale. Il dossier comprende inoltre guide tecniche sui dati multimodali utili per contestualizzare la varietà dei formati e le difficoltà d’integrazione; gli esempi applicativi di questa scheda restano illustrativi e non vengono presentati come risultati misurati.