Definición en una frase
Capacidad de procesar o generar más de un tipo de información, como texto, imagen, audio o vídeo.
Definición y conceptos que no deben confundirse
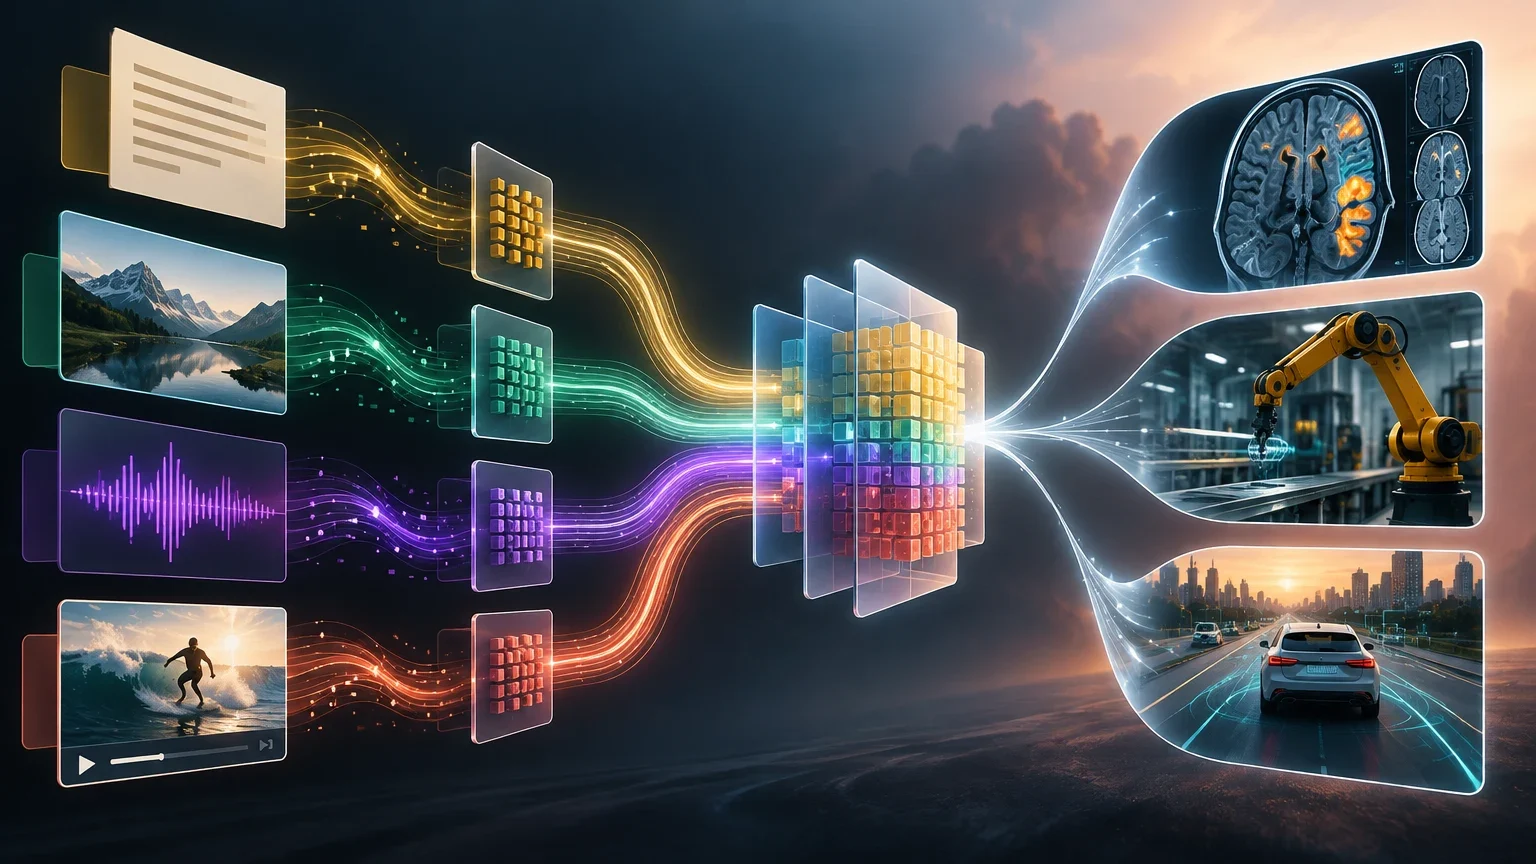
La multimodalidad se refiere a la capacidad de un sistema de inteligencia artificial para integrar y procesar múltiples tipos de datos, denominados modalidades, como texto, audio, imágenes o vídeo. A diferencia de los modelos unimodales, que operan sobre un único formato de entrada, los sistemas multimodales buscan capturar la complejidad del mundo real, donde la información rara vez se presenta de forma aislada. Esta integración permite una comprensión más holística, mejorando el rendimiento en tareas como la respuesta a preguntas visuales, la recuperación cruzada de contenido y la generación de descripciones de imágenes.
Es fundamental distinguir la multimodalidad de la mera presencia de datos no estructurados. Un conjunto de datos puede ser no estructurado (como un vídeo sin transcripción) sin ser multimodal si el sistema no está diseñado para extraer y relacionar información de diferentes fuentes simultáneamente. La clave técnica reside en la alineación y la fusión: determinar qué partes de una modalidad corresponden con otras y cómo combinar esa información para generar una representación unificada. Además, no debe confundirse con el aprendizaje por transferencia simple; la multimodalidad requiere arquitecturas específicas que permitan la interacción dinámica entre los distintos flujos de datos.
Diferencias entre datos unimodales y multimodales
Comparación técnica de las características estructurales y de procesamiento.
| Característica | Unimodal | Multimodal |
|---|---|---|
| Entrada de datos | Un solo tipo (ej. solo texto) | Dos o más tipos (ej. texto + imagen) |
| Estructura | Homogénea (secuencias o matrices) | Heterogénea (tokens, píxeles, ondas) |
| Procesamiento | Pipeline lineal específico | Fusión y alineación cruzada |
| Complejidad | Menor coste computacional | Mayor exigencia de GPU y memoria |
Funcionamiento paso a paso
El proceso técnico de un modelo multimodal sigue un pipeline estructurado que transforma entradas crudas en una representación unificada. El primer paso es la codificación de datos, donde cada modalidad se convierte en características comprensibles por la máquina. El texto se tokeniza y se incrusta mediante modelos como BERT; las imágenes se procesan con Vision Transformers (ViT) o redes convolucionales (CNN) para extraer formas y patrones espaciales; y el audio se analiza mediante arquitecturas como wav2vec para capturar señales de voz.
Una vez codificadas, las características pasan por una etapa de proyección, donde se mapean en un espacio de incrustación compartido. Esto permite que vectores de texto, imagen y audio tengan dimensiones compatibles. A continuación, se realiza la fusión de características, que puede ser simple (concatenación) o sofisticada (atención cruzada). La atención cruzada es crucial, ya que permite que una modalidad, como el texto, se enfoque selectivamente en partes relevantes de otra, como una región de una imagen. Finalmente, el modelo procesa estas características fusionadas mediante capas de transformador para generar la salida, ya sea texto, clasificación o una nueva imagen.
Pipeline de procesamiento multimodal
Secuencia técnica de transformación de datos.
- 01Codificación: Conversión de datos crudos (texto, imagen, audio) en vectores de características específicos de cada modalidad.
- 02Proyección: Mapeo de las características en un espacio de incrustación común mediante transformaciones lineales o cabezas de proyección.
- 03Fusión: Combinación de las características alineadas usando concatenación o mecanismos de atención cruzada para crear una representación unificada.
- 04Interacción cruzada: Refinamiento de las dependencias entre modalidades mediante capas de autoatención y atención cruzada en el transformador.
- 05Decodificación: Generación de la salida final (texto, etiqueta o imagen) a partir de la representación multimodal procesada.
Tres ejemplos desarrollados en ámbitos relevantes
En el ámbito de la salud, la multimodalidad permite integrar imágenes médicas (radiografías, resonancias), notas clínicas no estructuradas y datos genómicos. Un ejemplo concreto es el uso de modelos para analizar histopatología, donde el sistema combina la imagen de la biopsia con descripciones diagnósticas para asistir al patólogo. Esto permite una detección más temprana de enfermedades como el cáncer, ya que el modelo puede correlacionar patrones visuales sutiles con antecedentes clínicos que un humano podría pasar por alto en una revisión rápida.
En la industria y la fabricación, los sistemas multimodales combinan lecturas de sensores en tiempo real (series temporales), imágenes de inspección de calidad y registros de mantenimiento en texto. Esto permite predecir fallos de maquinaria antes de que ocurran. Por ejemplo, si los sensores detectan una vibración anómala y las cámaras de inspección muestran un desgaste visual incipiente, el sistema cruza ambas señales para priorizar el mantenimiento, reduciendo el tiempo de inactividad y los costes de reparación.
En los vehículos autónomos, la multimodalidad es crítica para la seguridad. El vehículo integra datos de cámaras (color y textura), LiDAR (distancia precisa) y radar (velocidad). Ninguna de estas modalidades por sí sola es suficiente: las cámaras fallan en la oscuridad, el LiDAR puede verse afectado por el clima y el radar tiene baja resolución espacial. La fusión de estos datos permite al vehículo navegar entornos complejos, predecir el comportamiento de peatones y evitar obstáculos con una fiabilidad superior a la de cualquier sensor individual.
Cómo evaluar el resultado
Evaluar un sistema multimodal es más complejo que evaluar uno unimodal, ya que no basta con medir la precisión en una sola tarea. Es necesario analizar el rendimiento de cada modalidad por separado y, crucialmente, la calidad de la interacción entre ellas. Un error común es asumir que si el modelo es bueno en visión por computadora y bueno en procesamiento de lenguaje natural, será bueno en la tarea multimodal combinada. La evaluación debe incluir métricas de alineación, verificando si el modelo asocia correctamente los elementos visuales con las palabras descriptivas.
Además, se debe evaluar la robustez ante la falta de datos. En el mundo real, una cámara puede fallar o el audio puede ser ruidoso. Un sistema multimodal robusto debe ser capaz de degradar su rendimiento de forma controlada, dependiendo de las modalidades disponibles, en lugar de colapsar. Las métricas de confianza y la capacidad de explicar por qué se tomó una decisión (explicabilidad) son también indicadores clave de la calidad del sistema, especialmente en aplicaciones de alto riesgo como la medicina o la conducción autónoma.
Errores habituales y límites
Uno de los principales límites de la multimodalidad actual es el coste computacional. Entrenar y ejecutar modelos que procesan vídeo o audio en tiempo real requiere recursos de GPU masivos y arquitecturas distribuidas. Esto limita su despliegue en dispositivos de borde o en aplicaciones que exigen baja latencia. Además, la alineación temporal y espacial sigue siendo un desafío técnico; sincronizar datos de sensores que operan a frecuencias diferentes (milisegundos vs. minutos) requiere algoritmos de preprocesamiento sofisticados que a menudo introducen errores.
Otro error habitual es la sobreconfianza en la redundancia. Aunque la multimodalidad ofrece redundancia (si falla una fuente, otra puede compensar), también introduce riesgos de sesgo y privacidad. Combinar datos anonimizados de diferentes modalidades puede permitir la reidentificación de individuos (por ejemplo, cruzar patrones de marcha en vídeo con datos de comportamiento). Finalmente, la falta de datos de entrenamiento equilibrados es un problema crítico; si una modalidad está subrepresentada en el conjunto de datos, el modelo tenderá a ignorarla o a generar predicciones sesgadas hacia la modalidad dominante.
Desafíos técnicos y mitigaciones
Resumen de los principales obstáculos en la implementación multimodal.
| Desafío | Descripción | Estrategia de mitigación |
|---|---|---|
| Alineación temporal | Diferentes frecuencias de muestreo entre sensores. | Interpolación y sincronización por marcas de tiempo. |
| Coste computacional | Alto consumo de GPU para fusión en tiempo real. | Compresión de modelos y procesamiento en el borde. |
| Privacidad | Reidentificación cruzada de datos anonimizados. | Anonimización diferencial y control de acceso granular. |
| Datos desequilibrados | Sesgo hacia la modalidad con más datos. | Aumento de datos sintéticos y ponderación de pérdida. |
Preguntas frecuentes y fuentes primarias
¿La multimodalidad es siempre mejor que la unimodal? No necesariamente. Si la tarea es estrecha y la información está contenida en un solo formato (ej. clasificar correos electrónicos), un modelo unimodal de texto será más eficiente, barato y fácil de mantener. La multimodalidad se justifica cuando el contexto está distribuido en varios formatos y la combinación de estos mejora materialmente la toma de decisiones.
¿Qué papel juega la atención cruzada? Es el mecanismo central que permite a las modalidades 'hablar' entre sí. A diferencia de la autoatención, que opera dentro de una misma secuencia, la atención cruzada permite que los tokens de texto consulten las características de la imagen para extraer información relevante, facilitando tareas como la respuesta a preguntas visuales o la generación de descripciones precisas.