Définition en une phrase
Capacité à traiter ou générer plus d'un type d'information, comme le texte, l'image, l'audio ou la vidéo.
Définition et notions à ne pas confondre
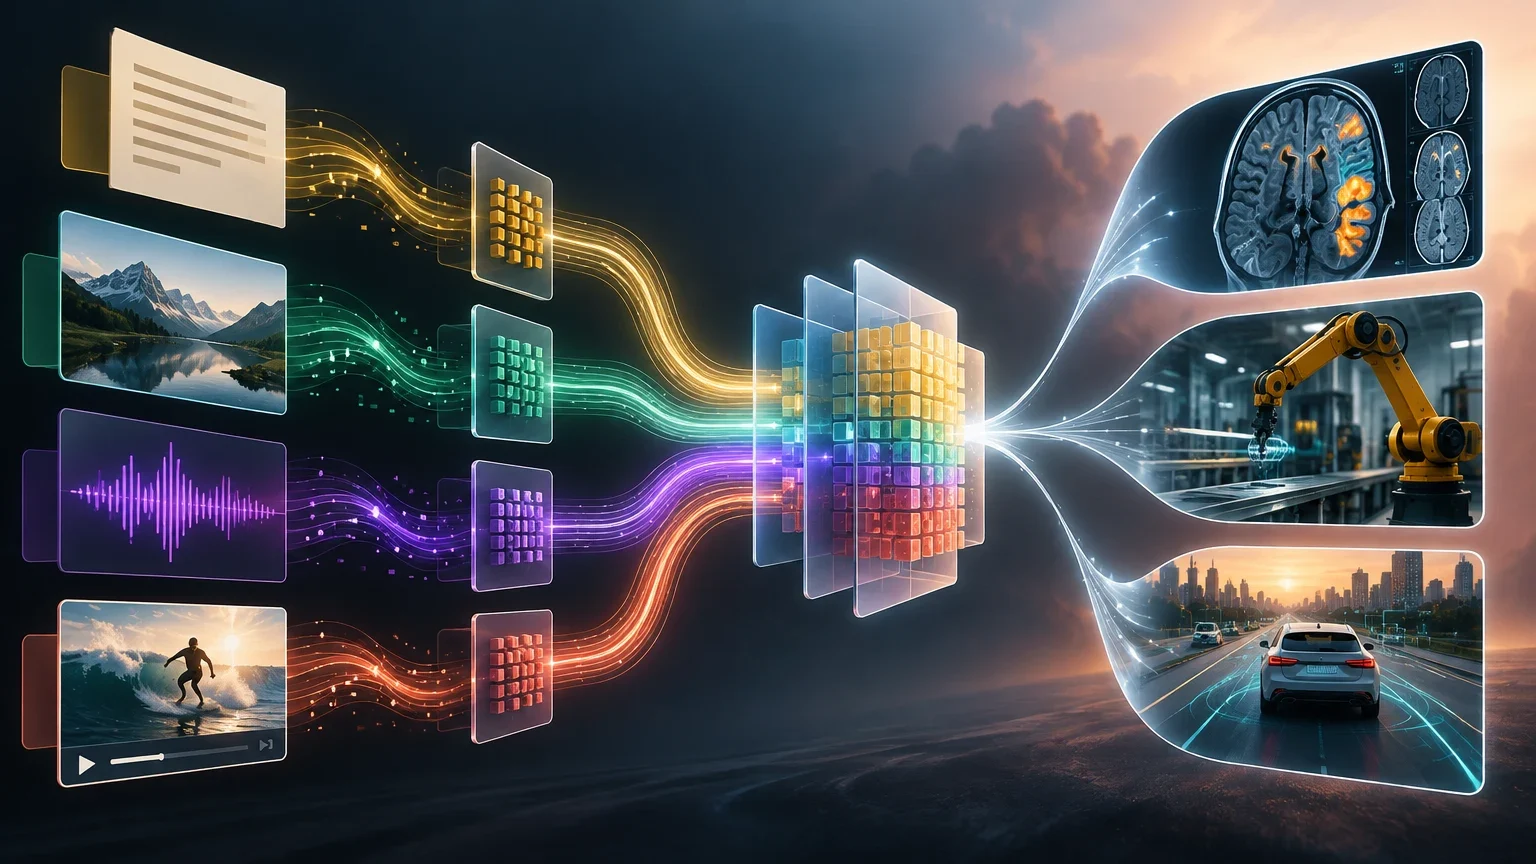
La multimodalité désigne la capacité d’un système d’intelligence artificielle à traiter et à combiner plusieurs types de données, appelés modalités : texte, audio, images ou vidéo, par exemple. À la différence d’un système unimodal, qui traite un seul type d’entrée, un système multimodal vise à exploiter des informations réparties entre plusieurs formats. Cette approche peut être utile pour des tâches comme répondre à des questions sur une image, retrouver un contenu à partir d’une description ou produire une légende.
La multimodalité ne se confond pas avec la simple présence de données non structurées. Une vidéo sans transcription peut être non structurée, mais cela ne suffit pas à rendre un système multimodal : celui-ci doit pouvoir extraire des informations de différentes modalités et les mettre en relation. Deux problèmes techniques sont centraux : l’alignement, qui consiste à déterminer quelles parties de modalités distinctes se correspondent, et la fusion, qui combine les informations pertinentes. Il ne s’agit pas non plus d’un simple transfert d’apprentissage : il faut une méthode de représentation et de traitement qui permette aux modalités d’interagir. Enfin, intégrer plusieurs sources ne garantit pas à lui seul une meilleure compréhension ou une meilleure décision.
Données unimodales et multimodales
Les différences portent sur les entrées, leur structure et la manière dont elles sont traitées.
| Caractéristique | Unimodal | Multimodal |
|---|---|---|
| Entrées | Un seul type, par exemple du texte | Au moins deux types, par exemple texte et image |
| Structure | Principalement homogène | Hétérogène : tokens, pixels, signaux audio, etc. |
| Traitement | Pipeline conçu pour une modalité | Alignement et combinaison de plusieurs modalités |
| Complexité | Souvent plus simple à mettre en œuvre | Peut nécessiter davantage de calcul et de mémoire |
Fonctionnement, étape par étape
Un système multimodal transforme généralement des données brutes en représentations exploitables, puis met ces représentations en relation pour accomplir une tâche. Les détails varient selon le modèle : toutes les architectures ne suivent pas exactement les mêmes étapes et certaines fusionnent les modalités à plusieurs moments du traitement.
Au départ, chaque type de donnée est encodé selon sa structure. Le texte peut être découpé en tokens et converti en vecteurs ; une image peut être représentée par des caractéristiques extraites de ses pixels ou de ses zones ; l’audio peut être converti en caractéristiques tirées du signal sonore. Ces encodeurs doivent préserver les informations utiles à la tâche, sans supposer que les formats différents ont déjà une représentation directement comparable.
Pipeline simplifié de traitement multimodal
Une vue d’ensemble des opérations possibles. Leur ordre et leur importance dépendent de l’architecture et de la tâche.
- 01Encodage : convertir le texte, les images ou l’audio en représentations numériques adaptées à chaque modalité.
- 02Projection : transformer ces représentations pour les rendre compatibles, par exemple en les mappant dans un espace vectoriel commun.
- 03Alignement et fusion : établir les correspondances utiles entre modalités, puis combiner leurs informations par concaténation, attention ou une autre méthode.
- 04Traitement : utiliser les couches du modèle pour exploiter les relations au sein d’une modalité et entre plusieurs modalités.
- 05Décodage : produire le résultat demandé, comme une réponse textuelle, une classe ou un autre type de sortie.
Trois exemples dans des domaines différents
En santé, un système peut rapprocher une image médicale de notes cliniques et de données structurées sur un patient. Dans une tâche de recherche en pathologie, par exemple, le modèle peut comparer une image de tissu à des descriptions ou à des termes diagnostiques. Ce type d’association peut aider à retrouver des éléments pertinents ou à organiser l’information. Ce n’est pas, à lui seul, la preuve qu’un diagnostic est exact ni qu’il améliore les résultats cliniques : toute utilisation médicale doit être évaluée dans le contexte prévu et rester soumise à une supervision appropriée.
Dans l’industrie, un système peut combiner des relevés de capteurs, des images prises lors d’une inspection et des comptes rendus de maintenance. Supposons que des capteurs signalent une vibration inhabituelle tandis qu’une image montre une usure possible : leur rapprochement peut aider à prioriser une inspection. Il s’agit d’un exemple illustratif, pas d’un résultat mesuré. La qualité du signal, la synchronisation des sources et la validation par des spécialistes restent déterminantes. Sans ces contrôles, une anomalie apparente peut être mal interprétée.
Comment évaluer le résultat
L’évaluation d’un système multimodal doit porter sur la tâche visée, sur chaque modalité et sur les relations entre elles. Une bonne performance en traitement du texte et une bonne performance en vision ne garantissent pas que le modèle saura correctement combiner texte et image. Il faut vérifier si les éléments des différentes sources sont effectivement mis en correspondance et si cette combinaison améliore le résultat par rapport à une solution plus simple.
Il est également important de tester les entrées dégradées ou manquantes. Une caméra peut fournir une image sombre, un enregistrement audio peut être bruité, et certaines données peuvent arriver avec retard. L’évaluation doit établir ce qui se passe dans ces situations : le système peut-il signaler une incertitude, fonctionner avec les modalités disponibles ou orienter le cas vers une personne ? Pour les usages à risque, il faut aussi définir des seuils de confiance, documenter les erreurs et prévoir une procédure de contrôle humain.
Erreurs fréquentes et limites
La première erreur consiste à supposer que l’ajout de modalités améliore toujours la performance. Des sources supplémentaires peuvent apporter du contexte, mais aussi des informations redondantes, de mauvaise qualité ou contradictoires. Les systèmes multimodaux doivent établir des correspondances entre des données qui peuvent différer par leur format, leur précision et leur fréquence. Par exemple, synchroniser un flux vidéo et des mesures de capteurs nécessite de tenir compte des horodatages et de la granularité des relevés ; un mauvais alignement peut conduire à rapprocher des événements qui ne correspondent pas.
Le coût de calcul et d’exploitation constitue une autre limite, surtout pour les systèmes qui traitent de la vidéo ou de l’audio en temps réel. La multimodalité soulève également des questions de confidentialité : le croisement de sources peut faciliter la réidentification d’une personne, même lorsque les données ont été anonymisées séparément. Enfin, un modèle peut accorder trop de poids à une modalité, notamment si les données d’entraînement sont déséquilibrées. Il faut donc examiner les erreurs par modalité, la qualité des données, les risques de biais et les conditions réelles de déploiement, plutôt que de se fier à une seule mesure globale.
Défis et points de vigilance
Ces mesures sont des pistes de contrôle à adapter au système et à son contexte d’utilisation.
| Défi | Pourquoi il compte | Point de vigilance |
|---|---|---|
| Alignement temporel | Les sources peuvent avoir des fréquences et des horodatages différents. | Vérifier la synchronisation et la correspondance des événements. |
| Coût de calcul | Le traitement de plusieurs formats peut demander davantage de ressources. | Mesurer latence, mémoire et coût dans les conditions de déploiement. |
| Confidentialité | Le croisement de données peut révéler des informations sur une personne. | Limiter les accès et examiner le risque de réidentification. |
| Déséquilibre entre modalités | Le modèle peut privilégier la source la plus représentée ou la plus fiable en apparence. | Évaluer les performances séparément et dans des scénarios variés. |
Questions fréquentes et sources primaires
La multimodalité est-elle toujours préférable à une approche unimodale ? Non. Si une tâche porte uniquement sur des textes, un modèle textuel peut être plus simple, moins coûteux et plus facile à évaluer. Une approche multimodale se justifie lorsque des informations pertinentes sont réparties entre plusieurs formats et que leur combinaison apporte une amélioration mesurable à la tâche.
Quel est le rôle de l’attention croisée ? Elle permet à des éléments d’une modalité de mettre en relation des éléments d’une autre. Par exemple, dans une tâche associant texte et image, le modèle peut utiliser les mots d’une question pour sélectionner les régions visuelles pertinentes. L’attention croisée est une méthode possible, mais toutes les architectures multimodales ne reposent pas sur le même mécanisme. Pour comprendre l’origine et les méthodes du domaine, il faut consulter les publications de recherche originales, plutôt que de traiter une synthèse encyclopédique comme une source primaire.