Qué hace exactamente Cosmos3-Nano-Sim-Transfer
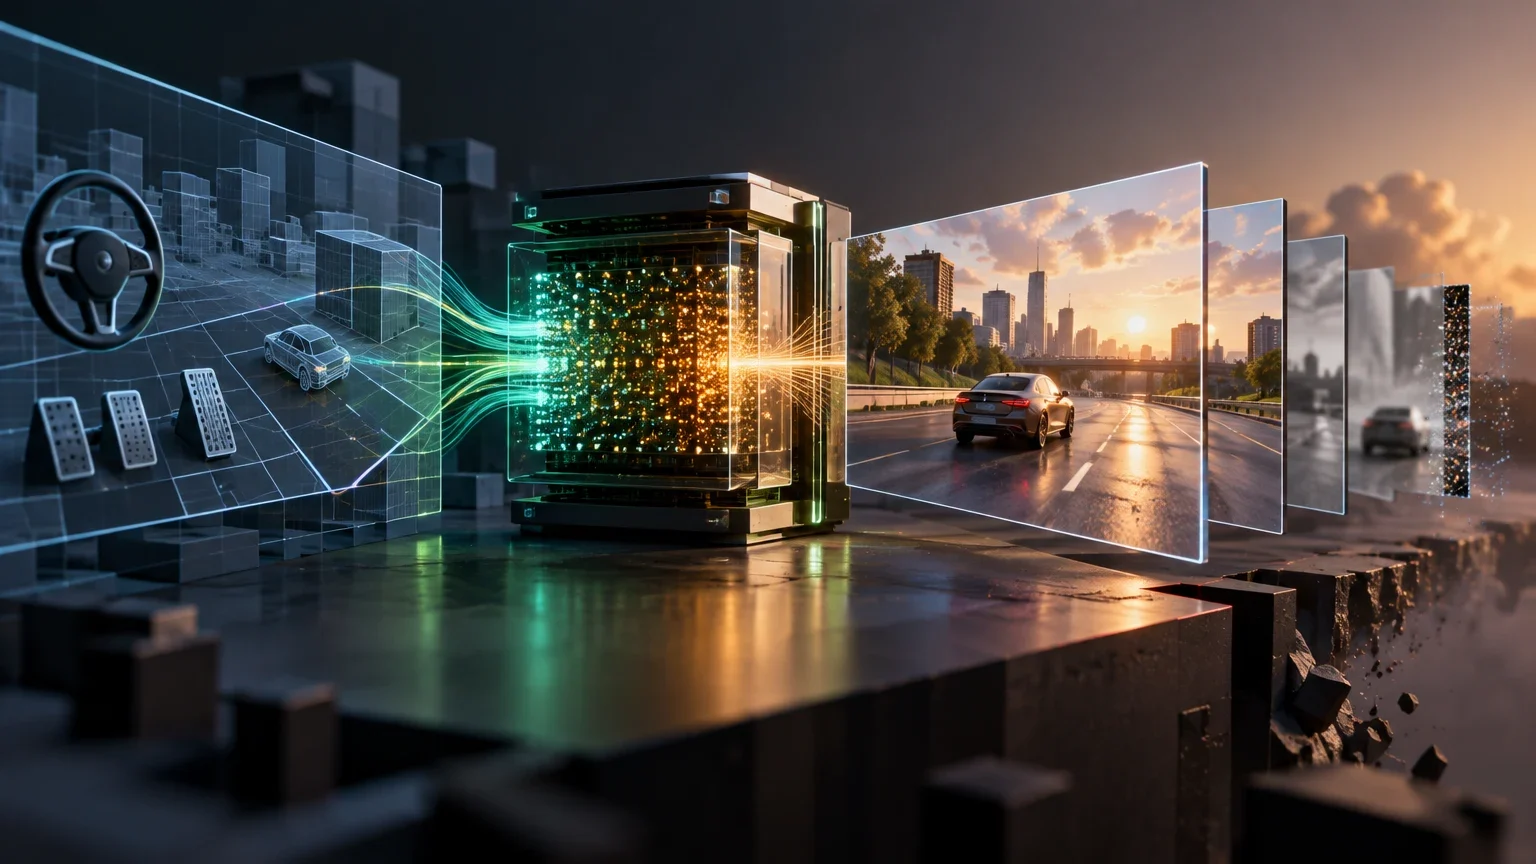
Cosmos3-Nano-Sim-Transfer es un modelo de fundación para IA física desarrollado por NVIDIA, publicado el 20 de octubre de 2026. Su función principal no es simular la física del mundo, sino generar apariencia visual (vídeo RGB) a partir de controles estructurales proporcionados por un simulador clásico. Acepta entradas de texto y controles visuales como mapas de profundidad, segmentación, bordes o desenfoque, y produce secuencias de vídeo que imitan la apariencia fotográfica de la escena simulada.
Es crucial distinguir este modelo de un motor de física: la geometría, la permanencia de objetos y las leyes físicas siguen siendo responsabilidad del simulador tradicional. La red neuronal aporta la capa visual. Por lo tanto, no es una política que genere acciones para robots ni una herramienta de certificación de seguridad, sino un generador de datos sintéticos visuales para entrenar y evaluar modelos de percepción.
La separación estricta entre la capa de simulación física y la capa de generación visual permite que los ingenieros mantengan el control determinista sobre la dinámica de los objetos. Al delegar la apariencia fotográfica a la red neuronal, se evita que la complejidad computacional de la física interfiera con la calidad estética del vídeo. Esto facilita la creación de entornos de entrenamiento donde la estructura geométrica es exacta, pero la iluminación y los texturas son variadas y realistas, lo cual es esencial para mejorar la robustez de los modelos de percepción ante condiciones visuales cambiantes.
Este enfoque híbrido resuelve una limitación histórica de los simuladores clásicos, que a menudo producen imágenes con un aspecto artificial o simplificado que no refleja la complejidad del mundo real. Al utilizar controles estructurales como la profundidad y la segmentación, el modelo asegura que la salida visual respete la posición y la forma de los objetos definidos por el simulador. De esta manera, se obtiene un conjunto de datos sintéticos que combina la precisión matemática de la simulación con la riqueza visual necesaria para entrenar algoritmos de visión por computador en escenarios de robótica e industrial.
Arquitectura y modalidades de entrada y salida
El modelo utiliza una arquitectura Transformer con Mixture-of-Transformers (MoT), una técnica que permite manejar múltiples modalidades de forma eficiente. La variante Nano cuenta con 16.000 millones de parámetros entrenables, situándose entre la versión Edge (4B) y la Super (64B) de la familia Cosmos3.
Las modalidades de entrada incluyen texto (prompts de descripción), vídeo (controles de transferencia o referencias) y parámetros de acción en ciertos modos. La salida principal es vídeo en formato MP4 con pista VP9. Para la variante Sim-Transfer, los controles típicos son mapas de profundidad, segmentación semántica, bordes y desenfoque, que guían la generación visual manteniendo la coherencia con la estructura física subyacente.
La elección de una arquitectura Mixture-of-Transformers es determinante para gestionar la complejidad de procesar simultáneamente texto, vídeo y parámetros de acción. Esta técnica permite que diferentes subconjuntos de parámetros se especialicen en modalidades específicas, optimizando así el uso de la memoria y la capacidad de cómputo. En el caso de la variante Nano, con 16.000 millones de parámetros, este diseño equilibra la capacidad de representación con la viabilidad de despliegue en hardware de alto rendimiento, evitando la sobrecarga que tendrían arquitecturas monolíticas más grandes.
La salida en formato MP4 con pista VP9 está optimizada para la compresión y la transmisión eficiente, lo que facilita la integración en pipelines de datos existentes. La disponibilidad de resoluciones desde 256p hasta 720p permite a los usuarios ajustar la calidad visual según las necesidades de su aplicación, desde prototipos rápidos con menor coste computacional hasta conjuntos de datos de alta fidelidad para entrenamiento final. La coherencia entre los controles de entrada y la salida visual se mantiene gracias a la alineación precisa de los mapas de profundidad y segmentación con los píxeles generados.
Modalidades y parámetros clave de Cosmos3-Nano
Resumen de las capacidades de entrada y salida según la documentación oficial de NVIDIA.
| Componente | Detalle |
|---|---|
| Arquitectura | Transformer MoT (Mixture-of-Transformers) |
| Parámetros | 16B (Nano) |
| Entradas | Texto, Vídeo (controles), Parámetros de acción |
| Salida | Vídeo MP4 (VP9), Imagen JPEG |
| Resoluciones | 256p, 480p, 720p (aspectos 16:9, 1:1, etc.) |
Benchmarks publicados y metodología de evaluación
NVIDIA publica resultados en el benchmark PAI-Bench-C, específicamente en la sección TransferBench. Es importante señalar que estos datos provienen del proveedor y no han sido replicados de forma independiente por Inferama ni por terceros verificados en el momento de este análisis. Las métricas incluyen DOVER (calidad técnica de vídeo), mIoU (segmentación) y SI-RMSE (error de profundidad).
Los valores publicados para este checkpoint específico son: DOVER de 10,175942, mIoU de segmentación de 0,73776 y SI-RMSE de profundidad de 0,619426. Estas métricas miden la fidelidad visual y la coherencia con los controles de entrada, pero no garantizan la precisión física de la simulación. Un alto DOVER indica un vídeo visualmente limpio, no que los objetos se muevan según las leyes de Newton.
La metodología de evaluación basada en PAI-Bench-C proporciona un marco estandarizado para comparar la calidad técnica de los vídeos generados. La métrica DOVER, que evalúa la calidad técnica, es particularmente relevante para detectar artefactos visuales o inconsistencias que podrían afectar la utilidad del dato sintético. Sin embargo, es fundamental recordar que estas métricas son indicativas de la calidad perceptual y no de la veracidad física, por lo que deben interpretarse en el contexto de su uso específico para entrenamiento de modelos de percepción.
El hecho de que los datos provengan del proveedor y no hayan sido replicados independientemente introduce una cautela necesaria en su interpretación. Los valores de mIoU y SI-RMSE ofrecen una visión cuantitativa de la precisión de la segmentación y la profundidad, respectivamente, pero no capturan por completo la complejidad de las interacciones dinámicas. Por ello, los equipos de desarrollo deben complementar estas métricas con evaluaciones cualitativas y pruebas específicas de su dominio para validar la idoneidad de los datos generados para sus aplicaciones concretas.
Métricas de TransferBench (PAI-Bench-C)
Valores publicados por NVIDIA para Cosmos3-Nano-Sim-Transfer. Menor es mejor para SI-RMSE; mayor es mejor para DOVER y mIoU.
| Métrica | Valor | Interpretación |
|---|---|---|
| DOVER | 10,175942 | Calidad técnica del vídeo generado |
| Segmentation mIoU | 0,73776 | Precisión de la segmentación semántica |
| Depth SI-RMSE | 0,619426 | Error de reconstrucción de profundidad |
Requisitos de despliegue y coste de infraestructura
El modelo se distribuye bajo la licencia OpenMDW-1.1, lo que permite su uso comercial y no comercial, siempre que se cumplan los términos de la licencia. Los pesos están disponibles públicamente en Hugging Face y el código en GitHub. Sin embargo, no existe una tarifa de API directa publicada por NVIDIA para este checkpoint específico en las fuentes primarias verificadas; el coste recae en la infraestructura propia del usuario.
Para la inferencia, se requiere hardware GPU de NVIDIA, específicamente arquitecturas Blackwell (GB200) o Hopper (H100, H200, H20). El rendimiento varía drásticamente según la resolución, el número de fotogramas y el paralelismo. Por ejemplo, generar 201 fotogramas a 480p en una sola GPU H100 puede tomar varios minutos, mientras que en configuraciones multi-GPU el tiempo se reduce significativamente. El coste debe presupuestar GPU, memoria, almacenamiento y operación, ya que los pesos gratuitos no eliminan el coste computacional.
La disponibilidad de los pesos bajo la licencia OpenMDW-1.1 democratiza el acceso a esta tecnología, permitiendo a organizaciones de diversos tamaños explorar sus capacidades sin barreras de licencia. No obstante, la ausencia de una tarifa de API directa implica que la responsabilidad de la infraestructura recae completamente en el usuario. Esto requiere una planificación cuidadosa de los recursos, incluyendo la adquisición o alquiler de GPUs NVIDIA de arquitecturas Hopper o Blackwell, así como la gestión del almacenamiento y la operación continua del sistema de inferencia.
El coste computacional es un factor crítico que debe ser presupuestado con precisión, ya que la generación de vídeo a alta resolución y con múltiples fotogramas consume una cantidad significativa de recursos. La variabilidad en el rendimiento según la configuración de paralelismo y la carga del sistema significa que los tiempos de inferencia pueden fluctuar, afectando la productividad del pipeline de datos. Por lo tanto, es esencial realizar pruebas de carga y optimización antes de escalar la generación de datos sintéticos a gran escala para asegurar la eficiencia y la rentabilidad del despliegue.
Proceso de despliegue local
Pasos básicos para ejecutar el modelo en infraestructura propia.
- 01Descargar los pesos desde Hugging Face (nvidia/Cosmos3-Nano-Sim-Transfer).
- 02Configurar un entorno con PyTorch y vLLM-Omni compatible con NVIDIA GPU.
- 03Iniciar el servidor de inferencia especificando la clase de pipeline adecuada.
- 04Enviar peticiones con controles de simulación (profundidad, segmentación) y prompts de texto.
- 05Decodificar la respuesta base64 en un archivo MP4 para su uso posterior.
Limitaciones, seguridad y alternativas
La principal limitación es la falta de precisión física garantizada. La generación puede presentar inconsistencias temporales, movimiento inestable o interacciones físicas imprecisas. NVIDIA advierte explícitamente que el modelo no está diseñado para aplicaciones críticas de seguridad donde el fallo podría causar lesiones o daños catastróficos. Requiere validación independiente y análisis de seguridad a nivel de sistema.
En cuanto a seguridad, las entradas de medios son sometidas a un cribado obligatorio de material de abuso sexual infantil (CSAM) y otras salvaguardas de contenido. Las salidas visuales llevan una marca de agua SynthID, aunque los arrays de acción numéricos no están marcados visualmente. Como alternativa, la variante Cosmos3-Nano-Transfer-Auto se especializa en conducción autónoma con LiDAR, mientras que Sim-Transfer se centra en simulación general de robótica e industrial.
La falta de precisión física garantizada es una limitación inherente a la naturaleza generativa del modelo, que prioriza la apariencia visual sobre la exactitud dinámica. Las inconsistencias temporales y el movimiento inestable pueden surgir en escenas complejas, lo que subraya la necesidad de una validación independiente y un análisis de seguridad a nivel de sistema. NVIDIA enfatiza que el modelo no está diseñado para aplicaciones críticas donde el fallo podría tener consecuencias graves, por lo que su uso debe estar siempre supervisado y complementado con simuladores físicos clásicos.
Las salvaguardas de seguridad, como el cribado de contenido y la marca de agua SynthID, son medidas importantes para garantizar el uso responsable del modelo. Sin embargo, la ausencia de marca en los arrays de acción numéricos requiere una atención especial en la trazabilidad de los datos. La existencia de variantes especializadas, como Transfer-Auto para conducción autónoma, ofrece alternativas más adecuadas para dominos específicos, mientras que Sim-Transfer se mantiene como una herramienta generalista para simulación de robótica e industrial, siempre con la cautela de validar los resultados antes de su implementación en sistemas reales.
Criterios prácticos para la elección del modelo
La decisión de usar Cosmos3-Nano-Sim-Transfer depende de si se necesita generar datos sintéticos visuales a gran escala para entrenar modelos de percepción, y si se dispone de la infraestructura GPU necesaria. Si el objetivo es simular física precisa para control en tiempo real, este modelo no es adecuado; debe usarse como complemento visual a un simulador físico clásico.
Para equipos con recursos limitados, la variante Edge (4B) podría ser más viable, aunque con menor calidad. Para aplicaciones de conducción autónoma con sensores LiDAR, la variante Transfer-Auto es más específica. La elección debe basarse en el balance entre calidad visual, coste computacional y la necesidad de coherencia física, siempre manteniendo la validación humana y técnica de los resultados.
La elección de Cosmos3-Nano-Sim-Transfer debe estar alineada con los objetivos específicos del proyecto y los recursos disponibles. Para equipos que buscan generar grandes volúmenes de datos sintéticos para entrenar modelos de percepción, este modelo ofrece una solución potente y flexible. Sin embargo, para aplicaciones que requieren simulación física precisa en tiempo real, su uso como complemento visual a un simulador clásico es la estrategia más adecuada, asegurando así la integridad de la dinámica de los objetos.
El balance entre la calidad visual, el coste computacional y la necesidad de coherencia física es el criterio fundamental para la toma de decisiones. La variante Edge puede ser una opción viable para equipos con recursos limitados, aunque con una reducción en la calidad de la salida. La validación humana y técnica de los resultados es un paso indispensable, independientemente de la variante elegida, para garantizar que los datos generados cumplan con los estándares de calidad y seguridad requeridos para su aplicación en robótica, industrial o conducción autónoma.
Tabla de decisión: ¿Cuándo usar Sim-Transfer?
Guía rápida para determinar la idoneidad del modelo según el caso de uso.
| Caso de uso | Idoneidad | Motivo |
|---|---|---|
| Generar datos sintéticos para entrenar visión por computador | Alta | Genera vídeo RGB realista a partir de controles estructurales. |
| Simulación física precisa para control de robots | Baja | No es un motor de física; la precisión física no está garantizada. |
| Conducción autónoma con LiDAR | Media/Baja | Usar Transfer-Auto para LiDAR; Sim-Transfer es más generalista. |
| Despliegue en CPU o GPU de bajo coste | Baja | Requiere GPU NVIDIA de alto rendimiento (Hopper/Blackwell). |
Qué sigue abierto
- No se ha verificado una tarifa de API directa de NVIDIA para este checkpoint específico; los costes son de infraestructura propia.
- Los benchmarks de PAI-Bench-C son del proveedor y no han sido replicados de forma independiente.
- El rendimiento exacto en hardware específico no proporcionado por el usuario puede variar según la configuración de paralelismo y la carga del sistema.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección