Laboratorio
Entidad que desarrolla o publica el modelo y mantiene su documentación técnica y de seguridad.
Consulta los modelos documentados, las evaluaciones publicadas y las fuentes primarias asociadas a esta organización.
Modelo Flash para ingeniería de software de larga duración, agentes autónomos y flujos empresariales complejos.
16 SEP. 2026↗ RAZONAMIENTO MULTIMODALRazonamiento multimodal, código y problemas complejos.
16 SEP. 2026↗ FLASH ANTERIOR · AGENTESGeneración Flash anterior para código complejo, agentes y ejecución multietapa; útil como punto de comparación con Gemini 3.8.
18 SEP. 2026↗ IMAGEN NATIVA EFICIENTEModelo de imagen de producción que combina generación, edición y razonamiento visual con equilibrio entre calidad, coste y latencia.
07 OCT. 2026↗ VÍDEO CINEMATOGRÁFICO CON AUDIOModelo de vídeo cinematográfico con audio nativo, extensión de escenas y control mediante fotogramas e imágenes de referencia.
18 SEP. 2026↗ GENERACIÓN MUSICALModelo de música para canciones completas con voz, letra y control de estructura, estilo, duración e instrumentación.
18 SEP. 2026↗ EMBEDDING MULTIMODAL UNIFICADOModelo estable de embeddings multimodales disponible desde el 22 de abril de 2026. Sitúa texto, imágenes, vídeo, audio y PDF en un espacio vectorial común para búsqueda y RAG. Desde el 6 de noviembre, el identificador anterior gemini-embedding-2-preview redirige a gemini-embedding-2.
07 NOV. 2026↗ RAZONAMIENTO ESPACIAL INCORPORADOModelo especializado en comprensión física, vídeo, razonamiento espacial y orquestación de herramientas para sistemas robóticos.
18 SEP. 2026↗ CÓDIGO Y EJECUCIÓN DE AGENTESModelo multimodal estable de Google disponible desde el 12 de noviembre para programación cotidiana, depuración y agentes con herramientas. Acepta texto, imágenes, audio, vídeo y PDF y genera texto; no es un generador de imágenes ni de voz.
13 NOV. 2026↗ CLASIFICACIÓN Y PROBABILIDADESModelo especializado de Google para decisiones binarias, selección entre opciones y puntuaciones mediante rúbricas. Evalúa texto, imágenes, audio, vídeo y PDF y devuelve probabilidades y confianza, sin generar explicaciones de texto.
12 NOV. 2026↗ RAZONAMIENTO MULTIMODAL Y PROGRAMACIÓNModelo de razonamiento multimodal de Google disponible de forma general desde el 10 de noviembre. Procesa texto, imágenes, vídeo, audio y PDF y produce texto para programación, análisis y tareas de varias etapas.
11 NOV. 2026↗ GENERACIÓN Y EDICIÓN DE VÍDEOModelo disponible de forma general desde el 5 de noviembre para generar, editar y extender vídeo con audio sincronizado. Interactions API admite texto, imágenes y vídeo, con salida de vídeo y texto. La ficha del modelo describe entradas de audio, pero los contratos API consultados no documentan audio independiente como entrada.
06 NOV. 2026↗ SIMULACIÓN INTERACTIVA DE MUNDOSModelo de mundo que genera escenas explorables con vídeo y audio nativos. Admite indicaciones de texto, referencias visuales y navegación interactiva. Google inició el acceso de investigación para probadores autorizados el 27 de octubre.
29 OCT. 2026↗ RAZONAMIENTO MULTIMODAL Y AGENTES COMPLEJOSModelo de Google disponible de forma general desde el 13 de octubre de 2026. Acepta texto, imágenes, audio y vídeo y genera texto, incluido código; no genera imágenes, audio ni vídeo. Utiliza una arquitectura MoE y una ventana compartida de 1.048.576 tokens. Las aplicaciones a robótica emplean este mismo modelo, no un endpoint independiente.
14 OCT. 2026↗ GENERACIÓN Y EDICIÓN DE IMÁGENESModelo de Google para generación de imágenes y edición conversacional, disponible de forma general desde el 6 de octubre de 2026. Sustituye a Nano Banana 2, sin confundirlo con Nano Banana Pro. Acepta texto, imágenes, vídeo y PDF como contexto; produce imágenes y texto, no vídeo ni audio. Google anuncia mejoras visuales, de seguimiento de instrucciones, texto y consistencia entre ediciones.
07 OCT. 2026↗ CONVERSACIÓN MULTIMODAL EN TIEMPO REALModelo de conversación en directo que integra voz, vídeo y herramientas con baja latencia.
29 SEP. 2026↗ VOZ EN DIRECTO CON RAZONAMIENTO PROLONGADOVariante de voz en directo con razonamiento en segundo plano para tareas complejas de varios pasos.
29 SEP. 2026↗Las cifras se muestran con el contexto comunicado por su fuente. Un resultado del proveedor no equivale a una comparación independiente ni sustituye una evaluación propia.
Una organización, un producto y un modelo no son la misma unidad. Inferama los separa para evitar atribuir capacidades o condiciones comerciales al elemento equivocado.
Entidad que desarrolla o publica el modelo y mantiene su documentación técnica y de seguridad.
Versión identificable con límites, modalidades y comportamiento que pueden cambiar entre lanzamientos.
API, aplicación, nube asociada o plan comercial; cada canal puede tener precios, retención y límites distintos.
Cada afirmación debe conservar la página oficial consultada y la fecha de verificación.
Gemini 4 Hydrogen se presentó el 12 de noviembre de 2026 para programación cotidiana y flujos de trabajo con agentes. Google anuncia su despliegue global, una ventana unificada de un millón de tokens y tarifas estándar de API de 1,50 dólares por millón de tokens de entrada y 7,50 por millón de salida.
14 nov. 2026 ↗
Análisis operativo para arquitectos de software que integran agentes de IA. Define los criterios técnicos para elegir entre el modelo de texto estándar (Gemini 3.8 Flash) y la variante de interacción en vivo (Gemini 3.8 Live) según latencia, coste, estado de la conversación y requisitos de infraestructura.
07 nov. 2026 ↗
Google describe Gemini 3.8 Live Extended Thinking como un modelo de audio a audio para Live API, recomendado cuando se necesita más razonamiento de fondo. Esa descripción no demuestra por sí sola una reducción de errores o una mejora de latencia: ambas requieren pruebas con tareas y condiciones controladas.
02 oct. 2026 ↗
Google describe Gemini 3.8 Live como un modelo para el diálogo en tiempo real. La tarifa, los resultados cuantitativos y las condiciones completas de acceso siguen sin confirmarse. Antes de integrarlo, cada equipo debe comprobar su funcionamiento en su propio entorno.
02 oct. 2026 ↗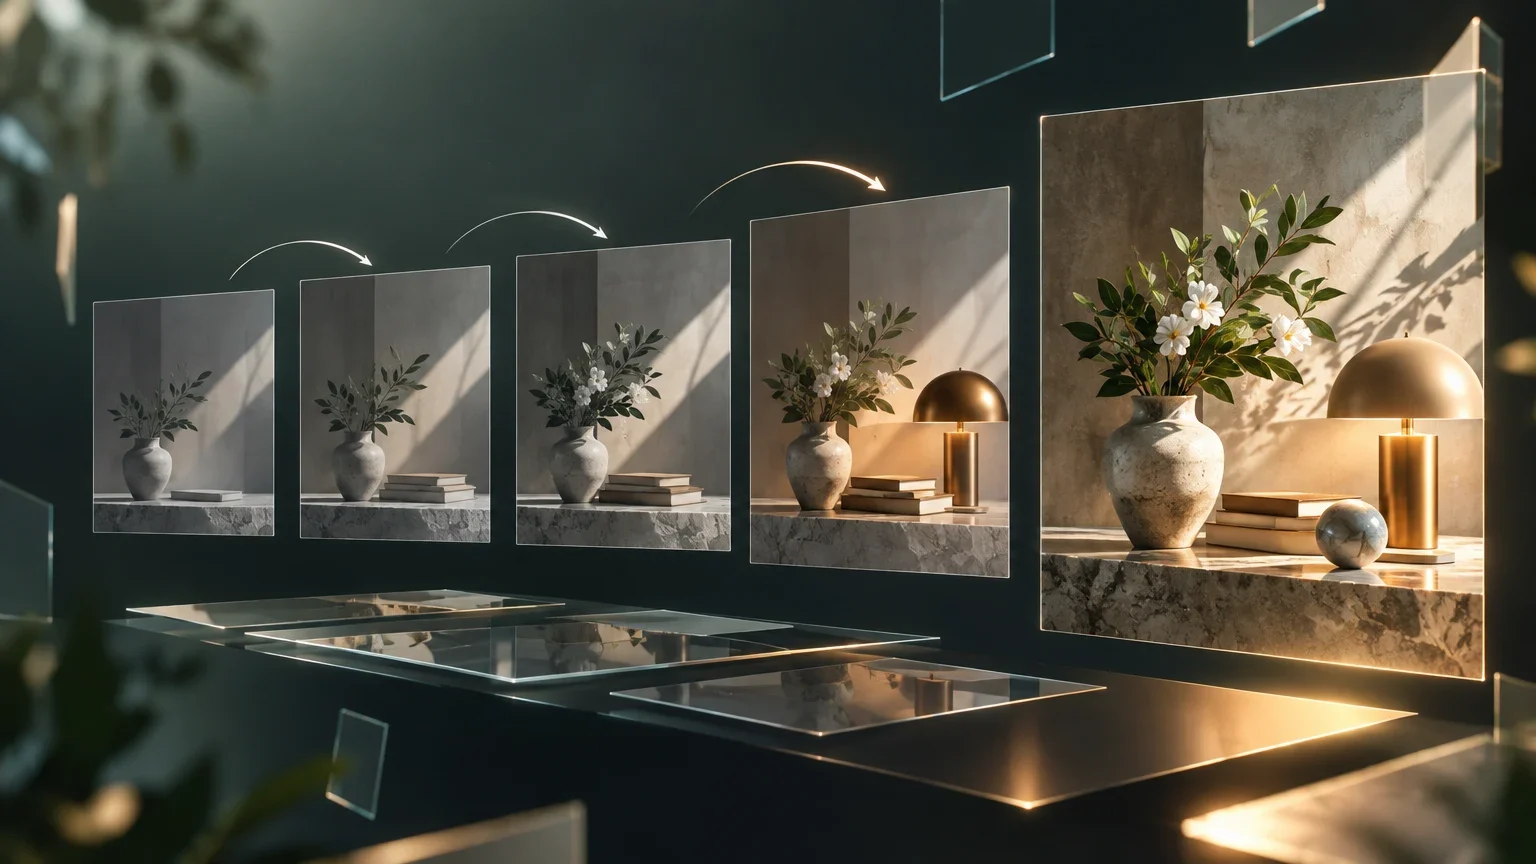
Un protocolo propuesto para medir si Nano Banana 2 aplica cambios sucesivos y conserva los elementos que las instrucciones no piden modificar. No presenta resultados experimentales: define qué habría que ejecutar y documentar para obtenerlos.
01 oct. 2026 ↗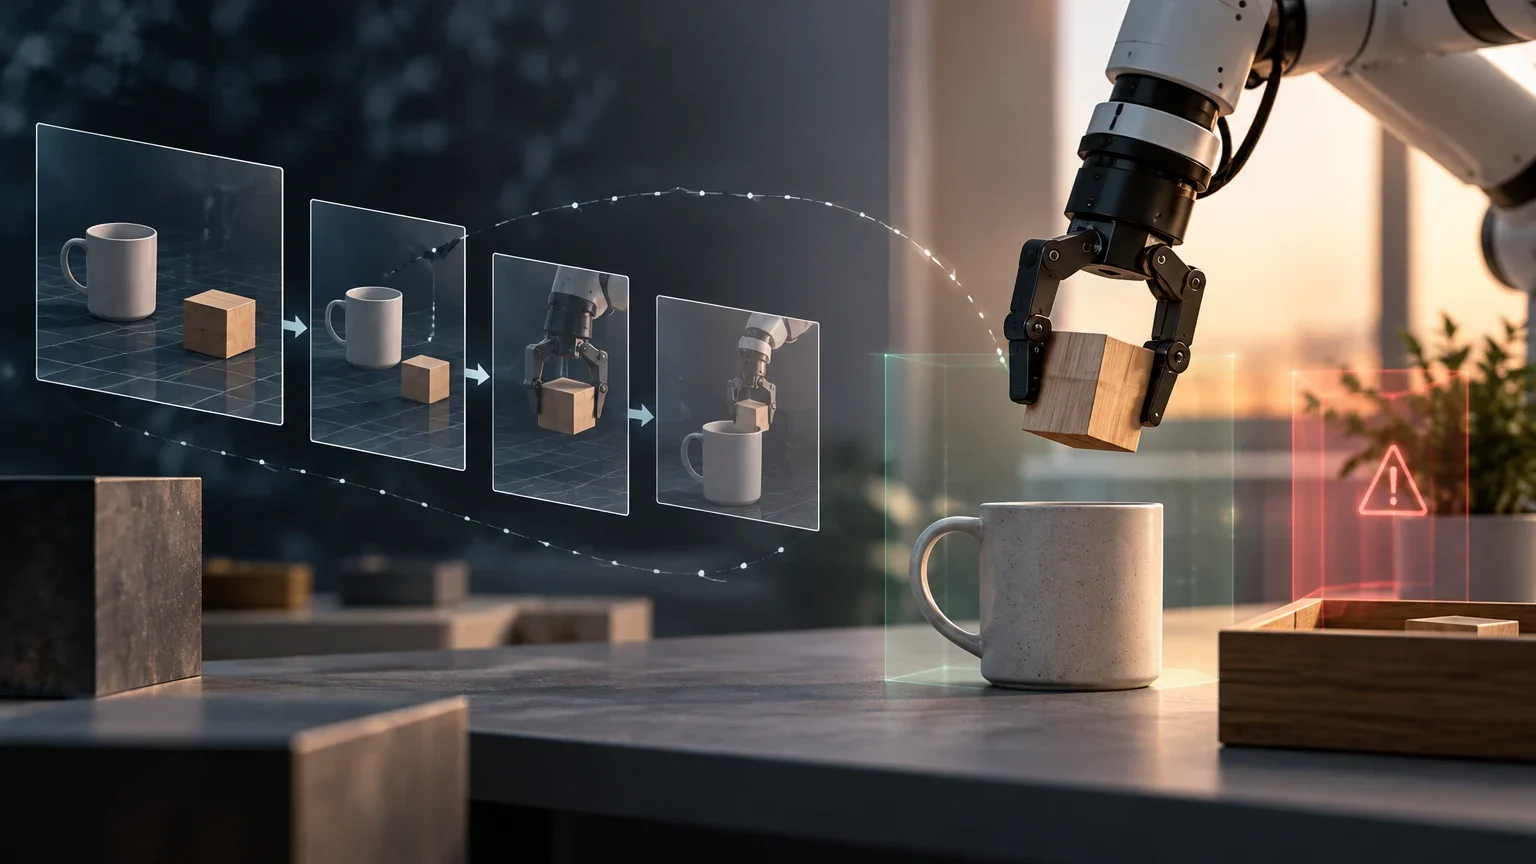
Gemini Robotics ER 2 se presenta como un modelo de visión y lenguaje capaz de planificar tareas de varios pasos para robótica. Eso no demuestra que controle directamente un robot ni que sus planes sean seguros o fiables en cualquier entorno. Analizamos qué respalda la documentación disponible y qué debe probar cada equipo.
30 sep. 2026 ↗